Comment créer un LLM personnalisé pour votre entreprise
Découvrez comment créer un LLM personnalisé pour votre entreprise grâce à une approche étape par étape couvrant la préparation des données, le choix du modèle de base, le réglage fin (fine-tuning), le RAG, l'infrastructure, le déploiement, la sécurité, les coûts et les cas d'usage en entreprise.


 ChatGPT
 Perplexity
Créer un LLM personnalisé pour votre entreprise implique d’identifier des cas d’usage précis, de préparer les données pertinentes, de choisir la bonne architecture de modèle et de mettre en place des processus d’entraînement et de test efficaces. Un LLM sur mesure peut améliorer l’automatisation, l’efficacité, l’expérience client et la prise de décision dans l’ensemble des opérations de l’entreprise.
Qu’est-ce qu’un grand modèle de langage (LLM) personnalisé et pourquoi les entreprises en ont-elles besoin ?
Les modèles d’intelligence artificielle de base standard répondent à des requêtes publiques très générales. Ces modèles génériques manquent de contexte opérationnel spécifique. Les organisations se heurtent à des écarts de précision. Les systèmes génériques inventent des faits sur l’entreprise. Les sociétés ont besoin de connaissances métier spécialisées. Le développement de LLM personnalisé comble précisément cette lacune. Les données propriétaires restent en interne. Les protocoles de sécurité limitent les fuites de données vers l’extérieur. Les organisations construisent un LLM d’entreprise pour traiter des documents sensibles.
Les services de développement d’IA sur mesure ciblent des flux de travail précis. Les employés téléversent des manuels techniques internes. Le système assimile instantanément la terminologie propriétaire. Le développement de grands modèles de langage implique un réglage intensif des paramètres. Les entreprises passent des outils publics à une infrastructure sécurisée. Les déploiements de LLM privés garantissent l’isolation des données. Les institutions financières traitent leurs dossiers confidentiels en toute sécurité. Les prestataires de santé protègent scrupuleusement les dossiers des patients.
Les modèles standard échouent sur les requêtes techniques. Le développement de GPT personnalisé répond aux secteurs de niche. Les organisations utilisent le développement de modèles d’IA pour automatiser des tâches de rédaction complexes. Les modèles d’IA d’entreprise comprennent les indicateurs internes. Les sociétés adoptent des solutions LLM open source pour conserver la propriété du code. Cette approche élimine les frais d’abonnement de tiers. Les poids propriétaires restent sur des serveurs locaux. Un contrôle opérationnel élevé renforce l’autonomie des équipes d’ingénierie internes. L’infrastructure d’IA exige de puissants clusters de calcul. Les ingénieurs configurent des nœuds de traitement distribués.
Principaux avantages de la création d’un LLM personnalisé pour les applications métier en entreprise
Créer un grand modèle de langage (LLM) personnalisé permet aux organisations de préserver la sécurité de leurs données propriétaires, de réduire considérablement les hallucinations grâce à un fine-tuning spécifique au domaine et d’automatiser sans effort des flux de travail internes complexes.
Voyons pourquoi l’adaptation d’un modèle d’IA aux données de votre organisation offre une efficacité opérationnelle inégalée et un véritable avantage concurrentiel dans les environnements d’entreprise modernes.
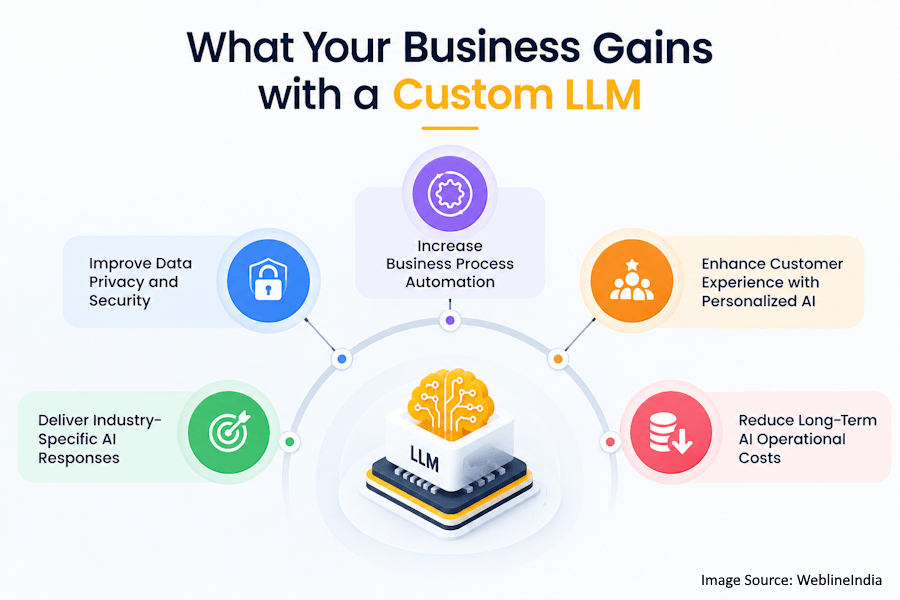
Améliorer la confidentialité et la sécurité des données
Les plateformes d’intelligence artificielle publiques conservent les données saisies par les utilisateurs. Des serveurs externes ingèrent les secrets de l’entreprise. Les sociétés s’exposent à de lourdes sanctions réglementaires. Les services de développement de modèles d’IA personnalisés éliminent les risques liés au cloud public. Les données restent dans des centres de données locaux. Les équipes de sécurité chiffrent les informations au repos. Les employés partagent des rapports confidentiels en toute sécurité. Les responsables de la conformité appliquent des contrôles d’accès stricts. Le développement de LLM privé protège la propriété intellectuelle.
- Les serveurs de l’entreprise stockent localement les journaux de requêtes.
- Les fournisseurs d’API externes ne voient jamais les données internes.
- Les ingénieurs sécurité configurent des règles de pare-feu strictes.
Fournir des réponses d’IA spécifiques à chaque secteur
Les modèles génériques comprennent mal le jargon technique. Les domaines spécialisés exigent un vocabulaire précis. Les services de développement de LLM personnalisé entraînent les modèles sur des jeux de données de niche. Les ingénieurs appliquent le fine-tuning d’un LLM pour gagner en précision métier. Les cabinets juridiques téléversent leurs archives de jurisprudence. Les chercheurs médicaux traitent des notes d’essais cliniques. Le système produit la terminologie correcte.
- Les bases de données juridiques alimentent des pipelines d’entraînement spécialisés avec des documents historiques.
- Les revues médicales améliorent la précision des requêtes cliniques pour les diagnostics hospitaliers.
- Les équipes d’ingénierie intègrent des plans techniques pour guider les moteurs de raisonnement technique.
Renforcer l’automatisation des processus métier
Le tri manuel des documents consomme des heures de travail humain. Les LLM peuvent aussi compléter les services d’automatisation des processus métier en prenant en charge des flux de travail tels que le traitement de documents, l’acheminement des tickets et l’extraction d’informations. Les systèmes acheminent instantanément les tickets de support entrants. Les services de développement d’IA pour l’entreprise peuvent prendre en charge des architectures conçues pour garder les données métier sensibles dans des environnements contrôlés. Les algorithmes extraient des données de factures non structurées. Les modèles d’IA d’entreprise exécutent une logique métier en plusieurs étapes.
- Le traitement automatisé des factures fait gagner aux services comptables des centaines d’heures de travail manuel chaque mois.
- Les chatbots de support résolvent instantanément les tickets techniques en s’appuyant sur les wikis de dépannage internes.
- Les systèmes logistiques analysent automatiquement les manifestes d’expédition pour mettre à jour les bases de données d’inventaire.
- Les erreurs de saisie de données diminuent nettement dans tous les services de l’entreprise.
Améliorer l’expérience client grâce à une IA personnalisée
Les réponses génériques frustrent les acheteurs. Les acheteurs attendent une assistance contextualisée. Le développement de modèles d’IA métier intègre les bases de données d’historique client. La plateforme se souvient des achats passés. Les agents du support résolvent les problèmes plus rapidement. La fidélité à la marque progresse régulièrement.
- Les moteurs de recommandation analysent le comportement d’achat passé pour suggérer des articles pertinents.
- Les chatbots tiennent compte de la formule d’abonnement de chaque client pour offrir une assistance précise sur son compte.
Réduire les coûts d’exploitation de l’IA à long terme
Les jetons d’API externes engendrent des frais élevés. Un trafic d’entreprise important fait grimper les factures mensuelles. Les sociétés entraînent leur propre modèle de langage pour éviter la facturation par jeton. Des coûts matériels fixes remplacent la facturation variable des API. Les organisations gèrent leurs budgets de manière prévisible.
- Des coûts d’infrastructure fixes remplacent les factures d’API qui augmentent lors des pics de trafic.
- Les volumes de requêtes élevés reviennent moins cher sur des GPU d’entreprise locaux à long terme.
- Les équipes internes optimisent la vitesse d’inférence de manière autonome, sans les limites d’une plateforme tierce.
- L’allocation des ressources s’ajuste efficacement aux pics de demande de l’entreprise.
Transformez les données de votre entreprise en une solution d’IA sécurisée et spécifique à votre domaine, conçue autour de vos flux de travail, de vos utilisateurs et de vos exigences d’entreprise.
LLM personnalisé ou LLM pré-entraîné : quel modèle d’IA convient le mieux à votre entreprise ?
Les modèles pré-entraînés offrent des capacités immédiates et économiques pour les tâches générales, tandis que les modèles personnalisés apportent une sécurité et une précision inégalées, adaptées exactement au jargon de votre secteur.
Comparons en détail ces deux approches pour déterminer quelle voie stratégique correspond le mieux à vos objectifs métier à long terme.
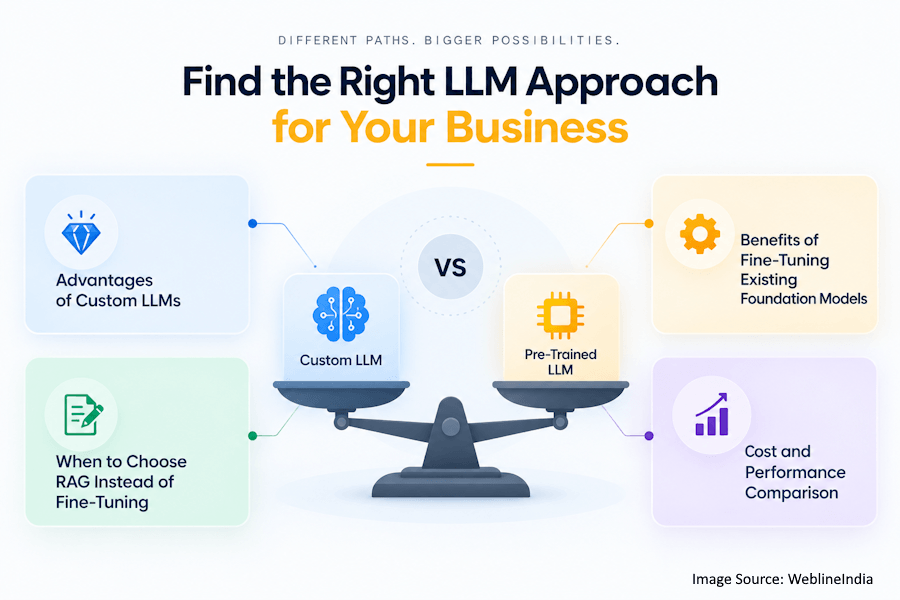
Avantages des LLM personnalisés
Les organisations possèdent leurs poids de modèle. Les ingénieurs modifient directement les couches du réseau de neurones. Le développement de LLM personnalisé offre un contrôle architectural inégalé. Les algorithmes propriétaires protègent les avantages concurrentiels. Les politiques de sécurité imposent des règles de zéro conservation des données. Les performances correspondent exactement aux charges de travail de l’entreprise.
- La propriété totale évite les pièges de la dépendance vis-à-vis d’un fournisseur et les changements de tarifs arbitraires.
- Les paramètres de fine-tuning s’adaptent avec une grande précision aux domaines industriels de niche.
- La vitesse d’inférence s’optimise pour des configurations matérielles spécifiques dans des centres de données locaux.
Avantages du fine-tuning de modèles de fondation existants
Construire un modèle de zéro coûte des millions. Les services de fine-tuning de modèles d’IA peuvent réduire le besoin d’un entraînement à partir de zéro en adaptant des modèles de fondation existants aux exigences d’un domaine précis. Les modèles existants offrent une solide base grammaticale. Les jeux de données du domaine adaptent les poids pré-entraînés. Les cycles d’entraînement se terminent en quelques jours. Les ingénieurs s’appuient sur des frameworks de développement LLM open source.
- Les poids pré-entraînés apportent rapidement une compétence de base sans entraînement intensif à partir de zéro.
- Les dépenses de calcul restent inférieures à celles d’un entraînement complet à plusieurs millions de dollars.
- Les jeux de données spécialisés orientent les capacités de raisonnement général vers des tâches métier précises.
- Les délais de développement passent de plusieurs années à quelques semaines.
Quand choisir le RAG plutôt que le fine-tuning
L’entraînement modifie les poids fondamentaux du modèle. La génération augmentée par récupération (RAG) laisse les poids intacts. Les entreprises mettent à jour quotidiennement leurs bases de connaissances externes. Les systèmes RAG récupèrent les documents de manière dynamique. Les ingénieurs choisissent le RAG pour les wikis qui changent fréquemment. Les coûts de développement restent minimes.
- Les mises à jour dynamiques de documents ne nécessitent aucun cycle de ré-entraînement ni aucune mise à jour des poids.
- Les bases de données vectorielles externes stockent les wikis de l’entreprise en temps réel pour une récupération instantanée.
Comparaison des coûts et des performances
Les architectures personnalisées exigent d’immenses clusters de calcul. Le fine-tuning de modèles de fondation nécessite des locations de GPU modérées. Les architectures RAG reposent sur des recherches vectorielles rapides. Les responsables financiers calculent précisément le retour sur investissement. Les benchmarks de performance orientent le choix de l’architecture.
- Le pré-entraînement personnalisé engendre des factures de calcul de plusieurs millions de dollars pour les entraînements complets.
- Le fine-tuning nécessite des budgets GPU cloud modestes pour les mises à jour de poids d’adaptateurs.
- Les implémentations RAG optimisent les coûts de stockage des bases de données tout en maintenant une grande exactitude factuelle.
- Les mesures de latence guident les choix finaux de déploiement en production dans les différentes unités métier.
Processus étape par étape pour créer un LLM personnalisé pour votre entreprise
Créer un LLM personnalisé consiste à définir des cas d’usage métier précis, à collecter et nettoyer les données propriétaires, à sélectionner le bon modèle de base, à le fine-tuner par un entraînement spécialisé, puis à évaluer rigoureusement ses performances avant un déploiement sécurisé en entreprise.
Explorons chaque phase en détail pour voir comment cette feuille de route structurée garantit la réussite de votre projet d’IA.
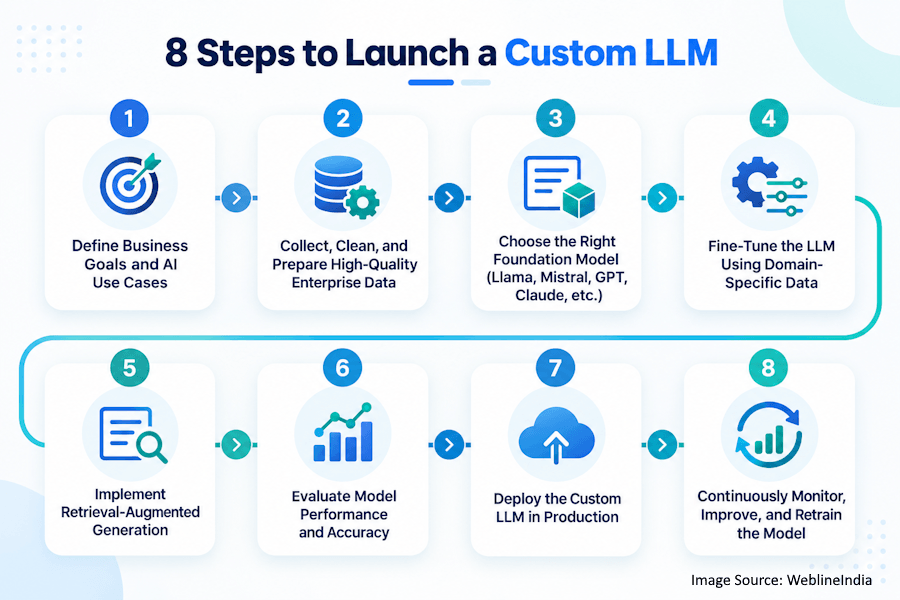
Définir les objectifs métier et les cas d’usage de l’IA
Les dirigeants identifient précisément les goulets d’étranglement opérationnels. Les ingénieurs isolent les tâches manuelles répétitives. Les chefs de projet définissent les indicateurs de réussite. Des objectifs clairs évitent le gaspillage de ressources de calcul. Les parties prenantes examinent attentivement les documents d’alignement.
Collecter, nettoyer et préparer des données d’entreprise de haute qualité
Les données brutes de l’entreprise contiennent des erreurs de format. Les ingénieurs éliminent sans pitié les doublons. Les analyseurs de texte suppriment les identifiants personnels sensibles. Des jeux de données propres alimentent les pipelines d’entraînement. Une haute qualité des données garantit des résultats fiables.
- Les ingénieurs de données extraient le texte brut des bases de données d’entreprise héritées.
- Des scripts automatisés suppriment des documents les encodages de caractères corrompus.
- Le nettoyage des données personnelles (PII) protège la vie privée des employés avant le début de l’entraînement.
- Des fichiers JSON formatés organisent correctement les échantillons d’entraînement pour les modèles.
Choisir le bon modèle de fondation (Llama, Mistral, GPT, Claude, etc.)
Le choix du modèle détermine la réussite en aval. Les ingénieurs testent plusieurs architectures de base. Les poids ouverts offrent la liberté d’un déploiement local. Les modèles propriétaires fournissent de solides bases de raisonnement. Les accords de licence déterminent les droits d’usage commercial.
- Des tests de référence évaluent la vitesse de raisonnement de base de différents modèles candidats.
- Les conditions de licence autorisent le déploiement commercial en entreprise sans risque juridique.
Fine-tuner le LLM avec des données spécifiques au domaine
Des adaptateurs spécialisés modifient le comportement du modèle, tandis que les services de développement de machine learning peuvent soutenir l’ensemble du flux d’entraînement, de validation et d’ingénierie du modèle. Les courbes de perte diminuent au fil des itérations d’époques. Les ingénieurs valident les résultats sur des jeux de test. Les poids finaux sont enregistrés dans des dépôts sécurisés.
- Les adaptateurs LoRA réduisent au minimum le nombre de paramètres entraînés pendant le fine-tuning.
- Les clusters de GPU traitent efficacement des téraoctets de texte du domaine.
- Les métriques de perte suivent les taux de convergence pendant les époques d’entraînement du modèle.
Mettre en œuvre la génération augmentée par récupération (RAG)
Des découpeurs de texte fragmentent les longs rapports d’entreprise. Des modèles d’embeddings convertissent le texte en vecteurs. Les bases de données vectorielles indexent l’information sémantique. Les algorithmes de recherche récupèrent le contexte documentaire pertinent. Les prompts combinent les faits récupérés avec les requêtes.
- Le découpage du texte divise efficacement les manuels volumineux en segments plus petits.
- Les modèles d’embeddings traduisent les mots en vecteurs numériques pour l’indexation.
- Les bases de données vectorielles stockent des index sémantiques multidimensionnels pour des requêtes rapides.
- L’injection de contexte ancre les réponses du modèle dans des faits vérifiés.
Évaluer les performances et la précision du modèle
Des scripts de test automatisés mesurent la qualité des réponses. Des relecteurs humains évaluent les résultats subjectifs. Des suites de benchmarks testent les limites du raisonnement. Des filtres de sécurité recherchent les vulnérabilités à l’injection de prompts. De mauvais scores déclenchent un ré-entraînement immédiat.
- Des scripts d’évaluation automatisés exécutent des suites de tests de référence sur les résultats.
- Des experts humains évaluent manuellement la précision métier pour une revue qualitative.
Déployer le LLM personnalisé en production
Les services DevOps peuvent soutenir la mise en place des serveurs d’inférence cloud, des pipelines de déploiement et des environnements de production évolutifs pour les LLM personnalisés. Des répartiteurs de charge distribuent le trafic des utilisateurs entrants. Des points de terminaison d’API connectent les applications internes. Des outils de supervision suivent l’état du système. Les environnements de production garantissent une haute disponibilité.
- Les clusters Kubernetes font évoluer automatiquement les nœuds d’inférence lors des pics de trafic.
- Les passerelles d’API gèrent en toute sécurité les jetons d’authentification des utilisateurs de l’entreprise.
- Les répartiteurs de charge distribuent harmonieusement le trafic de requêtes intense entre les serveurs.
- Des mécanismes de repli évitent les interruptions de service imprévues pendant les opérations de maintenance.
Surveiller, améliorer et ré-entraîner le modèle en continu
Les retours des utilisateurs mettent en évidence les défaillances opérationnelles. Des pipelines de journalisation capturent les réponses incorrectes. Les data scientists constituent de nouveaux échantillons d’entraînement. Des ré-entraînements planifiés mettent à jour les poids du modèle. Les systèmes d’entreprise évoluent avec les besoins de l’activité.
- Des boutons de retour d’expérience enregistrent instantanément la note de l’utilisateur après chaque génération.
- Les systèmes de journalisation signalent pour examen les hallucinations récurrentes.
- Les pipelines de données ingèrent chaque semaine les politiques d’entreprise nouvellement mises à jour.
- Les cycles de ré-entraînement planifiés maintiennent l’intelligence du modèle à jour face aux évolutions du marché.
Prêt à transformer votre feuille de route LLM en une solution prête pour la production ? Nos ingénieurs en IA peuvent vous aider à la concevoir, la fine-tuner, la déployer et la faire évoluer.
Choisir le meilleur modèle de fondation pour le développement d’un LLM personnalisé
Sélectionner le modèle de fondation optimal suppose de mettre en balance des paramètres essentiels, tels que la charge de calcul, les contraintes de licence de l’architecture, les performances de base dans votre domaine et les exigences de latence d’inférence, au regard des contraintes techniques propres à votre organisation.
Analysons comment évaluer systématiquement ces variables architecturales afin d’identifier le modèle qui maximise à la fois les capacités et la rentabilité.
Meta Llama
Les poids ouverts séduisent les développeurs d’entreprise. Le déploiement local garantit la sécurité des données. Le fine-tuning des modèles Llama nécessite un matériel standard. Les forums communautaires proposent de nombreux guides de dépannage.
- Les poids open source permettent un déploiement sur des serveurs locaux derrière des pare-feu.
- Les tailles de paramètres vont des petites configurations aux très grandes configurations d’entreprise.
Mistral AI
L’ingénierie européenne favorise une grande efficacité. Les modèles compacts offrent des vitesses d’inférence rapides. Les clients d’entreprise obtiennent des licences pour des variantes de poids propriétaires. Les conceptions d’architecture optimisent la consommation de mémoire.
- Une architecture efficace réduit considérablement la charge de calcul opérationnelle.
- Les tailles de modèle compactes accélèrent les temps de génération des réponses pour les utilisateurs.
- De solides résultats de raisonnement aux benchmarks rivalisent avec ceux de concurrents plus grands du secteur.
- Des licences flexibles conviennent à des structures commerciales variées.
Modèles GPT d’OpenAI
Les API propriétaires offrent de puissantes bases de raisonnement. Les développeurs évitent de gérer des clusters d’infrastructure. Des mises à jour régulières introduisent des fonctionnalités avancées. Les politiques de confidentialité protègent les données des clients d’entreprise.
- Les API managées éliminent les tâches de maintenance d’infrastructure pour les équipes internes.
- Le raisonnement avancé gère facilement des problèmes de logique complexes sans réglage.
Anthropic Claude
De longues fenêtres de contexte permettent de traiter des livres entiers. Des garde-fous de sécurité limitent les contenus toxiques. Les clients d’entreprise intègrent des points de terminaison d’API sécurisés. Les analystes financiers analysent directement de grands tableurs.
- D’immenses fenêtres de contexte ingèrent des bases de code complètes et des rapports denses.
- Une sécurité constitutionnelle intégrée réduit les contenus nuisibles ou toxiques.
- L’analyse de documents extrait des données structurées de pages financières denses.
Modèles Google Gemini
Les capacités multimodales traitent le texte et la vidéo. L’infrastructure cloud intègre des outils d’IA natifs. Les fonctions de recherche d’entreprise se connectent aux disques internes. Les architectures évolutives gèrent les charges de travail importantes.
- La multimodalité native traite directement les images et les flux vidéo.
- L’intégration à Google Cloud simplifie les pipelines de déploiement en entreprise.
Infrastructure et pile technologique nécessaires au développement d’un LLM personnalisé
Développer un LLM personnalisé robuste exige des clusters de calcul haute performance équipés de GPU spécialisés, des pipelines de données évolutifs, des frameworks d’orchestration d’entreprise et des bases de données vectorielles sécurisées pour la génération augmentée par récupération.
Examinons l’architecture technique essentielle nécessaire pour faire fonctionner efficacement votre infrastructure d’IA d’entreprise.
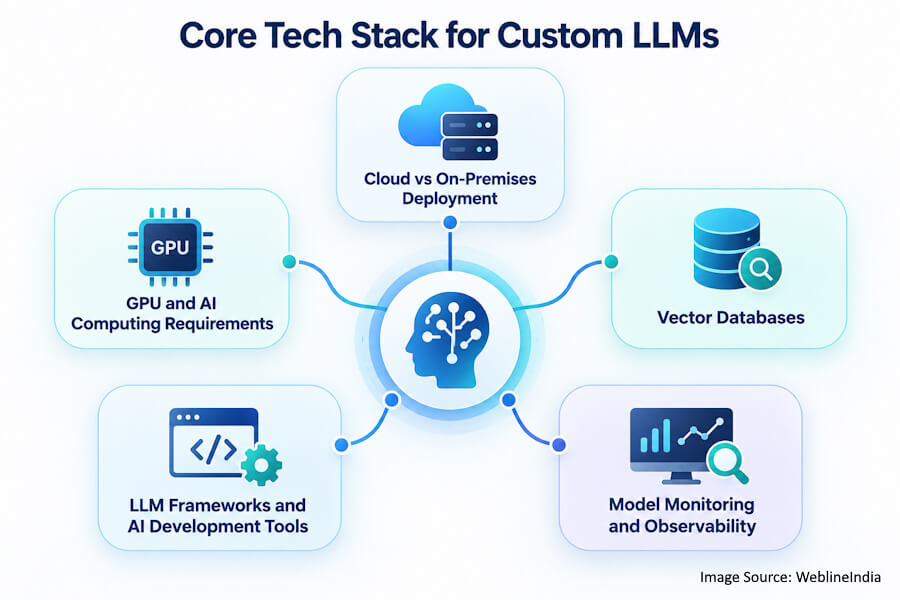
Déploiement cloud ou sur site
Les fournisseurs cloud offrent une mise à l’échelle élastique des GPU. Les serveurs sur site protègent les secrets hautement confidentiels. Les réglementations financières dictent les règles de localisation du matériel. Les architectures hybrides équilibrent coût et sécurité.
Besoins en GPU et en puissance de calcul pour l’IA
L’apprentissage profond exige des puces accélératrices spécialisées. Une grande capacité de VRAM permet de charger de grands modèles. La vitesse des interconnexions accélère les tâches d’entraînement distribué. La consommation électrique pèse sur les budgets des centres de données.
- Les clusters NVIDIA H100 réduisent considérablement les temps d’entraînement des modèles.
- Les grandes capacités de VRAM permettent de charger en toute sécurité d’importants poids de paramètres.
- Les interconnexions à haut débit relient plusieurs nœuds d’entraînement sans latence.
Bases de données vectorielles
Les embeddings nécessitent des solutions de stockage spécialisées. Les recherches par similarité récupèrent les fragments de documents correspondants. Les architectures évolutives gèrent des milliards de vecteurs. La vitesse d’indexation influe sur la latence des requêtes.
- Pinecone gère efficacement des index de recherche vectorielle natifs du cloud.
- Milvus s’adapte en toute fluidité à des clusters de serveurs locaux distribués.
- Qdrant gère rapidement les opérations de filtrage de métadonnées pendant la recherche.
Frameworks LLM et outils de développement d’IA
Les bibliothèques Python simplifient la construction de pipelines. Les outils d’orchestration enchaînent des étapes d’agents complexes. Les paquets de quantification réduisent l’empreinte mémoire des modèles. Les outils de conteneurisation standardisent les environnements de déploiement.
- LangChain orchestre des flux de travail complexes d’agents d’intelligence artificielle en plusieurs étapes.
- LlamaIndex connecte des documents externes aux modèles pour le RAG.
Supervision et observabilité du modèle
Des métriques suivent les taux de consommation de jetons. La journalisation des erreurs révèle les points de défaillance des prompts. La détection de dérive repère les tendances de baisse de précision. Des scanners de sécurité bloquent les entrées malveillantes.
- Les tableaux de bord Grafana affichent en temps réel les indicateurs d’utilisation des ressources du système.
- Les outils de journalisation capturent les traces d’erreurs des prompts utilisateurs pour analyse.
- Les moniteurs de dérive alertent les ingénieurs en cas de baisse de performance.
- Les filtres de sécurité bloquent les tentatives non autorisées d’injection de prompts.
Principaux défis du développement d’un LLM personnalisé et comment les surmonter
Le développement d’un LLM personnalisé s’accompagne souvent d’obstacles tels que l’envolée des coûts de calcul, les risques pour la confidentialité des données, l’oubli catastrophique pendant le fine-tuning et la gestion de la dérive du modèle dans le temps.
Découvrons les stratégies d’atténuation éprouvées qui permettent de franchir ces obstacles techniques courants.
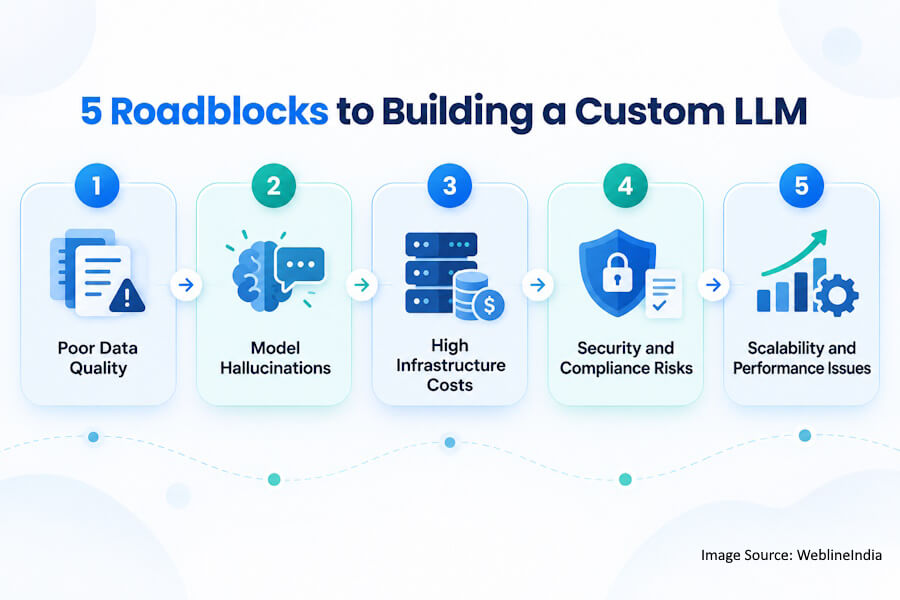
Mauvaise qualité des données
Des documents incomplets provoquent un comportement erratique du modèle. Les pipelines de nettoyage des données éliminent le bruit. Des scripts de validation automatisés vérifient les formats de texte. Des auditeurs humains vérifient l’intégrité du jeu de données.
- Des sections de documents manquantes créent des lacunes de raisonnement logique pendant l’entraînement.
- Des scripts d’expressions régulières automatisés suppriment des fichiers les caractères de texte corrompus.
Hallucinations du modèle
Les modèles inventent de faux faits historiques. Les architectures RAG ancrent les réponses dans la réalité. Des réglages stricts de température réduisent l’invention créative. Des suites d’évaluation détectent les erreurs tôt.
- Les prompts d’ancrage limitent strictement les réponses aux documents sources fournis.
- Les réglages de faible température diminuent le taux de génération aléatoire.
- Les exigences de citation obligent les modèles à référencer les sources documentaires.
Coûts d’infrastructure élevés
La location de GPU pèse lourdement sur les budgets de l’entreprise. La quantification du modèle réduit l’empreinte mémoire. Des modèles plus petits remplacent les systèmes de fondation massifs. Un traitement par lots efficace maximise l’utilisation du matériel.
- La quantification du modèle réduit de moitié la taille des fichiers sans perte de qualité.
- Les instances GPU spot réduisent sensiblement les factures de location de calcul cloud.
- Le regroupement des requêtes maximise l’utilisation de la capacité de calcul matérielle active.
Risques de sécurité et de conformité
Les fuites de données entraînent des amendes réglementaires. Les protocoles de chiffrement sécurisent les fichiers stockés. Les listes de contrôle d’accès restreignent les autorisations des utilisateurs. Des audits réguliers vérifient l’intégrité du système.
- Les normes de chiffrement protègent les fichiers lors des transferts sur le réseau interne.
- L’accès basé sur les rôles limite la visibilité des documents sensibles entre les services.
- Les audits de conformité vérifient le respect des cadres réglementaires du secteur.
- Les tests d’intrusion révèlent les vulnérabilités de sécurité cachées des applications.
Problèmes d’évolutivité et de performance
Un fort trafic d’utilisateurs provoque des goulets d’étranglement sur les serveurs. Les répartiteurs de charge distribuent les requêtes entrantes. Les couches de cache stockent les résultats des requêtes fréquentes. Les files d’attente asynchrones gèrent les charges de travail importantes.
- Les répartiteurs de charge évitent les plantages par surcharge d’un serveur unique lors des pics de trafic.
- La mise en cache des réponses sert instantanément les requêtes identiques sans inférence.
Combien coûte la création d’un LLM personnalisé pour votre entreprise ?
La construction d’un LLM d’entreprise personnalisé implique des engagements financiers variables, allant de simples configurations d’API à des pipelines d’entraînement gourmands en ressources. Les organisations doivent prendre en compte les coûts de calcul GPU, les pipelines de préparation des données, les talents d’ingénierie spécialisés et les coûts de maintenance à long terme.
Détaillons les variables financières réelles et les estimations budgétaires pour vous aider à planifier un investissement précis pour votre prochain projet d’intelligence artificielle d’entreprise.
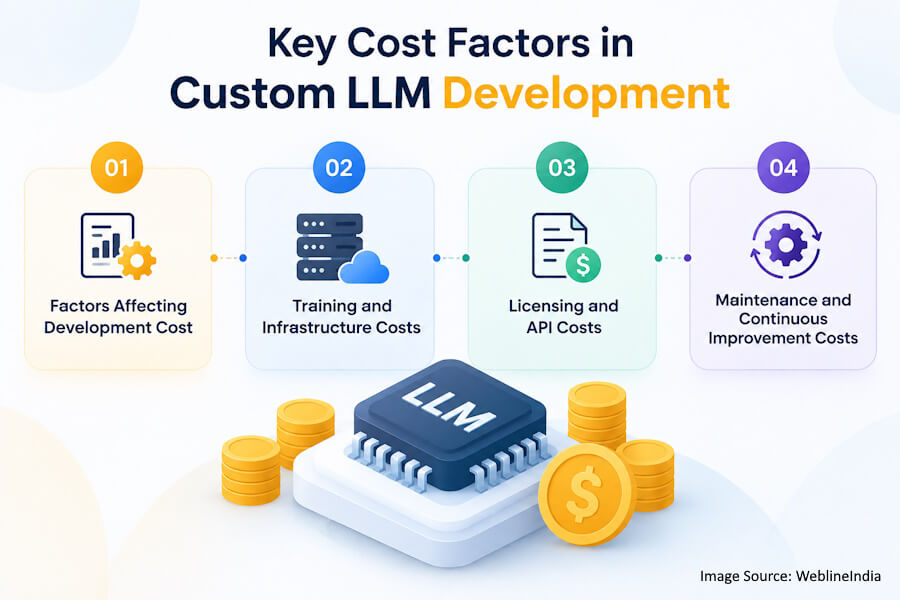
Facteurs influençant le coût de développement
La taille du jeu de données influe sur le travail de préparation des données, tandis que le nombre de paramètres du modèle détermine les besoins matériels. Les services de conseil en IA peuvent aider les organisations à évaluer la complexité de l’intégration, les besoins en infrastructure et d’autres facteurs qui influencent le périmètre du projet.
- Les grands jeux de données nécessitent un long travail de nettoyage manuel par les ingénieurs.
- Les modèles à grand nombre de paramètres exigent du matériel GPU haut de gamme coûteux.
Coûts d’entraînement et d’infrastructure
Les clusters de calcul nécessitent un financement substantiel. Les factures d’électricité ajoutent des dépenses d’exploitation continues. Les fournisseurs cloud facturent des tarifs GPU à l’heure. Les achats de matériel exigent un capital initial.
- Les locations de GPU cloud à l’heure s’accumulent rapidement pendant les entraînements.
- Les frais d’alimentation et de refroidissement alourdissent les budgets d’installation des serveurs.
- La mise en place du cluster nécessite du matériel réseau à haut débit coûteux.
- Les contrats de maintenance couvrent les pannes imprévues de composants matériels des serveurs.
Coûts de licence et d’API
Les modèles de fondation propriétaires facturent des frais d’abonnement. Les permis d’usage commercial entraînent des frais supplémentaires. Les poids open source éliminent les factures de licence récurrentes. Des revues juridiques garantissent la conformité.
- Les jetons d’API commerciaux accumulent des frais mensuels en fonction du volume.
- Les abonnements aux modèles propriétaires augmentent avec le nombre d’utilisateurs actifs.
- Les poids open source évitent la charge de frais de licence logicielle récurrents.
Coûts de maintenance et d’amélioration continue
Les modèles nécessitent des cycles de ré-entraînement continus. Les équipes d’ingénierie corrigent les bogues opérationnels. Les correctifs de sécurité protègent les serveurs d’infrastructure. Les outils de supervision entraînent des frais d’abonnement.
- Les pipelines de ré-entraînement ingèrent régulièrement les documents d’entreprise nouvellement mis à jour.
- Les ingénieurs de support diagnostiquent chaque jour les journaux d’erreurs de production imprévus.
- Les équipes de sécurité appliquent des correctifs logiciels aux serveurs de l’entreprise.
- Les outils d’observabilité facturent des frais selon le volume de données de journalisation.
Obtenez une estimation réaliste de votre LLM personnalisé en fonction de votre cas d’usage, de vos données, du choix du modèle, des intégrations, de l’infrastructure et des exigences de déploiement.
Bonnes pratiques pour créer des LLM d’entreprise sécurisés, précis et évolutifs
La mise en œuvre de LLM d’entreprise robustes exige d’appliquer un chiffrement strict des données, de mettre en place des boucles de rétroaction continues pour limiter les hallucinations et de concevoir des architectures à mise à l’échelle horizontale capables de gérer les pics de charge.
Explorons les principales stratégies de déploiement qui garantissent que votre écosystème d’IA reste protégé, très précis et infiniment adaptable à la croissance future de l’organisation.
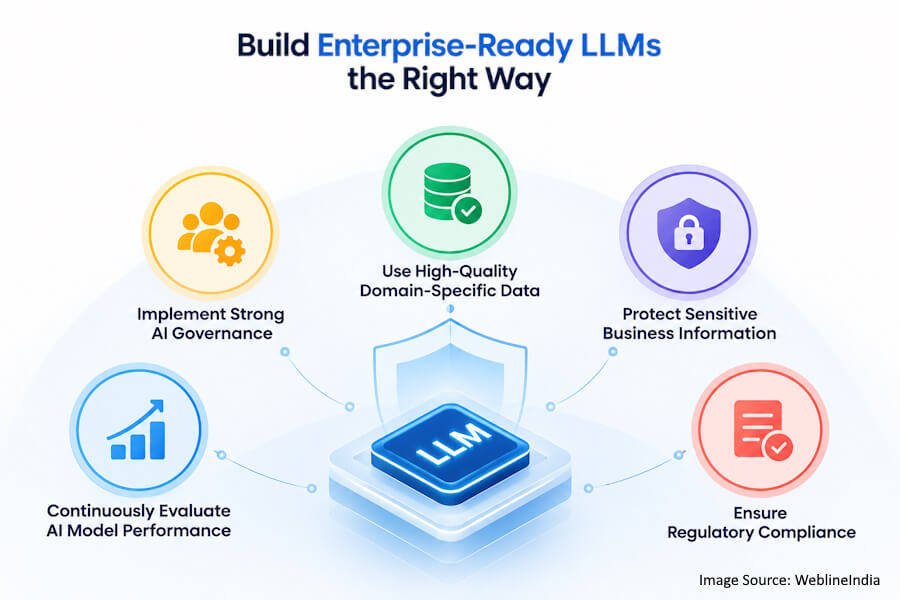
Mettre en place une solide gouvernance de l’IA
Des comités supervisent les projets d’intelligence artificielle. Des lignes directrices éthiques préviennent les résultats biaisés. Le contrôle de version suit les mises à jour du modèle. La documentation consigne les décisions d’architecture.
Utiliser des données de haute qualité spécifiques au domaine
Des jeux de données sélectionnés améliorent la précision des résultats. La suppression du bruit élimine les textes qui prêtent à confusion. Des formats standardisés simplifient les pipelines d’entraînement. Des audits réguliers préservent la qualité des données.
- Les jeux de données sélectionnés fournissent aux modèles des signaux d’apprentissage sémantique clairs.
- La réduction du bruit filtre complètement les textes non pertinents issus d’Internet.
- Des schémas standardisés organisent correctement les documents d’entreprise issus de sources multiples.
Protéger les informations sensibles de l’entreprise
Le masquage des données dissimule les chiffres confidentiels. Les serveurs locaux isolent les fichiers propriétaires. Les politiques de zéro conservation protègent la vie privée des utilisateurs. Les pare-feu réseau bloquent les menaces externes.
- Le masquage des données remplace les noms réels par des substituts sécurisés.
- Les déploiements sur serveurs locaux isolent les fichiers des réseaux publics.
- Les accords de zéro conservation des données protègent strictement la confidentialité des prompts de l’entreprise.
- Les pare-feu réseau bloquent les tentatives d’intrusion externes non autorisées.
Évaluer en continu les performances du modèle d’IA
Des benchmarks automatisés mesurent l’évolution de la précision. Les retours des utilisateurs signalent les problèmes opérationnels. Le red teaming révèle les vulnérabilités cachées. Des revues régulières mettent à jour les objectifs de performance.
- Des scripts de test automatisés suivent dans le temps l’évolution des indicateurs de précision.
- Les boutons de notation des utilisateurs recueillent instantanément des retours sur les performances en conditions réelles.
Garantir la conformité réglementaire
Les équipes juridiques examinent les pratiques de traitement des données. Les directives du RGPD protègent la vie privée des clients. Les normes du secteur dictent les contrôles de sécurité. La documentation prouve le respect de la réglementation.
- Les revues juridiques garantissent le respect des lois strictes sur la confidentialité des données.
- Les protocoles RGPD gèrent le consentement des utilisateurs et les demandes de suppression de données.
- Les normes du secteur imposent des longueurs de clés de chiffrement spécifiques.
Cas d’usage concrets du développement de LLM personnalisé dans différents secteurs
Les LLM personnalisés transforment les secteurs d’activité en automatisant l’analyse de documents juridiques complexes dans la finance, en alimentant des suggestions de diagnostic hyper-personnalisées dans la santé et en pilotant une logistique d’inventaire hyper-ciblée dans le commerce de détail. Découvrez comment les organisations de secteurs variés exploitent ces systèmes sur mesure pour optimiser leurs flux de travail, réduire fortement leurs frais généraux et s’assurer un avantage concurrentiel considérable.
Santé
Les modèles cliniques résument les historiques de patients. Les chercheurs médicaux analysent des études sur les interactions médicamenteuses. Les assistants de diagnostic traitent les notes d’imagerie. Les flux administratifs accélèrent la facturation.
- Les modèles cliniques résument pour les médecins des dossiers médicaux denses de patients.
- Les outils de recherche analysent rapidement des études complexes sur les interactions médicamenteuses.
Banque et services financiers
Les algorithmes de détection de la fraude analysent les flux de transactions. Les traders algorithmiques traitent les rapports de marché. Les systèmes de conformité examinent les demandes de prêt. Des agents automatisés répondent aux questions sur les comptes.
- Les algorithmes de détection de la fraude signalent instantanément les flux de transactions suspects.
- Les modèles financiers analysent les rapports de résultats pour les investisseurs institutionnels.
- Les outils de conformité examinent minutieusement les facteurs de risque des demandes de prêt.
- Les assistants automatisés répondent 24 h/24 et 7 j/7 aux questions courantes des clients sur leurs comptes.
Juridique
Les analyseurs de contrats repèrent les clauses défavorables. Les moteurs de recherche de jurisprudence retrouvent les précédents. Les outils de synthèse de documents passent en revue les dépositions. Les pipelines de due diligence traitent les fusions.
- Les analyseurs de contrats mettent instantanément en évidence les clauses de responsabilité défavorables.
- Les moteurs de recherche juridique retrouvent les précédents jurisprudentiels historiques pertinents.
Industrie manufacturière
Les modèles de chaîne d’approvisionnement prédisent les pénuries de matières. Les journaux de maintenance planifient les réparations des machines. Les systèmes de contrôle qualité analysent les rapports de défauts. Les assistants de conception examinent les plans techniques.
- Les modèles de chaîne d’approvisionnement anticipent tôt les risques de pénurie de matières premières.
- Les journaux de maintenance planifient de manière proactive les réparations des machines d’usine.
- Les systèmes de contrôle qualité analysent les rapports de défauts d’assemblage.
- Les assistants de conception examinent des plans d’ingénierie techniques complexes.
Commerce de détail et e-commerce
Les moteurs de recommandation suggèrent des produits pertinents. Les modèles d’inventaire prévoient la demande saisonnière. Les chatbots multilingues assistent les acheteurs du monde entier. Les analyseurs de sentiment examinent les avis des clients.
- Les moteurs de recommandation suggèrent des produits pertinents aux acheteurs en ligne.
- Les modèles d’inventaire prévoient avec précision la demande saisonnière de stocks.
Support client
Les systèmes de ticketing acheminent automatiquement les demandes. Les outils de suivi du sentiment donnent la priorité aux appelants mécontents. Les bases de connaissances génèrent des réponses instantanées. Les assistants de réponse rédigent des réponses polies.
- Les systèmes de ticketing acheminent les demandes des clients vers les agents appropriés.
- Les outils de suivi du sentiment donnent la priorité aux files d’attente des appelants mécontents.
- Les bases de connaissances génèrent des réponses instantanées pour les utilisateurs.
- Les assistants de réponse rédigent des réponses polies aux e-mails des clients.
Comment choisir la bonne société de développement de LLM personnalisé pour votre entreprise
Évaluer les partenaires potentiels de développement de LLM personnalisé suppose d’analyser leur portefeuille de modèles d’entreprise déployés, leur expertise technique dans les frameworks de fine-tuning, leurs protocoles de sécurité des données et leurs capacités de maintenance après le lancement.
Nous détaillons ici les critères d’évaluation essentiels pour sélectionner un prestataire technologique fiable, capable de transformer votre ambitieuse vision de l’intelligence artificielle en une réalité d’entreprise sécurisée et prête pour la production.
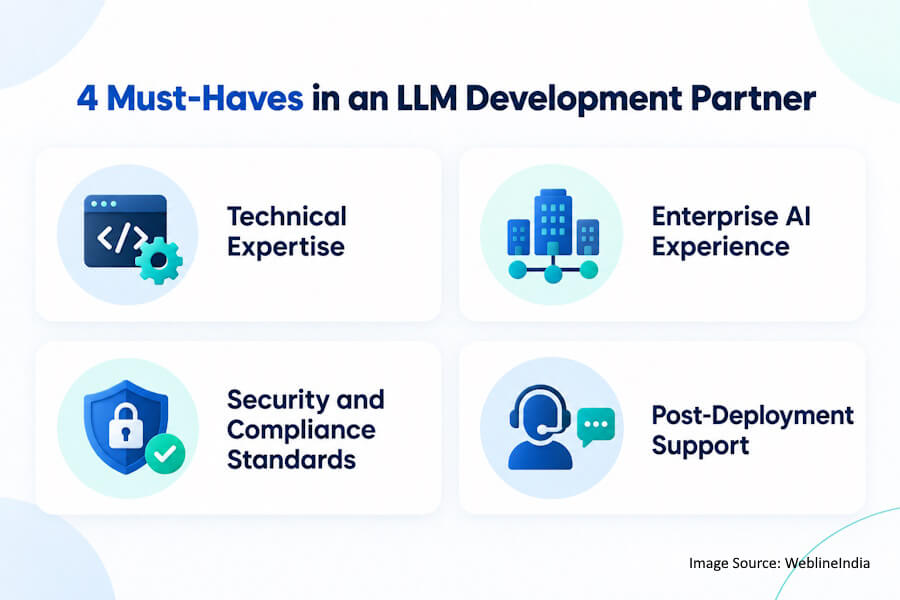
Expertise technique
Les ingénieurs évaluent les compétences en apprentissage profond. Les équipes démontrent des déploiements de modèles réussis. Les certifications attestent de la maîtrise de l’infrastructure cloud. Les portfolios mettent en avant des solutions d’entreprise complexes.
Expérience de l’IA en entreprise
Les prestataires comprennent les exigences de sécurité des entreprises. Les études de cas prouvent leur connaissance de secteurs précis. Les références clients valident les performances passées. Leurs capacités de montée en charge correspondent aux besoins de l’entreprise.
- Les prestataires comprennent les exigences strictes de conformité en matière de sécurité des entreprises.
- Les études de cas prouvent une connaissance opérationnelle approfondie de secteurs précis.
Normes de sécurité et de conformité
Les partenaires appliquent des règles strictes de confidentialité des données. Les certifications attestent de la sécurité de l’infrastructure. Les accords juridiques protègent la propriété intellectuelle. Les pistes d’audit garantissent le respect de la réglementation.
- Les partenaires de développement appliquent des règles internes strictes de confidentialité des données.
- Les certifications de sécurité attestent d’une protection robuste de l’infrastructure cloud.
- Les contrats juridiques protègent la propriété intellectuelle propriétaire de l’entreprise.
- Les pistes d’audit garantissent une conformité réglementaire complète avec les normes du secteur.
Support après déploiement
Les contrats de maintenance garantissent la disponibilité du système. Les services de supervision suivent les indicateurs de performance. Des mises à jour régulières maintiennent les modèles à jour. Des équipes de support dédiées résolvent les bogues.
- Les accords de maintenance garantissent une haute disponibilité des applications et du système.
- Les services de supervision suivent en direct les indicateurs de précision des performances.
Tendances futures du développement de LLM personnalisé et de l’IA d’entreprise
Le paysage de l’IA d’entreprise évolue rapidement vers l’edge computing hyper-efficace, les capacités multimodales et les flux de travail agentiques autonomes qui exécutent des processus métier complexes en plusieurs étapes sans intervention humaine.
Découvrons maintenant les avancées technologiques et les innovations stratégiques à venir qui redéfiniront la manière dont votre entreprise exploitera les grands modèles de langage personnalisés dans les années à venir.
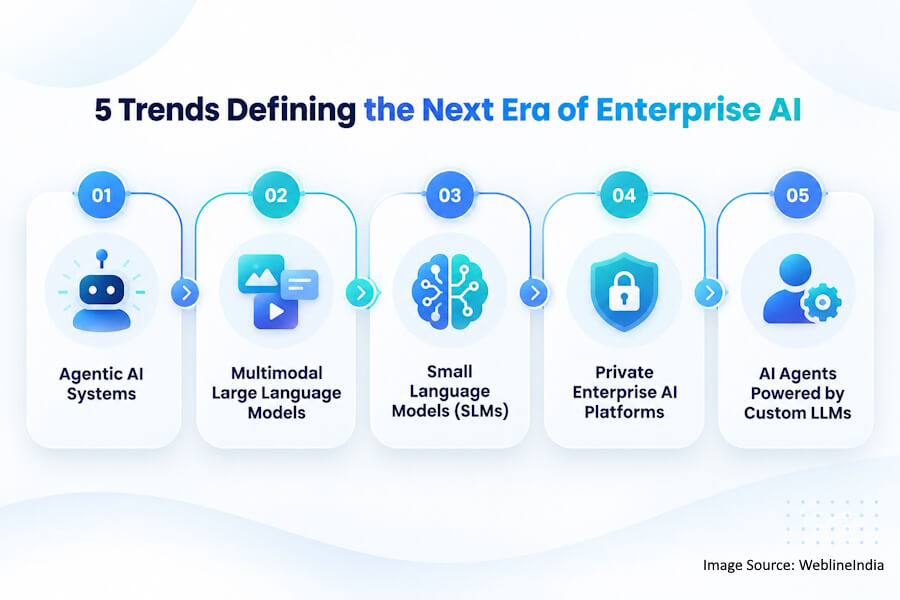
Systèmes d’IA agentiques
Des agents autonomes exécutent des flux de travail en plusieurs étapes. Les systèmes collaborent pour résoudre des problèmes. Des moteurs de décision gèrent des tâches complexes. La productivité augmente dans tous les services.
Grands modèles de langage multimodaux
Les modèles traitent le texte, l’audio et la vidéo. Des capteurs intégrés analysent les environnements physiques. Des entrées riches améliorent la compréhension du contexte. Les applications couvrent plusieurs types de perception sensorielle.
- Les modèles traitent simultanément des flux de texte, d’audio et de vidéo.
- Des capteurs intégrés analysent les environnements de travail physiques des usines.
- Des flux d’entrée riches améliorent en profondeur la compréhension du contexte.
- Les applications couvrent en toute fluidité plusieurs types de données sensorielles.
Petits modèles de langage (SLM)
Les modèles compacts s’exécutent sur des appareils en périphérie (edge). Le matériel local traite instantanément les requêtes. Les besoins en ressources diminuent nettement. La confidentialité s’améliore grâce à l’exécution locale.
- Les modèles compacts s’exécutent localement sur des appareils en périphérie.
- Le matériel local traite instantanément les requêtes des utilisateurs.
Plateformes d’IA d’entreprise privées
Des plateformes sécurisées centralisent les outils d’intelligence artificielle. Des places de marché internes partagent les modèles entraînés. Des tableaux de bord de gouvernance surveillent l’utilisation du système. Les entreprises maîtrisent leur destin en matière d’IA.
- Les plateformes sécurisées centralisent les outils d’intelligence artificielle de l’entreprise.
- Les places de marché internes partagent les poids de modèles entraînés sur mesure.
- Les tableaux de bord de gouvernance surveillent l’utilisation du système à l’échelle de l’entreprise.
- Les entreprises contrôlent entièrement leur infrastructure d’intelligence artificielle.
Agents d’IA propulsés par des LLM personnalisés
Le développement d’agents d’IA pour l’entreprise peut associer des agents spécialisés à des LLM personnalisés pour exécuter des opérations métier et coordonner des flux de travail logiciels. Des assistants intelligents gèrent les agendas quotidiens. Les gains d’efficacité transforment les flux de travail de l’entreprise.
- Des agents spécialisés exécutent automatiquement des opérations métier complexes.
- Des outils automatisés coordonnent les pipelines de développement et de déploiement logiciel.
Réflexions finales sur la création d’un LLM personnalisé pour une réussite durable de l’entreprise
L’adoption de l’intelligence artificielle déterminera les futurs leaders du marché. Les outils publics génériques ne répondent pas aux exigences des entreprises. Les organisations créent des modèles personnalisés pour sécuriser leurs données. Les flux de travail propriétaires exigent une intelligence spécialisée. Une réussite durable requiert une infrastructure d’IA robuste. Les entreprises s’associent à des prestataires experts pour accélérer l’exécution.
WeblineIndia propose d’excellents services de développement de LLM personnalisé. Ses équipes d’ingénieurs construisent des LLM d’entreprise sécurisés. Ses spécialistes fine-tunent les modèles pour une précision maximale. WeblineIndia transforme les opérations des entreprises grâce à des solutions d’IA sur mesure. Les organisations obtiennent dès aujourd’hui des avantages concurrentiels durables. Contactez WeblineIndia pour démarrer l’intégration de l’intelligence artificielle personnalisée.
Hashtags pour les réseaux sociaux
#LLMPersonnalisé #GrandsModèlesDeLangage #IAEnEntreprise #IAGénérative #IntelligenceArtificielle #LLM #DéveloppementIA #IngénierieIA #IAAgentique #AgentsIA #GénérationAugmentéeParRécupération #RAG #ApprentissageAutomatique #InfrastructureIA #TransformationNumérique #TechnologieDEntreprise #MLOps #InnovationIA #IAPrivée #AutomatisationDesAffaires
Créez un LLM personnalisé, sécurisé et évolutif, adapté aux données et aux flux de travail de votre entreprise, avec une équipe de développement d’IA expérimentée.
Foire aux questions
Comment créer un LLM personnalisé pour mon entreprise ?
Les entreprises collectent des données propriétaires, choisissent des architectures open source performantes, affinent les poids des modèles sur des serveurs sécurisés et déploient une infrastructure évolutive pour automatiser les flux de travail internes et protéger leur propriété intellectuelle sensible.
Dois-je créer un LLM de toutes pièces ou affiner un modèle existant ?
L'affinage (*fine-tuning*) de modèles de base existants permet d'économiser du temps et de l'argent tout en adaptant les capacités linguistiques pré-entraînées à des domaines spécifiques. L'entraînement à partir de zéro ne reste nécessaire que pour répondre à des exigences linguistiques ou de sécurité tout à fait uniques.
Quelles données sont nécessaires pour entraîner un modèle de langage personnalisé ?
Les ingénieurs rassemblent des documents internes propres, des manuels techniques, des transcriptions historiques et des enregistrements de bases de données structurées. Les équipes doivent supprimer les données personnelles identifiables et formater soigneusement le texte avant de l'injecter dans les pipelines d'entraînement.
Combien coûte le développement d'un LLM personnalisé ?
Les coûts varient en fonction du nombre de paramètres, de la location de matériel et de la main-d'œuvre nécessaire à la préparation des données. L'utilisation de clusters de GPU dans le cloud représente un investissement important, tandis que l'affinage d'adaptateurs existants réduit le budget global de mise en œuvre.
Quel LLM open source est le plus adapté aux entreprises ?
Meta Llama et Mistral AI offrent des performances exceptionnelles et des poids de modèle ouverts pour des déploiements locaux sécurisés. Les organisations choisissent des variantes spécifiques en fonction des limites de paramètres et des ressources de calcul disponibles.
Combien de temps faut-il pour créer un LLM personnalisé ?
Les délais varient de quelques semaines à plusieurs mois selon la complexité du jeu de données. Les déploiements progressifs et l'utilisation de modèles de base pré-entraînés accélèrent les calendriers de mise en service pour les équipes d'entreprise.
Les entreprises peuvent-elles créer des modèles d'IA privés ?
Les entreprises déploient des modèles sur des serveurs locaux ou au sein de sous-réseaux cloud privés sécurisés. Cela garantit une isolation totale des données et empêche les fournisseurs d'API externes d'accéder aux informations confidentielles de l'entreprise.
Quelle infrastructure est nécessaire pour le développement d'un LLM ?
L'apprentissage profond (*deep learning*) nécessite des clusters de GPU haute performance, un matériel réseau robuste et des bases de données vectorielles rapides. Les ingénieurs DevOps configurent des nœuds Kubernetes évolutifs pour gérer les charges de travail importantes liées à l'inférence.
Comment les entreprises déploient-elles des LLM personnalisés ?
Les équipes DevOps provisionnent des instances d'inférence dans le cloud ou des nœuds de serveurs locaux. Des passerelles API connectent les applications métier internes, tandis que des répartiteurs de charge (*load balancers*) distribuent efficacement le trafic des requêtes entrantes entre les serveurs.
Quels sont les avantages des LLM privés ?
Les modèles privés garantissent une confidentialité stricte des données, éliminent les frais d'abonnement par jeton (*token*) et fournissent des réponses précises et adaptées au secteur d'activité. Les organisations conservent un contrôle total sur les poids du modèle et les politiques de sécurité du système.
Qu'est-ce que le RAG et comment se compare-t-il à l'affinage (*fine-tuning*) ?
La génération augmentée par la récupération (RAG) récupère dynamiquement des documents externes en temps réel, sans modifier les poids fondamentaux du modèle. Le réglage fin (fine-tuning), quant à lui, modifie directement les paramètres du réseau de neurones pour adapter le vocabulaire et le comportement aux flux de travail de l'entreprise.
Quel est le niveau de sécurité des LLM d'entreprise ?
Les plateformes d'entreprise appliquent des contrôles d'accès stricts fondés sur les rôles, le chiffrement des données au repos et des politiques de non-conservation des données. Des audits de sécurité et des pare-feu locaux protègent les informations confidentielles contre les cybermenaces malveillantes.
Reconnue mondialement pour sa qualité et sa fiabilité incomparables


Témoignages : écoutez-le directement de nos clients à travers le monde
Nos processus de développement fournissent des solutions dynamiques pour relever les défis métiers, optimiser les coûts et accélérer la transformation numérique. Des solutions appuyées par des experts renforcent la fidélisation et la présence en ligne, tandis que des succès avérés mettent en avant la résolution de problèmes concrets grâce à des applications innovantes. Nos clients estimés à travers le monde l’ont déjà constaté.
Prix et Reconnaissances
Bien que les clients satisfaits soient notre plus grande motivation, la reconnaissance de l'industrie a une valeur significative. WeblineIndia a constamment été un leader en technologie, avec des prix et des distinctions réaffirmant notre excellence.
OA500 Entreprises mondiales d’externalisation 2025, par Outsource Accelerator
Meilleure entreprise de développement logiciel, par GoodFirms
Meilleure entreprise de solutions fintech – 2022, par GESIA
Récompensée comme – Meilleure entreprise de développement d’apps en Inde 2020, par SoftwareSuggest