Come creare un LLM personalizzato per la tua azienda
Scopri come creare un LLM personalizzato per la tua azienda seguendo un approccio passo dopo passo che comprende preparazione dei dati, selezione del modello di base, fine-tuning, RAG, infrastruttura, deployment, sicurezza, costi e casi d'uso aziendali.


 ChatGPT
 Perplexity
Creare un LLM personalizzato per la tua azienda significa individuare casi d’uso specifici, preparare dati pertinenti, scegliere la giusta architettura del modello e implementare processi efficaci di addestramento e test. Un LLM su misura può migliorare automazione, efficienza, esperienza dei clienti e capacità decisionale in tutte le attività aziendali.
Che cos’è un Large Language Model (LLM) personalizzato e perché le aziende ne hanno bisogno?
I modelli di intelligenza artificiale di base standard rispondono a richieste generiche rivolte al grande pubblico. Questi modelli generici non conoscono il contesto operativo specifico. Le organizzazioni si scontrano con lacune di accuratezza. I sistemi generici inventano dati aziendali (allucinazioni). Le aziende hanno bisogno di conoscenze specialistiche di dominio. Lo sviluppo di LLM personalizzati colma esattamente questo divario. I dati proprietari restano all’interno dell’azienda. I protocolli di sicurezza impediscono la fuga di dati verso l’esterno. Le organizzazioni realizzano un LLM aziendale per elaborare documenti sensibili.
I servizi di sviluppo AI personalizzati sono rivolti a flussi di lavoro specifici. I dipendenti caricano manuali tecnici interni. Il sistema apprende all’istante la terminologia proprietaria. Lo sviluppo di modelli linguistici di grandi dimensioni comporta un intenso lavoro di ottimizzazione dei parametri. Le aziende passano dagli strumenti pubblici a un’infrastruttura sicura. Le implementazioni di LLM privati garantiscono l’isolamento dei dati. Gli istituti finanziari elaborano in sicurezza documentazione riservata. Le strutture sanitarie proteggono con cura le cartelle cliniche dei pazienti.
I modelli standard falliscono nelle richieste tecniche. Lo sviluppo di GPT personalizzati risponde alle esigenze dei settori di nicchia. Le organizzazioni ricorrono allo sviluppo di modelli AI per automatizzare attività di scrittura complesse. I modelli AI aziendali comprendono le metriche interne. Le aziende adottano soluzioni LLM open source per mantenere la proprietà del codice. Questo approccio elimina i canoni di abbonamento a terze parti. I pesi proprietari restano su server locali. Un elevato controllo operativo dà forza ai team di ingegneria interni. L’infrastruttura AI richiede potenti cluster di calcolo. Gli ingegneri configurano nodi di elaborazione distribuiti.
Principali vantaggi della creazione di un LLM personalizzato per le applicazioni aziendali
Creare un Large Language Model (LLM) personalizzato consente alle organizzazioni di mantenere la sicurezza dei dati proprietari, ridurre drasticamente le allucinazioni grazie al fine-tuning specifico per il dominio e automatizzare senza attriti flussi di lavoro interni complessi.
Vediamo perché adattare un modello AI ai dati della tua organizzazione sblocca un’efficienza operativa senza pari e un vero vantaggio competitivo negli ambienti aziendali moderni.
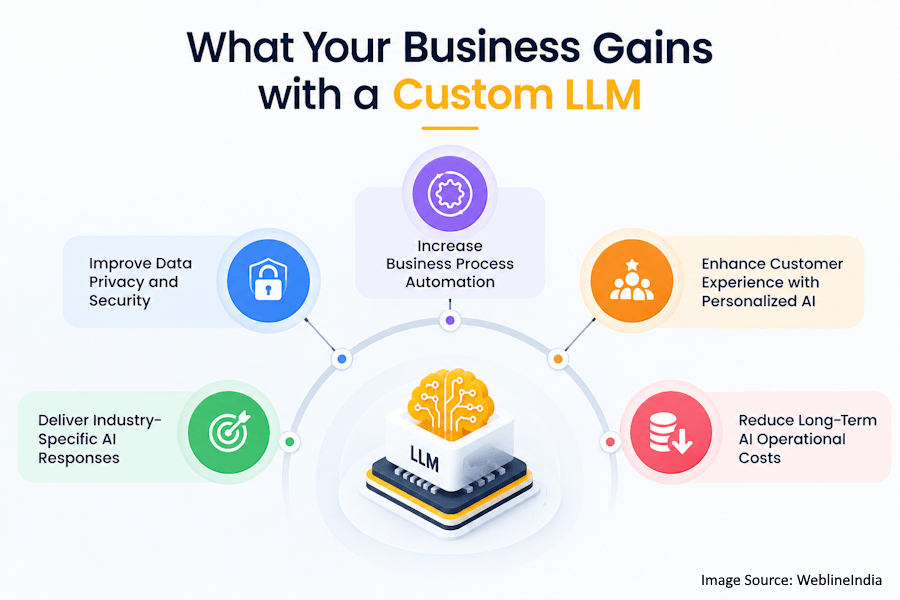
Migliorare la privacy e la sicurezza dei dati
Le piattaforme di intelligenza artificiale pubbliche conservano gli input degli utenti. I server esterni acquisiscono segreti aziendali proprietari. Le aziende rischiano pesanti sanzioni normative. I servizi di sviluppo di modelli AI personalizzati eliminano i rischi del cloud pubblico. I dati restano all’interno di data center locali. I team di sicurezza cifrano le informazioni a riposo. I dipendenti condividono report riservati in sicurezza. I responsabili della conformità impongono controlli di accesso rigorosi. Lo sviluppo di LLM privati protegge la proprietà intellettuale.
- I server aziendali conservano localmente i log dei prompt.
- I fornitori di API esterni non vedono mai i dati interni.
- Gli ingegneri della sicurezza configurano regole firewall rigorose.
Fornire risposte AI specifiche per il settore
I modelli generici fraintendono il gergo tecnico. I domini specialistici richiedono un vocabolario preciso. I servizi di sviluppo LLM personalizzati addestrano i modelli su dataset di nicchia. Gli ingegneri utilizzano il fine-tuning di un LLM per raggiungere l’accuratezza richiesta dal business. Gli studi legali caricano archivi di giurisprudenza. I ricercatori medici elaborano note di studi clinici. Il sistema produce la terminologia corretta.
- Le banche dati legali alimentano pipeline di addestramento specializzate con documenti storici.
- Le riviste mediche migliorano l’accuratezza delle interrogazioni cliniche per la diagnostica ospedaliera.
- I team di ingegneria integrano i progetti tecnici per guidare i motori di ragionamento tecnico.
Aumentare l’automazione dei processi aziendali
La classificazione manuale dei documenti sottrae ore di lavoro. Gli LLM possono anche integrare i servizi di automazione dei processi aziendali, supportando flussi di lavoro come l’elaborazione di documenti, lo smistamento dei ticket e l’estrazione di informazioni. I sistemi instradano all’istante i ticket di assistenza in arrivo. I servizi di sviluppo AI aziendale possono supportare architetture progettate per mantenere i dati aziendali sensibili all’interno di ambienti controllati. Gli algoritmi estraggono dati da fatture non strutturate. I modelli AI aziendali eseguono logiche di business in più passaggi.
- L’elaborazione automatica delle fatture fa risparmiare ai reparti contabili centinaia di ore di lavoro manuale ogni mese.
- I chatbot di supporto risolvono i ticket tecnici all’istante consultando le wiki interne di risoluzione dei problemi.
- I sistemi logistici analizzano automaticamente le distinte di spedizione per aggiornare i database di magazzino.
- Gli errori di inserimento dati diminuiscono sensibilmente in tutti i reparti aziendali.
Migliorare l’esperienza del cliente con un’AI personalizzata
Le risposte generiche frustrano i clienti. I clienti pretendono un’assistenza contestualizzata. Lo sviluppo di modelli AI aziendali integra i database con lo storico dei clienti. La piattaforma ricorda gli acquisti passati. Gli operatori dell’assistenza risolvono i problemi più rapidamente. La fedeltà al marchio cresce in modo costante.
- I motori di raccomandazione analizzano il comportamento d’acquisto passato per suggerire articoli pertinenti.
- I chatbot fanno riferimento al livello di abbonamento di ciascun cliente per fornire un supporto accurato sull’account.
Ridurre i costi operativi dell’AI a lungo termine
I token delle API esterne accumulano costi elevati. Il traffico aziendale ad alto volume fa lievitare le fatture mensili. Le aziende addestrano un proprio modello linguistico per evitare le tariffe per token. I costi fissi dell’hardware sostituiscono la fatturazione variabile delle API. Le organizzazioni gestiscono i budget in modo prevedibile.
- I costi fissi dell’infrastruttura sostituiscono le fatture API che crescono nei periodi di traffico elevato.
- Volumi elevati di query costano meno su GPU aziendali locali nel tempo.
- I team interni ottimizzano autonomamente le velocità di inferenza, senza i limiti delle piattaforme di terze parti.
- L’allocazione delle risorse segue in modo efficiente i picchi di domanda del business.
Trasforma i dati della tua azienda in una soluzione AI sicura e specifica per il tuo dominio, costruita attorno ai tuoi flussi di lavoro, ai tuoi utenti e ai requisiti aziendali.
LLM personalizzato o LLM pre-addestrato: quale modello AI è giusto per la tua azienda?
I modelli pre-addestrati offrono capacità immediate e convenienti per attività generali, mentre i modelli personalizzati garantiscono sicurezza e precisione senza pari, calibrate esattamente sul gergo specifico del tuo settore.
Immergiamoci in un confronto completo per stabilire quale strada strategica sia più in linea con i tuoi obiettivi aziendali a lungo termine.
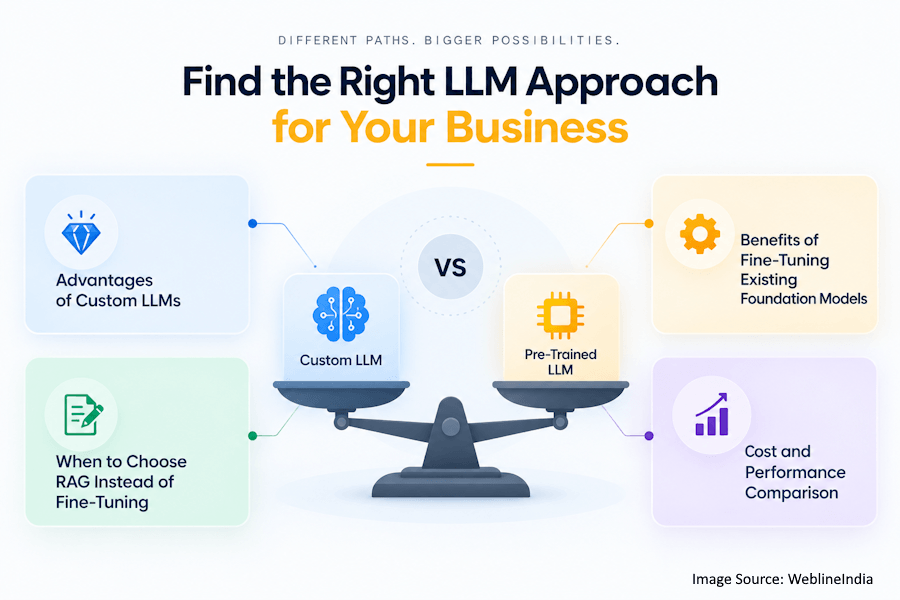
Vantaggi degli LLM personalizzati
Le organizzazioni possiedono i pesi del proprio modello. Gli ingegneri modificano direttamente i livelli della rete neurale. Lo sviluppo di LLM personalizzati offre un controllo architetturale senza pari. Gli algoritmi proprietari proteggono i vantaggi competitivi. Le politiche di sicurezza impongono regole di zero conservazione dei dati. Le prestazioni si adattano esattamente ai carichi di lavoro aziendali.
- La proprietà totale evita le trappole del vendor lock-in e le variazioni arbitrarie di prezzo.
- I parametri di fine-tuning si adattano con grande precisione ai domini industriali di nicchia.
- La velocità di inferenza si ottimizza per specifiche configurazioni hardware nei data center locali.
Vantaggi del fine-tuning dei modelli di base esistenti
Costruire da zero costa milioni. I servizi di fine-tuning di modelli AI possono ridurre la necessità di un addestramento da zero adattando i modelli di base esistenti ai requisiti di un dominio specifico. I modelli esistenti offrono una solida base grammaticale. I dataset di dominio adattano i pesi pre-addestrati. I cicli di addestramento si concludono in pochi giorni. Gli ingegneri sfruttano i framework open source per lo sviluppo di LLM.
- I pesi pre-addestrati offrono rapidamente una competenza di base senza un lungo addestramento da zero.
- I costi computazionali restano inferiori a quelli di un addestramento completo da milioni di dollari.
- I dataset specializzati orientano le capacità generali di ragionamento verso specifiche attività aziendali.
- I tempi di sviluppo si riducono da anni a settimane.
Quando scegliere il RAG invece del fine-tuning
L’addestramento modifica i pesi centrali del modello. La Retrieval-Augmented Generation (generazione aumentata dal recupero) lascia i pesi intatti. Le aziende aggiornano ogni giorno le basi di conoscenza esterne. I sistemi RAG recuperano i documenti in modo dinamico. Gli ingegneri scelgono il RAG per le wiki che cambiano di frequente. I costi di sviluppo restano minimi.
- Gli aggiornamenti dinamici dei documenti non richiedono cicli di riaddestramento né aggiornamenti dei pesi.
- I database vettoriali esterni conservano le wiki aziendali aggiornate per un recupero immediato.
Confronto tra costi e prestazioni
Le architetture personalizzate richiedono enormi cluster di calcolo. Il fine-tuning dei modelli di base richiede un noleggio GPU moderato. Le architetture RAG si basano su ricerche vettoriali veloci. I responsabili finanziari calcolano con precisione il ritorno sull’investimento. I benchmark delle prestazioni guidano la scelta dell’architettura.
- Il pre-addestramento personalizzato comporta costi di calcolo da milioni di dollari per le sessioni di addestramento complete.
- Il fine-tuning richiede budget GPU cloud contenuti per l’aggiornamento dei pesi degli adapter.
- Le implementazioni RAG ottimizzano i costi di archiviazione dei database mantenendo un’elevata accuratezza dei fatti.
- Le metriche di latenza guidano le scelte finali di distribuzione in produzione tra le diverse unità di business.
Processo passo passo per creare un LLM personalizzato per la tua azienda
Creare un LLM personalizzato significa definire casi d’uso aziendali specifici, raccogliere e ripulire i dati proprietari, scegliere il modello di base più adatto, eseguire il fine-tuning con un addestramento specializzato e valutare con rigore le prestazioni prima della distribuzione aziendale sicura.
Esploriamo ogni fase nel dettaglio per vedere come questa roadmap strutturata garantisca il successo della tua implementazione AI.
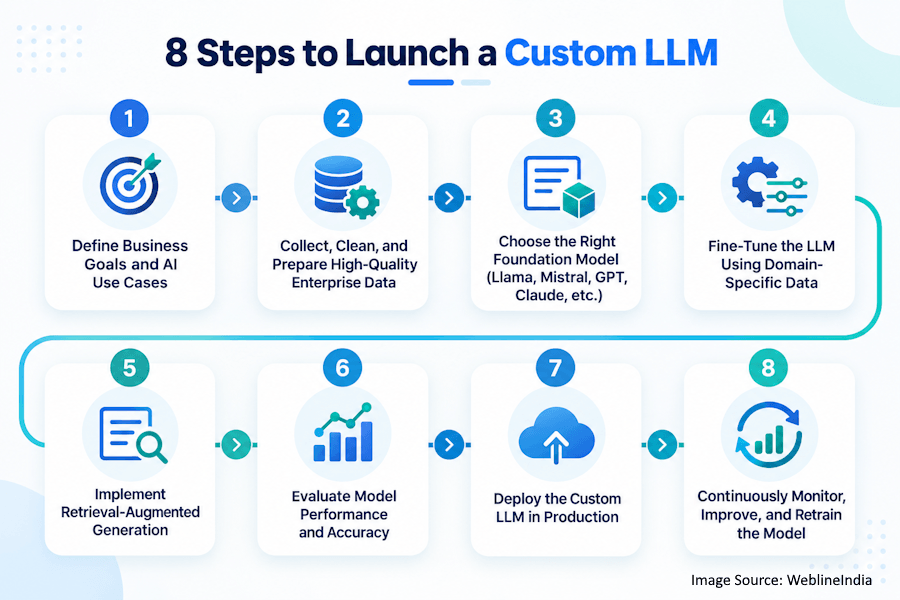
Definire gli obiettivi di business e i casi d’uso dell’AI
I dirigenti individuano con precisione i colli di bottiglia operativi. Gli ingegneri isolano le attività manuali ripetitive. I project manager definiscono le metriche di successo. Obiettivi chiari evitano lo spreco di risorse di calcolo. Gli stakeholder rivedono con attenzione i documenti di allineamento.
Raccogliere, ripulire e preparare dati aziendali di alta qualità
I dati aziendali grezzi contengono errori di formattazione. Gli ingegneri eliminano senza pietà i record duplicati. I parser di testo rimuovono gli identificatori personali sensibili. I dataset puliti alimentano le pipeline di addestramento. L’alta qualità dei dati garantisce output affidabili.
- I data engineer estraggono il testo grezzo dai database aziendali legacy.
- Script automatici rimuovono dai documenti le codifiche di caratteri corrotte.
- La rimozione dei dati personali (PII) tutela la privacy dei dipendenti prima dell’inizio dell’addestramento.
- File JSON formattati organizzano correttamente i campioni di addestramento per i modelli.
Scegliere il giusto modello di base (Llama, Mistral, GPT, Claude, ecc.)
La scelta del modello determina il successo nelle fasi successive. Gli ingegneri testano più architetture di base. I pesi aperti offrono libertà di distribuzione locale. I modelli proprietari forniscono solide basi di ragionamento. Gli accordi di licenza stabiliscono i diritti di utilizzo commerciale.
- I test di benchmark valutano le velocità di ragionamento di base di vari modelli candidati.
- I termini di licenza consentono la distribuzione aziendale commerciale senza rischi legali.
Eseguire il fine-tuning dell’LLM con dati specifici del dominio
Adapter specializzati modificano il comportamento del modello, mentre i servizi di sviluppo di machine learning possono supportare l’intero flusso di addestramento, validazione e ingegneria del modello. Le curve di perdita scendono nel corso delle iterazioni per epoca. Gli ingegneri convalidano gli output su set di test. I pesi finali vengono salvati in repository sicuri.
- Gli adapter LoRA riducono al minimo il numero di parametri attivi addestrati durante il fine-tuning.
- I cluster GPU elaborano in modo efficiente terabyte di testo di dominio.
- Le metriche di perdita monitorano i tassi di convergenza durante le epoche di addestramento.
Implementare la Retrieval-Augmented Generation
Gli splitter di testo suddividono in blocchi i lunghi report aziendali. I modelli di embedding trasformano il testo in vettori. I database vettoriali indicizzano le informazioni semantiche. Gli algoritmi di ricerca recuperano il contesto documentale pertinente. I prompt combinano i fatti recuperati con le domande.
- Il chunking del testo divide in modo efficiente i manuali voluminosi in segmenti più piccoli.
- I modelli di embedding traducono le parole in vettori numerici per l’indicizzazione.
- I database vettoriali archiviano indici semantici multidimensionali per interrogazioni rapide.
- L’iniezione del contesto ancora le risposte del modello a fatti verificati.
Valutare le prestazioni e l’accuratezza del modello
Script di test automatici misurano la qualità delle risposte. Revisori umani valutano gli output soggettivi. Le suite di benchmark mettono alla prova i limiti del ragionamento. I filtri di sicurezza verificano le vulnerabilità alla prompt injection. Punteggi scadenti attivano un riaddestramento immediato.
- Script di valutazione automatici eseguono suite di benchmark sugli output.
- Esperti umani valutano manualmente l’accuratezza di dominio per una revisione qualitativa.
Distribuire l’LLM personalizzato in produzione
I servizi DevOps possono supportare il provisioning di server di inferenza in cloud, pipeline di distribuzione e ambienti di produzione scalabili per LLM personalizzati. I bilanciatori di carico distribuiscono il traffico utente in arrivo. Gli endpoint API collegano le applicazioni interne. Gli strumenti di monitoraggio tengono sotto controllo lo stato del sistema. Gli ambienti di produzione garantiscono un’elevata disponibilità.
- I cluster Kubernetes scalano automaticamente i nodi di inferenza durante i picchi di traffico.
- I gateway API gestiscono in sicurezza i token di autenticazione degli utenti aziendali.
- I bilanciatori di carico distribuiscono senza intoppi il traffico di richieste intenso tra i server.
- I meccanismi di fallback evitano fermi imprevisti del sistema durante la manutenzione.
Monitorare, migliorare e riaddestrare continuamente il modello
Il feedback degli utenti evidenzia i malfunzionamenti operativi. Le pipeline di logging registrano le risposte errate. I data scientist selezionano nuovi campioni di addestramento. Il riaddestramento programmato aggiorna i pesi del modello. I sistemi aziendali evolvono insieme alle esigenze del business.
- I pulsanti di feedback raccolgono subito dopo la generazione le valutazioni degli utenti.
- I sistemi di logging segnalano per la revisione gli episodi ricorrenti di allucinazione.
- Le pipeline di dati acquisiscono ogni settimana le politiche aziendali aggiornate.
- I cicli di riaddestramento programmati mantengono l’intelligenza al passo con i mercati.
Pronto a trasformare la tua roadmap LLM in una soluzione pronta per la produzione? I nostri ingegneri AI possono aiutarti a realizzarla, ottimizzarla, distribuirla e scalarla.
Scegliere il miglior modello di base per lo sviluppo di un LLM personalizzato
Scegliere un modello di base ottimale richiede di bilanciare parametri cruciali come il carico computazionale, i vincoli di licenza dell’architettura, le prestazioni di base nel dominio e i requisiti di latenza di inferenza rispetto ai vincoli tecnici specifici della tua organizzazione.
Analizziamo come valutare in modo sistematico queste variabili architetturali per individuare il modello che massimizza sia le capacità sia l’efficienza dei costi.
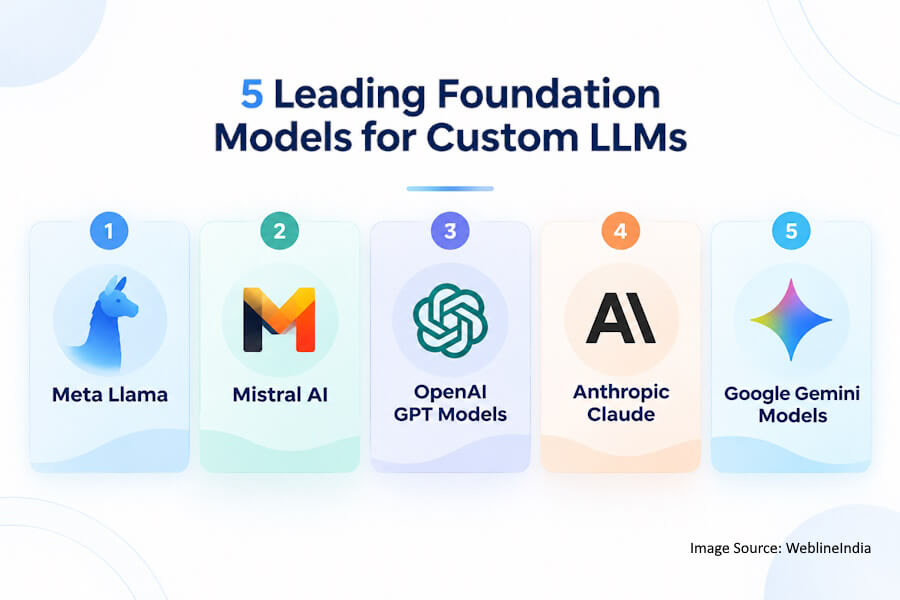
Meta Llama
I pesi aperti attirano gli sviluppatori aziendali. La distribuzione locale garantisce la sicurezza dei dati. Il fine-tuning dei modelli Llama richiede hardware standard. I forum della community offrono ampie guide per la risoluzione dei problemi.
- I pesi open source consentono la distribuzione su server locali protetti da firewall.
- Le dimensioni dei parametri vanno dalle configurazioni più piccole a quelle aziendali di grandi dimensioni.
Mistral AI
L’ingegneria europea punta a un’elevata efficienza. I modelli compatti garantiscono velocità di inferenza rapide. I clienti aziendali ottengono in licenza varianti proprietarie dei pesi. I progetti architetturali ottimizzano il consumo di memoria.
- L’architettura efficiente riduce in modo significativo il carico computazionale operativo.
- Le dimensioni compatte dei modelli accelerano i tempi di generazione delle risposte per gli utenti.
- Solidi benchmark di ragionamento rivaleggiano con i concorrenti più grandi del settore.
- Licenze flessibili adatte a diverse strutture aziendali commerciali.
Modelli GPT di OpenAI
Le API proprietarie offrono solide basi di ragionamento. Gli sviluppatori evitano di gestire cluster di infrastruttura. Gli aggiornamenti regolari introducono funzionalità avanzate. Le policy sulla privacy proteggono i dati dei clienti aziendali.
- Le API gestite eliminano le attività di manutenzione dell’infrastruttura per i team interni.
- Il ragionamento avanzato risolve con facilità problemi logici complessi senza bisogno di tuning.
Anthropic Claude
Le finestre di contesto lunghe elaborano interi libri. Le protezioni di sicurezza riducono al minimo gli output tossici. I clienti aziendali integrano endpoint API sicuri. Gli analisti finanziari elaborano direttamente grandi fogli di calcolo.
- Le enormi finestre di contesto acquisiscono interi codebase e report fitti.
- La sicurezza costituzionale integrata riduce gli output dannosi o tossici.
- L’analisi dei documenti estrae dati strutturati da pagine finanziarie dense.
Modelli Google Gemini
Le capacità multimodali elaborano testo e video. L’infrastruttura cloud integra strumenti AI nativi. Le funzioni di ricerca aziendale collegano le unità interne. Le architetture scalabili gestiscono carichi di lavoro pesanti.
- La multimodalità nativa elabora direttamente immagini e flussi video.
- L’integrazione con Google Cloud semplifica le pipeline di distribuzione aziendali.
Infrastruttura e stack tecnologico necessari per lo sviluppo di un LLM personalizzato
Sviluppare un LLM personalizzato solido richiede cluster di calcolo ad alte prestazioni dotati di GPU specializzate, pipeline di dati scalabili, framework di orchestrazione aziendali e database vettoriali sicuri per la retrieval-augmented generation.
Esaminiamo l’architettura tecnica essenziale per alimentare in modo efficace la tua infrastruttura AI aziendale.
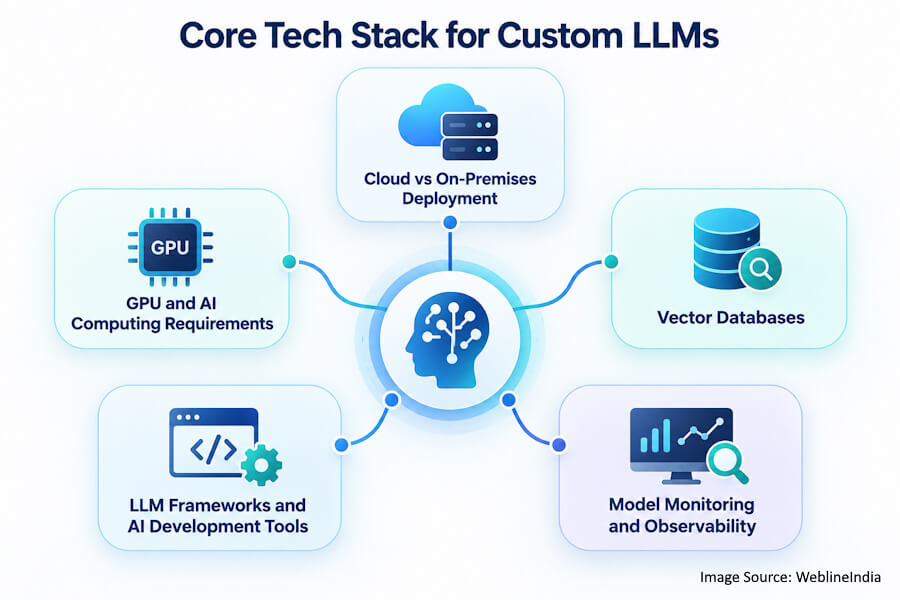
Distribuzione in cloud o on-premises
I provider cloud offrono una scalabilità elastica delle GPU. I server on-premises proteggono segreti altamente riservati. Le normative finanziarie dettano le regole sulla collocazione dell’hardware. Le architetture ibride bilanciano costi e sicurezza.
Requisiti di GPU e di calcolo per l’AI
Il deep learning richiede chip acceleratori specializzati. Un’elevata capacità di VRAM consente di caricare modelli di grandi dimensioni. Le velocità di interconnessione accelerano le attività di addestramento distribuito. Il consumo energetico incide sui budget dei data center.
- I cluster NVIDIA H100 riducono drasticamente i tempi di addestramento dei modelli.
- Elevate capacità di VRAM caricano in sicurezza enormi pesi di parametri.
- Le interconnessioni ad alta velocità collegano più nodi di addestramento senza latenza.
Database vettoriali
Gli embedding richiedono soluzioni di archiviazione specializzate. Le ricerche per similarità recuperano i blocchi di documenti corrispondenti. Le architetture scalabili gestiscono miliardi di vettori. La velocità di indicizzazione incide sulla latenza delle query.
- Pinecone gestisce in modo efficiente indici di ricerca vettoriale nativi per il cloud.
- Milvus scala senza problemi su cluster di server locali distribuiti.
- Qdrant gestisce operazioni rapide di filtraggio dei metadati durante la ricerca.
Framework LLM e strumenti di sviluppo AI
Le librerie Python semplificano la costruzione delle pipeline. Gli strumenti di orchestrazione concatenano passaggi complessi degli agenti. I pacchetti di quantizzazione riducono l’ingombro in memoria dei modelli. Gli strumenti di containerizzazione standardizzano gli ambienti di distribuzione.
- LangChain orchestra flussi di lavoro complessi e multi-step di agenti di intelligenza artificiale.
- LlamaIndex collega documenti esterni ai modelli per il RAG.
Monitoraggio dei modelli e osservabilità
Le metriche tengono traccia dei tassi di consumo di token. Il logging degli errori mette in luce i punti di guasto dei prompt. Il rilevamento del drift individua i trend di calo dell’accuratezza. Gli scanner di sicurezza bloccano gli input dannosi.
- Le dashboard Grafana mostrano in tempo reale le metriche di utilizzo delle risorse di sistema.
- Gli strumenti di logging registrano le tracce degli errori dei prompt utente per l’analisi.
- I monitor di drift avvisano gli ingegneri dei cali di prestazioni.
- I filtri di sicurezza bloccano i tentativi non autorizzati di prompt injection.
Sfide comuni nello sviluppo di LLM personalizzati e come superarle
Lo sviluppo di LLM personalizzati comporta spesso ostacoli come costi computazionali alle stelle, rischi per la privacy dei dati, dimenticanza catastrofica durante il fine-tuning e gestione del drift del modello nel tempo.
Scopriamo le strategie di mitigazione collaudate necessarie per superare con successo questi comuni ostacoli tecnici.
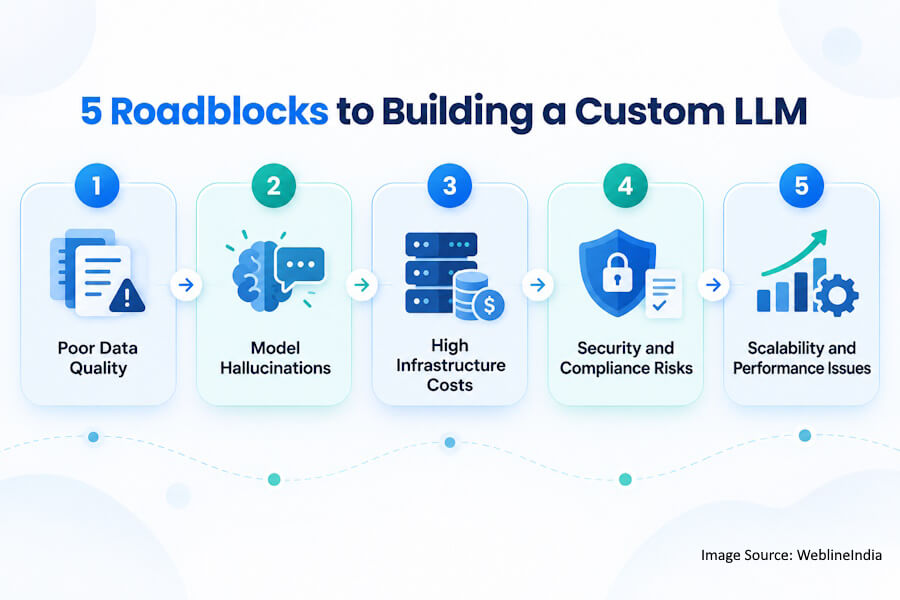
Scarsa qualità dei dati
I documenti incompleti causano un comportamento irregolare del modello. Le pipeline di pulizia dei dati eliminano il rumore. Script di validazione automatici controllano i formati del testo. Revisori umani verificano l’integrità del dataset.
- Le sezioni mancanti nei documenti creano lacune di ragionamento logico durante l’addestramento.
- Script regex automatici eliminano dai file i caratteri di testo corrotti.
Allucinazioni del modello
I modelli inventano fatti storici falsi. Le architetture RAG ancorano le risposte alla verità. Impostazioni di temperatura rigorose riducono l’invenzione creativa. Le suite di valutazione individuano tempestivamente gli errori.
- I prompt di ancoraggio limitano rigorosamente le risposte ai documenti di origine forniti.
- Le impostazioni di temperatura basse riducono la generazione casuale di output.
- L’obbligo di citazione costringe i modelli a fare riferimento alle fonti dei documenti.
Costi elevati dell’infrastruttura
Il noleggio delle GPU prosciuga i budget aziendali. La quantizzazione dei modelli riduce l’ingombro in memoria. Modelli più piccoli sostituiscono i grandi sistemi di base. Un batching efficiente massimizza l’utilizzo dell’hardware.
- La quantizzazione dei modelli dimezza le dimensioni dei file senza perdita di qualità.
- Le istanze GPU spot riducono in modo significativo i costi di noleggio del cloud computing.
- Il batching delle richieste massimizza l’utilizzo della capacità di calcolo hardware attiva.
Rischi per la sicurezza e la conformità
Le fughe di dati comportano sanzioni normative. I protocolli di cifratura proteggono i file archiviati. Le liste di controllo degli accessi limitano i permessi degli utenti. Audit periodici verificano l’integrità del sistema.
- Gli standard di cifratura proteggono i file durante i trasferimenti sulla rete interna.
- L’accesso basato sui ruoli limita la visibilità dei documenti sensibili tra i reparti.
- Gli audit di conformità verificano il rispetto dei quadri normativi di settore.
- I penetration test individuano vulnerabilità di sicurezza nascoste nelle applicazioni.
Problemi di scalabilità e prestazioni
L’elevato traffico di utenti provoca colli di bottiglia sui server. I bilanciatori di carico distribuiscono le richieste in arrivo. I livelli di caching memorizzano i risultati delle query frequenti. Le code asincrone gestiscono i carichi di lavoro pesanti.
- I bilanciatori di carico evitano crash per sovraccarico di un singolo server durante i picchi di traffico.
- Il caching delle risposte serve all’istante query identiche senza eseguire l’inferenza.
Quanto costa creare un LLM personalizzato per la tua azienda?
Realizzare un LLM aziendale personalizzato comporta impegni finanziari variabili, che vanno da semplici configurazioni API a pipeline di addestramento ad alto consumo di risorse. Le organizzazioni devono tenere conto dei costi di calcolo GPU, delle pipeline di preparazione dei dati, dei talenti ingegneristici specializzati e dei costi di manutenzione a lungo termine.
Analizziamo le variabili finanziarie reali e le stime di budget per aiutarti a pianificare una strategia di investimento accurata per il tuo prossimo progetto di intelligenza artificiale aziendale.
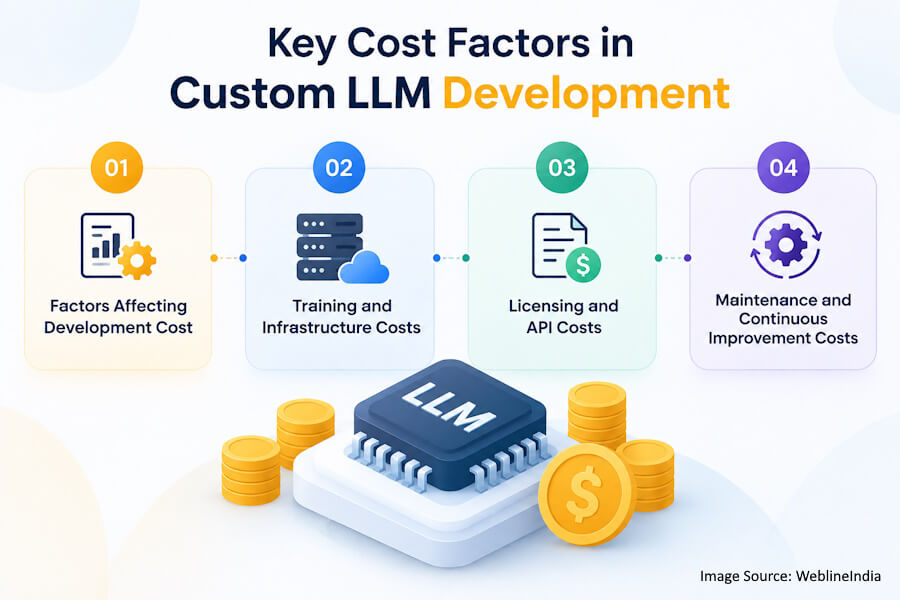
Fattori che influenzano il costo di sviluppo
La dimensione del dataset incide sul lavoro di preparazione dei dati, mentre il numero di parametri del modello determina le esigenze hardware. I servizi di consulenza AI possono aiutare le organizzazioni a valutare la complessità dell’integrazione, i requisiti infrastrutturali e gli altri fattori che influenzano la portata del progetto.
- I dataset di grandi dimensioni richiedono lunghi tempi di pulizia manuale da parte degli ingegneri.
- I modelli con molti parametri richiedono hardware GPU di fascia alta e costoso.
Costi di addestramento e infrastruttura
I cluster di calcolo richiedono finanziamenti considerevoli. Le bollette elettriche aggiungono spese operative continue. I provider cloud applicano tariffe orarie per le GPU. L’acquisto di hardware richiede capitale iniziale.
- Il noleggio orario di GPU in cloud si accumula rapidamente durante le sessioni di addestramento.
- Il carico di alimentazione e raffreddamento aumenta i budget delle strutture che ospitano i server.
- La configurazione del cluster richiede costose apparecchiature di rete ad alta velocità.
- I contratti di manutenzione coprono guasti imprevisti dei componenti hardware dei server.
Costi di licenza e API
I modelli di base proprietari prevedono canoni di abbonamento. Le autorizzazioni per l’uso commerciale comportano costi aggiuntivi. I pesi open source eliminano le spese di licenza ricorrenti. Le verifiche legali garantiscono la conformità.
- I token delle API commerciali accumulano addebiti mensili in base al volume.
- Gli abbonamenti ai modelli proprietari crescono con il numero di utenti attivi.
- I pesi open source evitano l’onere dei canoni di licenza software ricorrenti.
Costi di manutenzione e miglioramento continuo
I modelli richiedono cicli di riaddestramento continui. I team di ingegneria correggono i bug operativi. Le patch di sicurezza proteggono i server dell’infrastruttura. Gli strumenti di monitoraggio comportano canoni di abbonamento.
- Le pipeline di riaddestramento acquisiscono con regolarità i documenti aziendali aggiornati.
- Gli ingegneri di supporto analizzano ogni giorno i log di errori imprevisti in produzione.
- I team di sicurezza applicano patch software ai server aziendali.
- Gli strumenti di osservabilità addebitano costi in base ai volumi di dati di log.
Ottieni una stima realistica per il tuo LLM personalizzato, in base a caso d’uso, dati, scelta del modello, integrazioni, infrastruttura e requisiti di distribuzione.
Best practice per creare LLM aziendali sicuri, accurati e scalabili
Implementare LLM aziendali solidi richiede di applicare una cifratura rigorosa dei dati, di stabilire cicli di feedback continui per ridurre le allucinazioni e di progettare architetture a scalabilità orizzontale in grado di gestire i picchi di carico.
Esploriamo le strategie di distribuzione fondamentali che garantiscono un ecosistema AI protetto, estremamente preciso e adattabile senza limiti alla futura crescita dell’organizzazione.
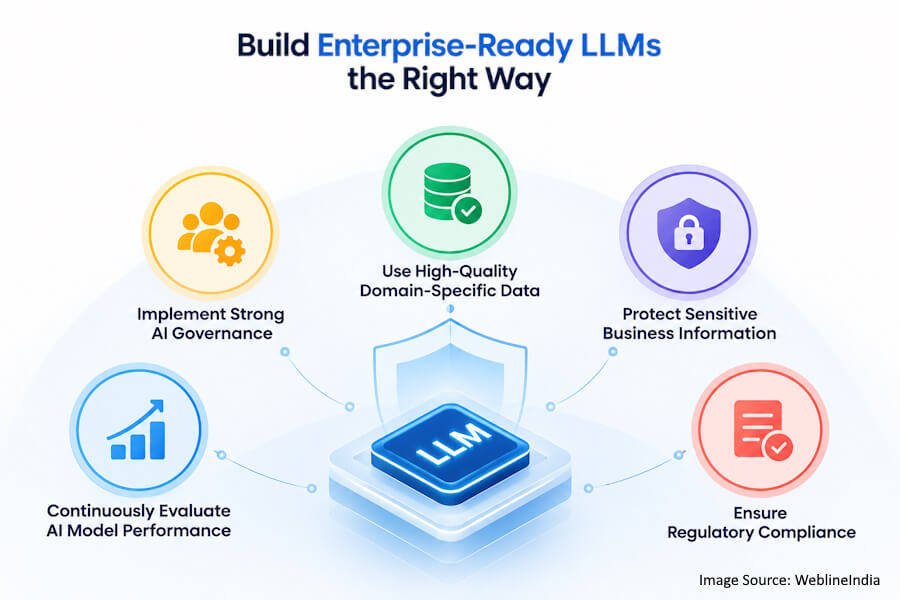
Implementare una solida governance dell’AI
Comitati supervisionano i progetti di intelligenza artificiale. Le linee guida etiche prevengono output distorti. Il controllo di versione traccia gli aggiornamenti del modello. La documentazione registra le decisioni architetturali.
Utilizzare dati di alta qualità specifici del dominio
I dataset curati migliorano l’accuratezza degli output. La rimozione del rumore elimina il testo fuorviante. I formati standardizzati semplificano le pipeline di addestramento. Audit periodici mantengono sana la base di dati.
- I dataset curati forniscono ai modelli segnali di apprendimento semantico chiari.
- La riduzione del rumore filtra completamente il testo irrilevante proveniente da internet.
- Gli schemi standardizzati organizzano correttamente documenti aziendali provenienti da più fonti.
Proteggere le informazioni aziendali sensibili
Il data masking nasconde i numeri riservati. I server locali isolano i file proprietari. Le policy di zero conservazione tutelano la privacy degli utenti. I firewall di rete bloccano le minacce esterne.
- Il data masking sostituisce i nomi reali con segnaposto sicuri.
- Le distribuzioni su server locali isolano i file dalle reti pubbliche.
- Gli accordi di zero conservazione dei dati tutelano rigorosamente la riservatezza dei prompt aziendali.
- I firewall di rete bloccano i tentativi di intrusione esterna non autorizzati.
Valutare continuamente le prestazioni del modello AI
I benchmark automatici misurano l’andamento dell’accuratezza. Il feedback degli utenti segnala problemi operativi. Il red teaming scopre vulnerabilità nascoste. Revisioni periodiche aggiornano gli obiettivi di prestazione.
- Script di test automatici monitorano nel tempo l’andamento delle metriche di accuratezza.
- I pulsanti di valutazione per gli utenti raccolgono subito feedback sulle prestazioni reali.
Garantire la conformità normativa
I team legali rivedono le pratiche di gestione dei dati. Le linee guida GDPR tutelano la privacy dei clienti. Gli standard di settore stabiliscono i controlli di sicurezza. La documentazione dimostra il rispetto delle norme.
- Le verifiche legali garantiscono il rispetto delle rigorose leggi sulla privacy dei dati.
- I protocolli GDPR gestiscono il consenso degli utenti e le richieste di cancellazione dei dati.
- Gli standard di settore impongono specifiche lunghezze minime per le chiavi di cifratura.
Casi d’uso aziendali reali dello sviluppo di LLM personalizzati nei diversi settori
Gli LLM personalizzati trasformano i settori automatizzando l’analisi di documenti legali complessi nella finanza, alimentando suggerimenti diagnostici iperpersonalizzati nella sanità e guidando una logistica di magazzino mirata nel retail. Scopri come le organizzazioni di settori diversi sfruttano questi sistemi su misura per ottimizzare i flussi di lavoro, ridurre drasticamente i costi generali e ottenere un enorme vantaggio competitivo.
Sanità
I modelli clinici riassumono le storie cliniche dei pazienti. I ricercatori medici analizzano gli studi sulle interazioni tra farmaci. Gli assistenti diagnostici elaborano le note delle scansioni. I flussi di lavoro amministrativi velocizzano la fatturazione.
- I modelli clinici riassumono per i medici storie cliniche dei pazienti molto dense.
- Gli strumenti di ricerca analizzano rapidamente studi complessi sulle interazioni tra farmaci.
Banche e servizi finanziari
Gli algoritmi di rilevamento delle frodi analizzano i flussi di transazioni. I trader algoritmici elaborano i report di mercato. I sistemi di conformità esaminano le richieste di prestito. Gli agenti automatici rispondono alle domande sui conti.
- Gli algoritmi di rilevamento delle frodi segnalano all’istante i flussi di transazioni sospette.
- I modelli finanziari analizzano i report sugli utili per gli investitori aziendali.
- Gli strumenti di conformità esaminano con cura i fattori di rischio delle richieste di prestito.
- Gli assistenti automatici rispondono alle domande di routine dei clienti sui conti 24 ore su 24, 7 giorni su 7.
Legale
Gli analizzatori di contratti individuano le clausole sfavorevoli. I motori di ricerca di giurisprudenza recuperano i precedenti. I riassuntori di documenti esaminano le deposizioni. Le pipeline di due diligence elaborano le fusioni.
- Gli analizzatori di contratti evidenziano all’istante le clausole di responsabilità sfavorevoli.
- I motori di ricerca legali recuperano precedenti giurisprudenziali storici pertinenti.
Manifattura
I modelli della supply chain prevedono le carenze di materiali. I registri di manutenzione programmano le riparazioni dei macchinari. I sistemi di controllo qualità analizzano i report sui difetti. Gli assistenti di progettazione esaminano i progetti tecnici.
- I modelli della supply chain prevedono per tempo i rischi di carenza di materie prime.
- I registri di manutenzione programmano riparazioni proattive dei macchinari di fabbrica.
- I sistemi di controllo qualità analizzano i report sui difetti di assemblaggio.
- Gli assistenti di progettazione esaminano complessi progetti tecnici di ingegneria.
Retail ed eCommerce
I motori di raccomandazione suggeriscono prodotti pertinenti. I modelli di magazzino prevedono la domanda stagionale. I chatbot multilingue assistono i clienti di tutto il mondo. Gli analizzatori del sentiment esaminano i feedback.
- I motori di raccomandazione suggeriscono prodotti pertinenti agli acquirenti online.
- I modelli di magazzino prevedono con precisione la domanda stagionale di scorte.
Assistenza clienti
I sistemi di ticketing instradano automaticamente le richieste. I sistemi di analisi del sentiment danno priorità ai clienti irritati. Le basi di conoscenza generano risposte immediate. Gli assistenti alla risposta redigono repliche cortesi.
- I sistemi di ticketing instradano le richieste dei clienti agli operatori appropriati.
- I sistemi di analisi del sentiment danno priorità alle code di assistenza dei clienti irritati.
- Le basi di conoscenza generano risposte immediate per gli utenti.
- Gli assistenti alla risposta redigono email di risposta cortesi per i clienti.
Come scegliere la giusta azienda di sviluppo di LLM personalizzati per la tua impresa
Valutare i potenziali partner per lo sviluppo di LLM personalizzati richiede di analizzare il loro portfolio di modelli aziendali già distribuiti, la competenza tecnica nei framework di fine-tuning, i protocolli di sicurezza dei dati e le capacità di manutenzione post-lancio.
Vediamo ora i criteri di valutazione fondamentali per scegliere un fornitore tecnologico affidabile, in grado di trasformare con successo la tua ambiziosa visione di intelligenza artificiale in una realtà aziendale sicura e pronta per la produzione.
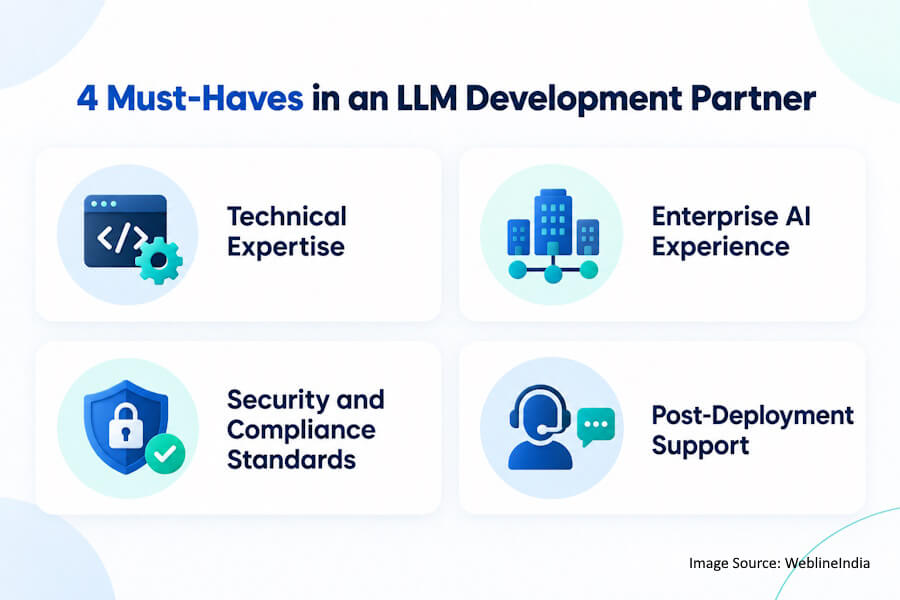
Competenza tecnica
Gli ingegneri valutano le credenziali di deep learning. I team dimostrano distribuzioni di modelli andate a buon fine. Le certificazioni attestano la competenza sull’infrastruttura cloud. I portfolio mettono in evidenza soluzioni aziendali complesse.
Esperienza nell’AI aziendale
I fornitori comprendono i requisiti di sicurezza aziendali. I casi di studio dimostrano la conoscenza specifica del settore. Le referenze dei clienti convalidano le prestazioni passate. Le capacità di scala corrispondono alle esigenze del business.
- I fornitori comprendono i rigorosi requisiti di sicurezza e conformità aziendali.
- I casi di studio dimostrano una profonda conoscenza operativa specifica del settore.
Standard di sicurezza e conformità
I partner applicano regole rigorose sulla privacy dei dati. Le certificazioni attestano la sicurezza dell’infrastruttura. Gli accordi legali tutelano la proprietà intellettuale. Le tracce di audit garantiscono il rispetto delle normative.
- I partner di sviluppo applicano regole interne rigorose sulla privacy dei dati.
- Le certificazioni di sicurezza attestano una solida protezione dell’infrastruttura cloud.
- I contratti legali tutelano la proprietà intellettuale aziendale proprietaria.
- Le tracce di audit garantiscono la piena conformità alle normative di settore.
Assistenza post-distribuzione
I contratti di manutenzione garantiscono la continuità del sistema. I servizi di monitoraggio tengono traccia delle metriche di prestazione. Gli aggiornamenti regolari mantengono i modelli aggiornati. Team di assistenza dedicati risolvono i bug.
- Gli accordi di manutenzione garantiscono un’elevata disponibilità del sistema applicativo.
- I servizi di monitoraggio tengono traccia delle metriche di accuratezza delle prestazioni in tempo reale.
Tendenze future nello sviluppo di LLM personalizzati e nell’AI aziendale
Lo scenario dell’AI aziendale si sta orientando rapidamente verso l’edge computing ad altissima efficienza, le capacità multimodali e i flussi di lavoro agentici autonomi che eseguono processi aziendali complessi e articolati in più fasi senza intervento umano.
Ora scopriamo le prossime innovazioni tecnologiche e strategiche destinate a ridefinire il modo in cui la tua azienda sfrutterà i modelli linguistici di grandi dimensioni personalizzati nei prossimi anni.
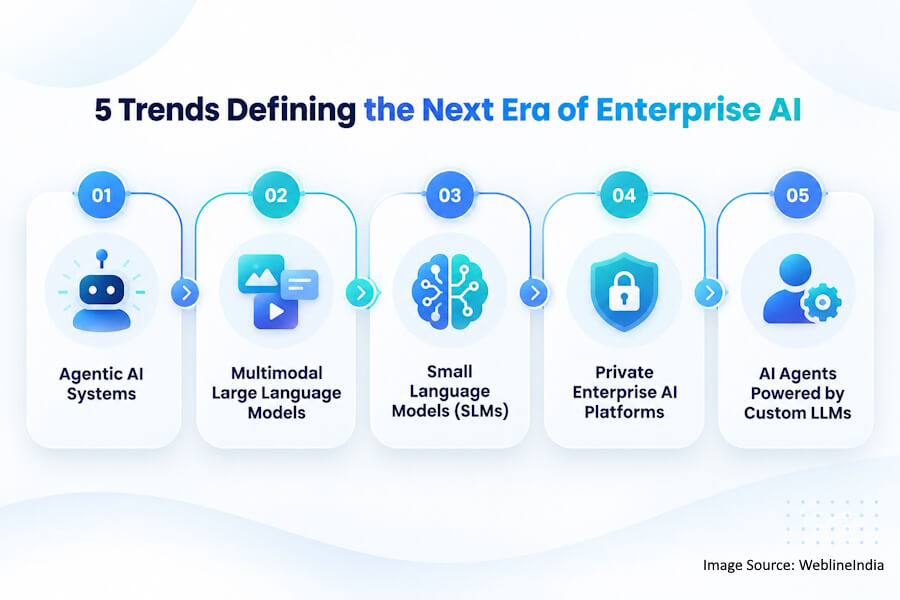
Sistemi di AI agentica
Gli agenti autonomi eseguono flussi di lavoro in più passaggi. I sistemi collaborano per risolvere problemi. I motori decisionali gestiscono attività complesse. La produttività aumenta in tutti i reparti.
Modelli linguistici di grandi dimensioni multimodali
I modelli elaborano testo, audio e video. I sensori integrati analizzano gli ambienti fisici. Input ricchi migliorano la comprensione del contesto. Le applicazioni abbracciano più tipi di percezione sensoriale.
- I modelli elaborano contemporaneamente flussi di testo, audio e video.
- I sensori integrati analizzano gli ambienti fisici di lavoro nelle fabbriche.
- Flussi di input ricchi migliorano la comprensione profonda del contesto.
- Le applicazioni abbracciano senza soluzione di continuità più tipi di dati sensoriali.
Small Language Model (SLM)
I modelli compatti funzionano su dispositivi edge. L’hardware locale elabora le richieste all’istante. Le esigenze di risorse calano in modo significativo. La privacy migliora grazie all’esecuzione locale.
- I modelli compatti vengono eseguiti localmente su dispositivi edge.
- L’hardware locale elabora all’istante le richieste degli utenti.
Piattaforme AI aziendali private
Piattaforme sicure centralizzano gli strumenti di intelligenza artificiale. I marketplace interni condividono i modelli addestrati. Le dashboard di governance monitorano l’utilizzo del sistema. Le aziende controllano il proprio destino in ambito AI.
- Piattaforme sicure centralizzano gli strumenti di intelligenza artificiale aziendali.
- I marketplace interni condividono i pesi di modelli addestrati su misura.
- Le dashboard di governance monitorano l’utilizzo del sistema in tutta l’azienda.
- Le aziende controllano completamente la propria infrastruttura di intelligenza artificiale.
Agenti AI basati su LLM personalizzati
Lo sviluppo di agenti AI aziendali può combinare agenti specializzati con LLM personalizzati per eseguire operazioni aziendali e coordinare flussi di lavoro software. Assistenti intelligenti gestiscono le agende quotidiane. I guadagni di efficienza trasformano i flussi di lavoro aziendali.
- Agenti specializzati eseguono automaticamente operazioni aziendali complesse.
- Strumenti automatizzati coordinano le pipeline di distribuzione dello sviluppo software.
Considerazioni finali sulla creazione di un LLM personalizzato per il successo aziendale a lungo termine
L’adozione dell’intelligenza artificiale determina i leader del mercato di domani. Gli strumenti pubblici generici non reggono le esigenze aziendali. Le organizzazioni creano modelli personalizzati per proteggere i propri dati. I flussi di lavoro proprietari richiedono un’intelligenza specializzata. Il successo a lungo termine richiede una solida infrastruttura AI. Le aziende si affidano a fornitori esperti per accelerare l’esecuzione.
WeblineIndia offre servizi di sviluppo di LLM personalizzati di eccellenza. I team di ingegneria realizzano LLM aziendali sicuri. Gli specialisti ottimizzano i modelli con il fine-tuning per la massima accuratezza. WeblineIndia trasforma le attività aziendali con soluzioni AI personalizzate. Le organizzazioni ottengono oggi vantaggi competitivi duraturi. Contatta WeblineIndia per avviare l’integrazione di un’intelligenza artificiale su misura.
Hashtag social
#LLMPersonalizzati #LargeLanguageModels #AIaziendale #AIGenerativa #IntelligenzaArtificiale #LLM #SviluppoAI #IngegneriaAI #AgenticAI #AgentiAI #RetrievalAugmentedGeneration #RAG #MachineLearning #InfrastrutturaAI #TrasformazioneDigitale #TecnologiaAziendale #MLOps #InnovazioneAI #PrivateAI #AutomazioneAziendale
Crea un LLM personalizzato, sicuro e scalabile, su misura per i dati e i flussi di lavoro della tua azienda, con un team di sviluppo AI esperto.
Domande frequenti
Come posso creare un LLM personalizzato per la mia azienda?
Le aziende raccolgono dati proprietari, scelgono potenti architetture open source, effettuano il fine-tuning dei pesi del modello su server sicuri e implementano infrastrutture scalabili per automatizzare i flussi di lavoro interni e proteggere la proprietà intellettuale sensibile.
È meglio creare un LLM da zero o effettuare il fine-tuning di uno esistente?
Il fine-tuning di modelli di base esistenti consente di risparmiare tempo e denaro, adattando la grammatica pre-addestrata a domini specifici. L'addestramento da zero rimane necessario solo in presenza di requisiti linguistici o di sicurezza del tutto peculiari.
Quali dati sono necessari per addestrare un modello linguistico personalizzato?
Gli ingegneri raccolgono documenti interni puliti, manuali tecnici, trascrizioni storiche e record di database strutturati. I team devono rimuovere gli identificativi personali e formattare accuratamente il testo prima di alimentare le pipeline di addestramento.
Quanto costa sviluppare un LLM personalizzato?
I costi variano in base al numero di parametri, al noleggio dell'hardware e alla manodopera necessaria per la preparazione dei dati. I cluster GPU in cloud richiedono investimenti ingenti, mentre il fine-tuning di adattatori esistenti riduce il budget complessivo di implementazione.
Qual è il miglior LLM open source per le aziende?
Meta Llama e Mistral AI offrono prestazioni eccezionali e pesi aperti per implementazioni locali sicure. Le organizzazioni scelgono varianti specifiche in base ai limiti dei parametri e alle risorse di calcolo disponibili.
Quanto tempo occorre per creare un LLM personalizzato?
Le tempistiche variano da alcune settimane a diversi mesi, a seconda della complessità del dataset. Il rilascio graduale e l'uso di modelli di base pre-addestrati accelerano i tempi di implementazione iniziale per i team aziendali.
Le aziende possono creare modelli di IA privati?
Le aziende implementano i modelli su hardware server locale o su sottoreti cloud private sicure. Ciò garantisce un isolamento totale dei dati e impedisce ai fornitori di API esterni di accedere a informazioni aziendali riservate.
Quale infrastruttura è necessaria per lo sviluppo di LLM?
Il deep learning richiede cluster GPU ad alte prestazioni, hardware di rete robusto e database vettoriali veloci. Gli ingegneri DevOps configurano nodi Kubernetes scalabili per gestire carichi di lavoro intensivi di inferenza.
Come implementano le aziende gli LLM personalizzati?
I team DevOps predispongono istanze di inferenza cloud o nodi server locali. I gateway API collegano le applicazioni aziendali interne, mentre i bilanciatori di carico distribuiscono in modo efficiente il traffico delle richieste in entrata tra i vari server.
Quali sono i vantaggi degli LLM privati?
I modelli privati garantiscono una rigorosa riservatezza dei dati, eliminano i costi di abbonamento basati sui token e forniscono risposte accurate e specifiche per il settore. Le organizzazioni mantengono il controllo assoluto sui pesi del modello e sulle politiche di sicurezza del sistema.
Cos'è la RAG e come si confronta con il fine-tuning?
La Retrieval-Augmented Generation (RAG) recupera dinamicamente documenti esterni in tempo reale senza modificare i pesi fondamentali del modello. Il fine-tuning, invece, modifica direttamente i parametri della rete neurale per adattare il modello a terminologie specializzate e comportamenti specifici dei flussi di lavoro aziendali.
Quanto sono sicuri gli LLM aziendali?
Le piattaforme aziendali adottano rigorosi controlli di accesso basati sui ruoli, la crittografia dei dati a riposo e politiche di mancata conservazione dei dati (zero-retention). Audit di sicurezza e firewall locali proteggono le informazioni riservate dalle minacce informatiche.
Riconosciuta a livello globale per qualità e affidabilità senza pari


Testimonianze: ascoltale direttamente dai nostri clienti globali
I nostri processi di sviluppo offrono soluzioni dinamiche per affrontare le sfide aziendali, ottimizzare i costi e guidare la trasformazione digitale. Soluzioni supportate da esperti migliorano la fidelizzazione e la presenza online, mentre casi di successo comprovati evidenziano la risoluzione di problemi reali tramite applicazioni innovative. I nostri stimati clienti in tutto il mondo lo hanno già sperimentato.
Premi e Riconoscimenti
Sebbene i clienti soddisfatti siano la nostra più grande motivazione, il riconoscimento del settore ha un valore significativo. WeblineIndia è stata costantemente leader nella tecnologia, con premi e riconoscimenti che riaffermano la nostra eccellenza.
OA500 Aziende globali di outsourcing 2025, di Outsource Accelerator
Migliore azienda di sviluppo software, di GoodFirms
Migliore azienda di soluzioni fintech – 2022, di GESIA
Premiata come – Migliore azienda di sviluppo app in India 2020, da SoftwareSuggest