Slik bygger du en skreddersydd LLM for bedriften din
Lær hvordan du bygger en skreddersydd LLM for bedriften din gjennom en trinnvis tilnærming som dekker dataklargjøring, valg av grunnmodell, finjustering, RAG, infrastruktur, distribusjon, sikkerhet, kostnader og bruksområder i bedriftssammenheng.


 ChatGPT
 Perplexity
Å bygge en skreddersydd LLM for din virksomhet innebærer å identifisere konkrete bruksområder, klargjøre relevante data, velge riktig modellarkitektur og gjennomføre effektive trenings- og testprosesser. En tilpasset LLM kan forbedre automatisering, effektivitet, kundeopplevelser og beslutningstaking i hele virksomheten.
Hva er en skreddersydd stor språkmodell (LLM), og hvorfor trenger bedrifter en?
Standard grunnleggende kunstig intelligens-modeller betjener brede, offentlige forespørsler. Disse generiske modellene mangler spesifikk driftskontekst. Organisasjoner sliter med nøyaktighetsgap. Generiske systemer finner på feilaktige fakta om bedriften. Selskaper trenger spesialisert domenekunnskap. Skreddersydd LLM-utvikling bygger bro over nettopp dette gapet. Proprietære data forblir internt. Sikkerhetsprotokoller begrenser ekstern datalekkasje. Organisasjoner bygger en bedrifts-LLM for å behandle sensitive dokumenter.
Skreddersydde AI-utviklingstjenester retter seg mot spesifikke arbeidsflyter. Ansatte laster opp interne tekniske håndbøker. Systemet lærer proprietær terminologi umiddelbart. Utvikling av store språkmodeller innebærer omfattende parameterjustering. Bedrifter beveger seg fra offentlige verktøy til sikker infrastruktur. Private LLM-driftsettinger garanterer dataisolasjon. Finansinstitusjoner behandler konfidensielle dokumenter trygt. Helseaktører beskytter pasientjournaler grundig.
Standardmodeller feiler på tekniske spørsmål. Skreddersydd GPT-utvikling adresserer nisjebransjer. Organisasjoner bruker AI-modellutvikling til å automatisere komplekse skriveoppgaver. Bedrifts-AI-modeller forstår interne nøkkeltall. Selskaper tar i bruk åpen kildekode-LLM-løsninger for å beholde eierskap til koden. Denne tilnærmingen eliminerer abonnementsavgifter til tredjepart. Proprietære vekter forblir på lokale servere. Høy driftskontroll styrker interne ingeniørteam. AI-infrastruktur krever kraftige beregningsklynger. Ingeniører konfigurerer distribuerte prosesseringsnoder.
Viktigste fordeler ved å bygge en skreddersydd LLM for bedriftsapplikasjoner
Å bygge en skreddersydd stor språkmodell (LLM) gjør det mulig for organisasjoner å beholde sikkerheten til proprietære data, redusere hallusinasjoner drastisk gjennom domenespesifikk finjustering, og sømløst automatisere komplekse interne arbeidsflyter.
La oss forstå hvorfor det å tilpasse en AI-modell spesifikt til organisasjonens data gir enestående driftseffektivitet og et reelt konkurransefortrinn i moderne bedriftsmiljøer.
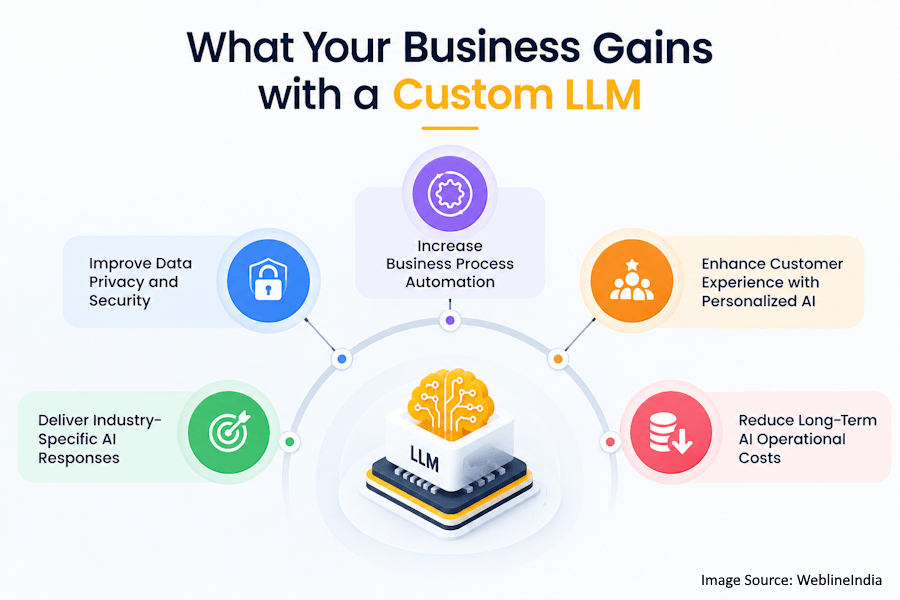
Forbedre personvern og datasikkerhet
Offentlige kunstig intelligens-plattformer lagrer brukerinput. Eksterne servere mottar proprietære bedriftshemmeligheter. Bedrifter risikerer strenge regulatoriske bøter. Skreddersydde AI-modellutviklingstjenester eliminerer risikoen ved offentlig sky. Dataene forblir i lokale datasentre. Sikkerhetsteam krypterer informasjon i hvile. Ansatte deler konfidensielle rapporter trygt. Compliance-ansvarlige håndhever strenge tilgangskontroller. Privat LLM-utvikling sikrer immaterielle rettigheter.
- Bedriftens servere lagrer prompt-logger lokalt.
- Eksterne API-leverandører ser aldri interne data.
- Sikkerhetsingeniører konfigurerer strenge brannmurregler.
Levere bransjespesifikke AI-svar
Generiske modeller misforstår teknisk fagsjargong. Spesialiserte domener krever presist vokabular. Skreddersydde LLM-utviklingstjenester trener modeller på nisjedatasett. Ingeniører bruker finjustering av en LLM for å oppnå forretningsmessig nøyaktighet. Advokatfirmaer laster opp rettspraksisarkiver. Medisinske forskere behandler notater fra kliniske studier. Systemet gir korrekt terminologi.
- Juridiske databaser mater spesialiserte treningspipeliner med historiske dokumenter.
- Medisinske tidsskrifter forbedrer nøyaktigheten i kliniske spørringer for sykehusdiagnostikk.
- Ingeniørteam integrerer tegninger for å veilede tekniske resonneringsmotorer.
Øke automatiseringen av forretningsprosesser
Manuell dokumentsortering tapper menneskelige arbeidstimer. LLM-er kan også utfylle tjenester for automatisering av forretningsprosesser ved å støtte arbeidsflyter som dokumentbehandling, henvendelsesruting og informasjonsuthenting. Systemer ruter innkommende supporthenvendelser umiddelbart. Bedrifts-AI-utviklingstjenester kan støtte arkitekturer designet for å holde sensitive forretningsdata innenfor kontrollerte miljøer. Algoritmer henter ut data fra ustrukturerte fakturaer. Bedrifts-AI-modeller utfører forretningslogikk i flere trinn.
- Automatisert fakturabehandling sparer regnskapsavdelinger for hundrevis av manuelle arbeidstimer hver eneste måned.
- Support-chatboter løser tekniske saker umiddelbart ved å referere til interne feilsøkingswikier.
- Logistikksystemer analyserer fraktmanifester automatisk for å oppdatere lagerdatabaser.
- Feil ved dataregistrering reduseres betydelig på tvers av bedriftens avdelinger.
Forbedre kundeopplevelsen med personlig tilpasset AI
Generiske svar frustrerer kunder. Kunder forventer kontekstuell hjelp. Utvikling av bedrifts-AI-modeller integrerer databaser med kundehistorikk. Plattformen husker tidligere kjøp. Supportmedarbeidere løser saker raskere. Merkelojaliteten øker jevnt.
- Anbefalingsmotorer analyserer tidligere kjøpsatferd for å foreslå relevante varer.
- Chatboter refererer til den enkelte kundes abonnementsnivå for å gi nøyaktig kontospesifikk støtte.
Redusere langsiktige driftskostnader for AI
Eksterne API-tokens akkumulerer høye avgifter. Bedriftstrafikk med høyt volum øker de månedlige regningene. Selskaper trener sin egen språkmodell for å unngå kostnader per token. Faste maskinvarekostnader erstatter variabel API-fakturering. Organisasjoner styrer budsjetter forutsigbart.
- Faste infrastrukturkostnader erstatter voksende API-regninger i perioder med høy trafikk.
- Store spørringsvolumer kjører billigere på lokale bedrifts-GPU-er over tid.
- Interne team optimaliserer inferenshastigheter uavhengig, uten begrensninger fra tredjepartsplattformer.
- Ressursallokering matcher nøyaktige etterspørselstopper i virksomheten effektivt.
Gjør bedriftens data om til en sikker, domenespesifikk AI-løsning bygget rundt dine arbeidsflyter, brukere og forretningsbehov.
Skreddersydd LLM vs. forhåndstrent LLM: Hvilken AI-modell passer for din virksomhet?
Forhåndstrente modeller gir umiddelbare, kostnadseffektive muligheter for generelle oppgaver, mens skreddersydde modeller leverer enestående sikkerhet og presisjon tilpasset nøyaktig din unike bransjesjargong.
La oss se på en grundig sammenligning for å avgjøre hvilken strategisk retning som passer best med virksomhetens langsiktige mål.
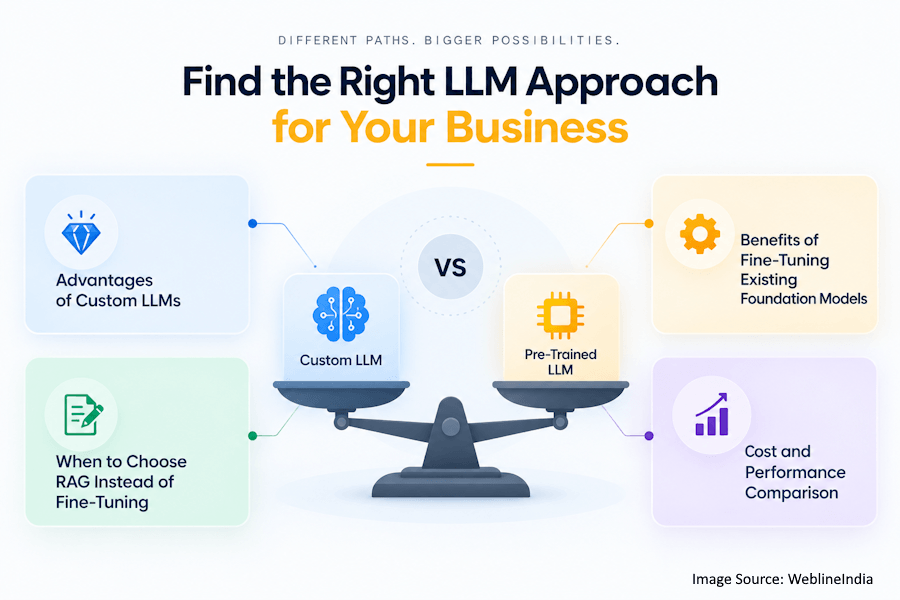
Fordeler med skreddersydde LLM-er
Organisasjoner eier sine egne modellvekter. Ingeniører endrer nevrale nettverkslag direkte. Skreddersydd LLM-utvikling gir enestående arkitektonisk kontroll. Proprietære algoritmer beskytter konkurransefortrinn. Sikkerhetspolicyer håndhever prinsipper om null datalagring. Ytelsen matcher nøyaktig bedriftens arbeidsbelastning.
- Full eierskap forhindrer fallgruver knyttet til leverandørbinding og vilkårlige prisendringer.
- Finjusteringsparametere tilpasses nisjebransjer med høy presisjon.
- Inferenshastigheten optimaliseres for spesifikke maskinvarekonfigurasjoner i lokale datasentre.
Fordeler ved å finjustere eksisterende grunnmodeller
Å bygge fra bunnen av koster millioner. Tjenester for finjustering av AI-modeller kan redusere behovet for trening fra bunnen ved å tilpasse eksisterende grunnmodeller til domenespesifikke krav. Eksisterende modeller gir et solid grammatisk utgangspunkt. Domenespesifikke datasett tilpasser de forhåndstrente vektene. Treningssykluser fullføres i løpet av dager. Ingeniører benytter rammeverk for LLM-utvikling med åpen kildekode.
- Forhåndstrente vekter gir rask grunnleggende kompetanse uten omfattende trening fra bunnen av.
- Beregningskostnadene forblir lavere enn fullstendige treningskjøringer i flermillionersklassen.
- Spesialiserte datasett omdirigerer generelle resonneringsevner mot spesifikke forretningsoppgaver.
- Utviklingstiden krymper fra år til uker.
Når man bør velge RAG fremfor finjustering
Trening endrer modellens kjernevekter. Retrieval-Augmented Generation lar vektene være urørt. Selskaper oppdaterer eksterne kunnskapsbaser daglig. RAG-systemer henter dokumenter dynamisk. Ingeniører velger RAG for wikier som endres ofte. Utviklingskostnadene holdes på et minimum.
- Dynamiske dokumentoppdateringer krever ingen ny trening eller vektoppdateringer.
- Eksterne vektordatabaser lagrer selskapets levende wikier for umiddelbar henting.
Sammenligning av kostnad og ytelse
Skreddersydde arkitekturer krever enorme beregningsklynger. Finjustering av grunnmodeller krever moderat leie av GPU-er. RAG-arkitekturer er avhengige av raske vektorsøk. Finansielle planleggere beregner nøyaktig avkastning på investeringen. Ytelsestester avgjør valg av arkitektur.
- Skreddersydd forhåndstrening medfører beregningsregninger i flermillionersklassen for rene treningskjøringer.
- Finjustering krever beskjedne sky-GPU-budsjetter for oppdatering av adaptervekter.
- RAG-implementeringer optimaliserer databaselagringskostnader samtidig som høy faktisk nøyaktighet opprettholdes.
- Ventetidsmålinger styrer de endelige produksjonsvalgene på tvers av ulike forretningsenheter.
Steg-for-steg-prosess for å bygge en skreddersydd LLM for din virksomhet
Å bygge en skreddersydd LLM innebærer å definere spesifikke forretningsbruksområder, samle inn og rense proprietære data, velge riktig grunnmodell, finjustere gjennom spesialisert trening, og grundig evaluere ytelsen før sikker driftsetting i bedriften.
La oss utforske hver fase i detalj for å se hvordan dette strukturerte veikartet sikrer at AI-implementeringen din lykkes sømløst.
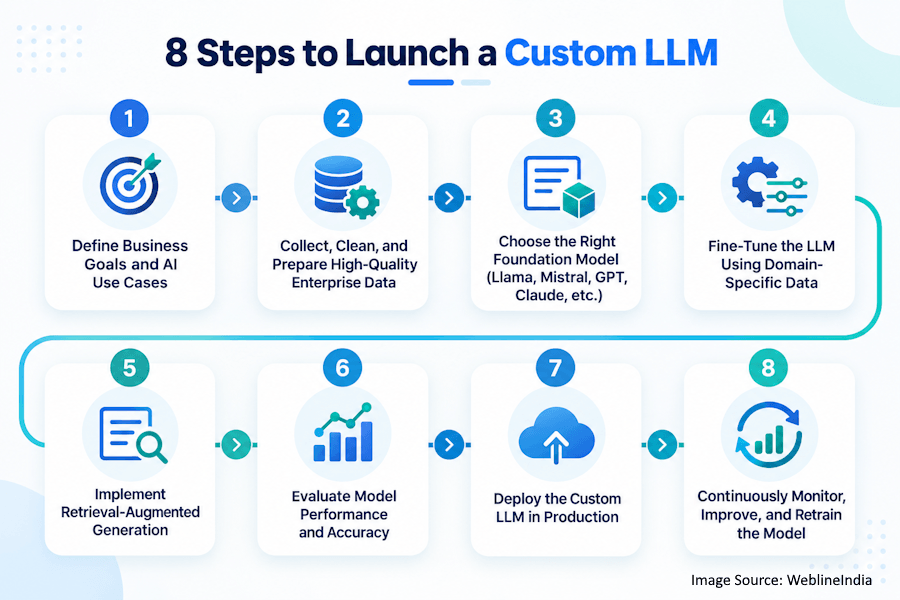
Definere forretningsmål og AI-bruksområder
Ledere skisserer nøyaktige driftsmessige flaskehalser. Ingeniører isolerer repetitive manuelle oppgaver. Prosjektledere definerer suksesskriterier. Klare mål forhindrer bortkastede beregningsressurser. Interessenter gjennomgår tilpasningsdokumenter grundig.
Samle inn, rense og klargjøre høykvalitets bedriftsdata
Rå bedriftsdata inneholder formateringsfeil. Ingeniører fjerner duplikatoppføringer nådeløst. Tekstanalyseverktøy fjerner sensitive personopplysninger. Rene datasett mater treningspipeliner. Høy datakvalitet sikrer pålitelige resultater.
- Dataingeniører henter ut rå tekst fra eldre bedriftsdatabaser.
- Automatiserte skript fjerner korrupte tegnkodinger fra dokumenter.
- Rensing av personopplysninger beskytter internt ansattes personvern før treningen starter.
- Formaterte JSON-filer organiserer treningsdata riktig for modellene.
Velge riktig grunnmodell (Llama, Mistral, GPT, Claude, m.fl.)
Modellvalget avgjør suksessen videre. Ingeniører tester flere grunnleggende arkitekturer. Åpne vekter gir frihet til lokal driftsetting. Proprietære modeller gir sterke resonneringsgrunnlag. Lisensavtaler bestemmer rettighetene til kommersiell bruk.
- Ytelsestester evaluerer grunnleggende resonneringshastigheter på tvers av ulike kandidatmodeller.
- Lisensvilkårene tillater kommersiell bedriftsdriftsetting uten juridisk risiko.
Finjustere LLM-en med domenespesifikke data
Spesialiserte adaptere endrer modellens atferd, mens tjenester for utvikling av maskinlæring kan støtte den bredere arbeidsflyten for trening, validering og modellutvikling. Tapskurvene synker gjennom epoke-iterasjoner. Ingeniører validerer resultater mot testsett. De endelige vektene lagres i sikre repositorier.
- LoRA-adaptere minimerer antallet aktive treningsparametere under finjustering.
- GPU-klynger behandler terabyte med domenetekst effektivt.
- Tapsmålinger følger konvergenshastigheter under treningsepoker.
Implementere Retrieval-Augmented Generation
Tekstoppdelere deler opp lange bedriftsrapporter i mindre biter. Embeddingmodeller konverterer tekst til vektorer. Vektordatabaser indekserer semantisk informasjon. Søkealgoritmer henter relevant dokumentkontekst. Prompter kombinerer hentede fakta med spørringer.
- Tekstoppdeling deler store håndbøker effektivt inn i mindre segmenter.
- Embeddingmodeller oversetter ord til numeriske vektorer for indeksering.
- Vektordatabaser lagrer flerdimensjonale semantiske indekser for raske spørringer.
- Kontekstinjeksjon forankrer modellens svar i verifiserte fakta.
Evaluere modellens ytelse og nøyaktighet
Automatiserte testskript måler svarkvaliteten. Menneskelige vurderere gir karakter til subjektive resultater. Testpakker prøver resonneringsgrensene. Sikkerhetsfiltre tester for sårbarheter mot prompt-injeksjon. Dårlige resultater utløser umiddelbar ny trening.
- Automatiserte evalueringsskript kjører testpakker mot resultatene.
- Menneskelige eksperter vurderer domenenøyaktighet manuelt for kvalitativ gjennomgang.
Sette den skreddersydde LLM-en i produksjon
DevOps-tjenester kan støtte etableringen av sky-inferensservere, driftsettingspipeliner og skalerbare produksjonsmiljøer for skreddersydde LLM-er. Lastbalanserere fordeler innkommende brukertrafikk. API-endepunkter kobler til interne applikasjoner. Overvåkingsverktøy følger systemets helsetilstand. Produksjonsmiljøer sikrer høy tilgjengelighet.
- Kubernetes-klynger skalerer inferensnoder automatisk under trafikktopper.
- API-gatewayer administrerer bedriftens brukerautentiseringstokener på en sikker måte.
- Lastbalanserere fordeler tung forespørselstrafikk jevnt over servere.
- Reservemekanismer forhindrer uventet systemnedetid under vedlikehold.
Kontinuerlig overvåke, forbedre og trene modellen på nytt
Brukertilbakemeldinger fremhever driftsmessige feil. Loggingspipeliner fanger opp feilaktige svar. Dataforskere kuraterer nye treningsdata. Planlagt ny trening oppdaterer modellens vekter. Bedriftssystemer utvikler seg i takt med forretningsbehovene.
- Tilbakemeldingsknapper fanger opp brukervurderinger umiddelbart etter generering.
- Loggingssystemer flagger tilbakevendende hallusinasjonstilfeller for gjennomgang.
- Datapipeliner mottar nylig oppdaterte bedriftsretningslinjer ukentlig.
- Planlagte omtreningssykluser holder intelligensen oppdatert med markedet.
Klar til å gjøre LLM-veikartet ditt om til en produksjonsklar løsning? Våre AI-ingeniører kan hjelpe deg med å bygge, finjustere, driftsette og skalere den.
Velge den beste grunnmodellen for skreddersydd LLM-utvikling
Å velge en optimal grunnmodell krever en balanse mellom avgjørende parametere som beregningsoverhead, arkitektoniske lisensbegrensninger, grunnleggende domeneytelse og krav til inferensventetid, opp mot organisasjonens spesifikke tekniske begrensninger.
La oss analysere hvordan man systematisk kan evaluere disse arkitektoniske variablene for å identifisere modellen som maksimerer både kapasitet og kostnadseffektivitet.
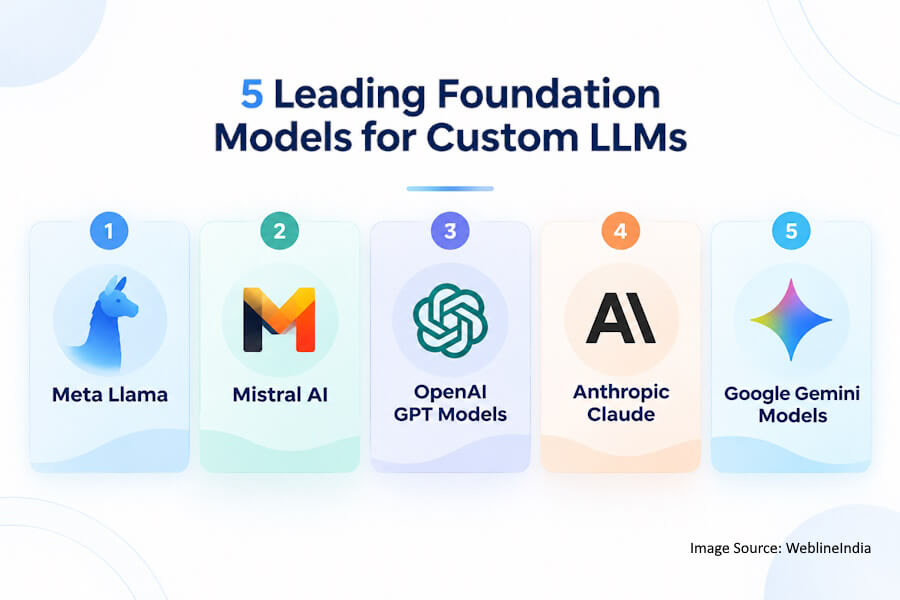
Meta Llama
Åpne vekter tiltrekker seg bedriftsutviklere. Lokal driftsetting garanterer datasikkerhet. Finjustering av Llama-modeller krever standard maskinvare. Community-forumer tilbyr omfattende feilsøkingsguider.
- Vekter med åpen kildekode tillater lokalisert serverdriftsetting bak brannmurer.
- Parameterstørrelser skaleres fra små til massive bedriftskonfigurasjoner.
Mistral AI
Europeisk ingeniørkunst driver høy effektivitet. Kompakte modeller leverer raske inferenshastigheter. Bedriftskunder lisensierer proprietære vektvarianter. Arkitekturdesign optimaliserer minneforbruket.
- Effektiv arkitektur reduserer den driftsmessige beregningsoverheaden betydelig.
- Kompakte modellstørrelser fremskynder svargenereringstiden for brukerne.
- Sterke resonneringsresultater konkurrerer med større bransjekonkurrenter.
- Fleksibel lisensiering passer for varierte kommersielle forretningsstrukturer.
OpenAIs GPT-modeller
Proprietære API-er tilbyr kraftige resonneringsgrunnlag. Utviklere slipper å administrere infrastrukturklynger. Regelmessige oppdateringer introduserer avanserte funksjonssett. Personvernpolicyer beskytter bedriftens kundedata.
- Administrerte API-er eliminerer oppgaver knyttet til infrastrukturvedlikehold for interne team.
- Avansert resonnering håndterer komplekse logikkproblemer enkelt uten justering.
Anthropic Claude
Lange kontekstvinduer behandler hele bøker. Sikkerhetsmekanismer minimerer skadelige resultater. Bedriftskunder integrerer sikre API-endepunkter. Finansanalytikere analyserer store regneark direkte.
- Enorme kontekstvinduer tar inn hele kodebaser og omfattende rapporter.
- Innebygd konstitusjonell sikkerhet reduserer skadelige eller giftige resultater.
- Dokumentanalyse henter ut strukturerte data fra tette finansielle sider.
Googles Gemini-modeller
Multimodale evner behandler tekst og video. Skyinfrastruktur integrerer native AI-verktøy. Bedriftssøkefunksjoner kobler til interne disker. Skalerbare arkitekturer håndterer tunge arbeidsbelastninger.
- Native multimodalitet behandler bilder og videostrømmer direkte.
- Google Cloud-integrasjon forenkler bedriftens driftsettingspipeliner.
Infrastruktur og teknologistack som kreves for skreddersydd LLM-utvikling
Å utvikle en robust skreddersydd LLM krever høyytelses beregningsklynger utstyrt med spesialiserte GPU-er, skalerbare datapipeliner, rammeverk for bedriftsorkestrering og sikre vektordatabaser for Retrieval-Augmented Generation.
La oss undersøke den essensielle tekniske arkitekturen som kreves for å drive bedriftens AI-infrastruktur effektivt.
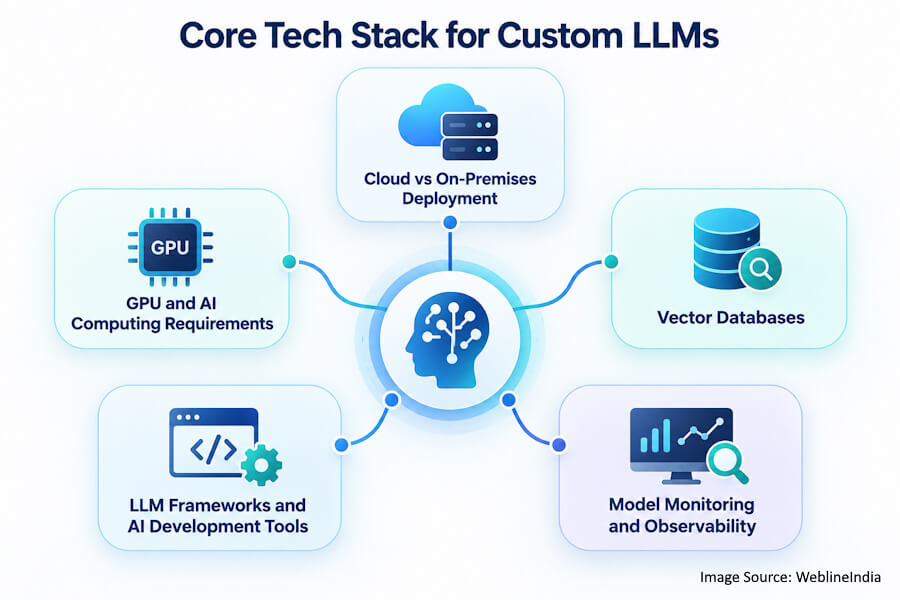
Sky versus lokal driftsetting
Skyleverandører tilbyr elastisk GPU-skalering. Lokale servere beskytter svært klassifiserte hemmeligheter. Finansielle reguleringer bestemmer reglene for maskinvareplassering. Hybridarkitekturer balanserer kostnad og sikkerhet.
Krav til GPU og AI-beregning
Dyp læring krever spesialiserte akseleratorbrikker. Høy VRAM-kapasitet laster inn store modeller. Sammenkoblingshastigheter fremskynder distribuerte treningsoppgaver. Strømforbruk driver datasenterbudsjettene.
- NVIDIA H100-klynger akselererer modelltreningstider drastisk.
- Høye VRAM-kapasiteter laster inn massive parametervekter på en sikker måte.
- Høyhastighetssammenkoblinger knytter sammen flere treningsnoder uten ventetid.
Vektordatabaser
Embeddinger krever spesialiserte lagringsløsninger. Likhetssøk henter frem matchende dokumentbiter. Skalerbare arkitekturer håndterer milliarder av vektorer. Indekseringshastighet påvirker spørringsventetid.
- Pinecone administrerer skybaserte vektorsøkindekser effektivt.
- Milvus skalerer sømløst på tvers av distribuerte lokale serverklynger.
- Qdrant håndterer raske metadatafiltreringsoperasjoner under søk.
LLM-rammeverk og AI-utviklingsverktøy
Python-biblioteker forenkler oppbyggingen av pipeliner. Orkestreringsverktøy kjeder sammen komplekse agenttrinn. Kvantiseringspakker reduserer modellens minneavtrykk. Containeriseringsverktøy standardiserer driftsettingsmiljøer.
- LangChain orkestrerer komplekse, flertrinns arbeidsflyter for kunstig intelligens-agenter.
- LlamaIndex kobler eksterne dokumenter til modeller for RAG.
Modellovervåking og observerbarhet
Målinger følger tokenforbrukstakten. Feillogging avdekker steder der prompter feiler. Drift-deteksjon oppdager fallende nøyaktighetstrender. Sikkerhetsskannere blokkerer ondsinnede input.
- Grafana-dashbord viser sanntidsmålinger for systemressursbruk.
- Loggingsverktøy fanger opp feilsporinger fra brukerpromter for analyse.
- Drift-monitorer varsler ingeniører om ytelsesfall.
- Sikkerhetsfiltre blokkerer uautoriserte forsøk på prompt-injeksjon.
Vanlige utfordringer i skreddersydd LLM-utvikling og hvordan man overkommer dem
Skreddersydd LLM-utvikling byr ofte på hindringer som skyhøye beregningskostnader, risiko for personvern av data, katastrofal glemsel under finjustering og håndtering av modelldrift over tid.
La oss avdekke de velprøvde avbøtende strategiene som kreves for å navigere gjennom disse vanlige tekniske hindringene.
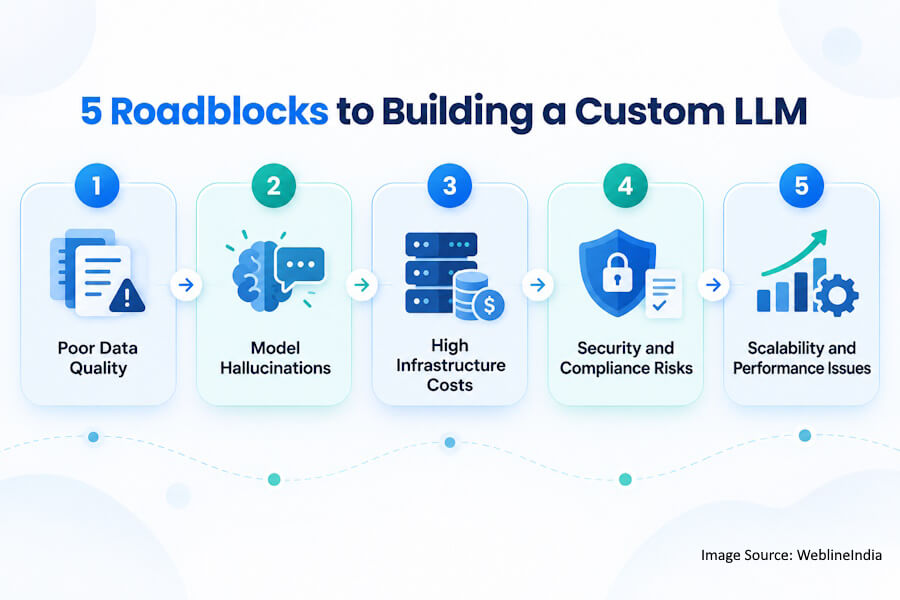
Dårlig datakvalitet
Ufullstendige dokumenter forårsaker ustabil modelladferd. Datarensingspipeliner fjerner støy. Automatiserte valideringsskript sjekker tekstformater. Menneskelige revisorer verifiserer datasettets integritet.
- Manglende dokumentseksjoner skaper hull i logisk resonnering under trening.
- Automatiserte regex-skript fjerner korrupte tekst-tegn fra filer.
Modellhallusinasjoner
Modeller finner opp falske historiske fakta. RAG-arkitekturer forankrer svarene i sannhet. Strenge temperaturinnstillinger reduserer kreativ oppdiktning. Evalueringspakker fanger opp feil tidlig.
- Forankringsprompter begrenser svarene strengt til de leverte kildedokumentene.
- Lave temperaturinnstillinger reduserer graden av tilfeldig generert innhold.
- Kildekrav tvinger modellene til å referere til dokumentkilder.
Høye infrastrukturkostnader
GPU-leie tapper bedriftsbudsjetter. Modellkvantisering reduserer minneavtrykk. Mindre modeller erstatter massive grunnleggende systemer. Effektiv batching maksimerer maskinvareutnyttelsen.
- Modellkvantisering halverer filstørrelser uten kvalitetstap.
- Spot-GPU-instanser senker skybaserte leiekostnader betydelig.
- Forespørselsbatching maksimerer utnyttelsen av aktiv maskinvarekapasitet.
Sikkerhets- og compliance-risiko
Datalekkasjer utløser regulatoriske bøter. Krypteringsprotokoller sikrer lagrede filer. Tilgangskontrollister begrenser brukertillatelser. Regelmessige revisjoner verifiserer systemets integritet.
- Krypteringsstandarder beskytter filer under interne nettverksoverføringer.
- Rollebasert tilgang begrenser synligheten av sensitive dokumenter på tvers av avdelinger.
- Compliance-revisjoner verifiserer overholdelse av bransjens regulatoriske rammeverk.
- Penetrasjonstesting avdekker skjulte sikkerhetssårbarheter i applikasjoner.
Utfordringer med skalerbarhet og ytelse
Høy brukertrafikk forårsaker flaskehalser på servere. Lastbalanserere fordeler innkommende forespørselslaster. Cachelag lagrer resultater fra hyppige spørringer. Asynkrone køer håndterer tunge arbeidsbelastninger.
- Lastbalanserere forhindrer krasj på grunn av overbelastning på en enkelt server under trafikktopper.
- Caching av svar betjener identiske spørringer umiddelbart uten inferens.
Hvor mye koster det å bygge en skreddersydd LLM for din virksomhet?
Å bygge en skreddersydd bedrifts-LLM innebærer varierende økonomiske forpliktelser, fra grunnleggende API-konfigurasjoner til ressurskrevende treningspipeliner. Organisasjoner må ta høyde for GPU-beregningsoverhead, datapreparasjonspipeliner, spesialisert ingeniørkompetanse og langsiktige vedlikeholdskostnader.
La oss bryte ned de faktiske finansielle variablene og budsjettanslagene for å hjelpe deg med å planlegge en nøyaktig investeringsstrategi for ditt kommende bedrifts-AI-prosjekt.
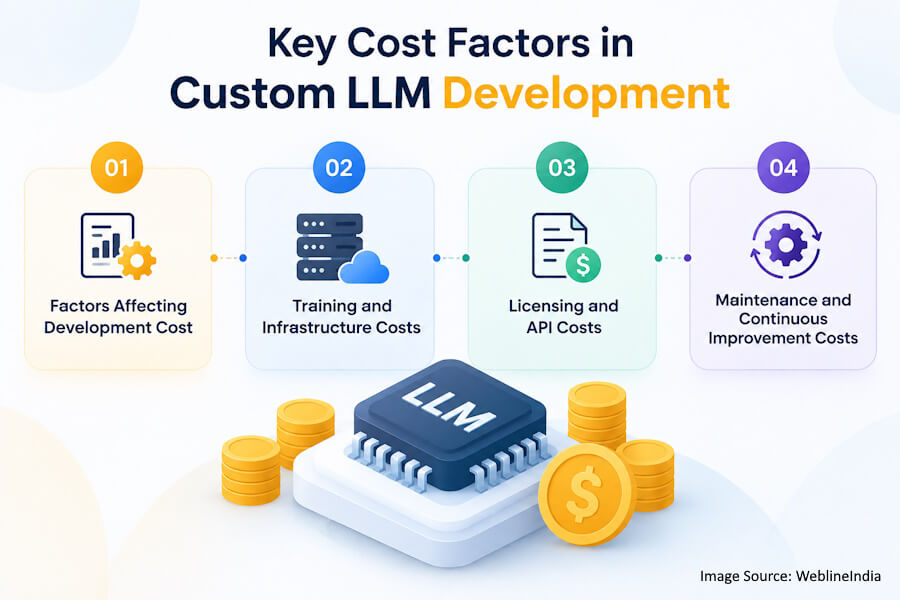
Faktorer som påvirker utviklingskostnadene
Datasettstørrelsen påvirker arbeidet med dataklargjøring, mens modellens antall parametere avgjør maskinvarebehovet. AI-konsulenttjenester kan hjelpe organisasjoner med å vurdere integrasjonskompleksitet, infrastrukturkrav og andre faktorer som påvirker prosjektets omfang.
- Store datasett krever omfattende manuell rensetid fra ingeniører.
- Modeller med mange parametere krever dyr GPU-maskinvare i toppklasse.
Trenings- og infrastrukturkostnader
Beregningsklynger krever betydelig finansiering. Strømregninger legger til løpende driftskostnader. Skyleverandører tar betalt per time for GPU-bruk. Maskinvarekjøp krever kapital på forhånd.
- Timebasert leie av sky-GPU-er akkumuleres raskt under treningskjøringer.
- Strøm- og kjøleoverhead øker anleggsbudsjettene for servere.
- Klyngeoppsett krever dyrt høyhastighets nettverksutstyr.
- Vedlikeholdskontrakter dekker uventede maskinvarefeil på serverkomponenter.
Lisens- og API-kostnader
Proprietære grunnmodeller krever abonnementsavgifter. Tillatelser til kommersiell bruk medfører ekstra kostnader. Vekter med åpen kildekode eliminerer tilbakevendende lisensregninger. Juridiske gjennomganger sikrer etterlevelse.
- Kommersielle API-tokens akkumulerer månedlige kostnader basert på volum.
- Abonnementer på proprietære modeller skaleres med antall aktive brukere.
- Vekter med åpen kildekode unngår tilbakevendende belastninger fra programvarelisensavgifter.
Kostnader til vedlikehold og kontinuerlig forbedring
Modeller krever løpende omtreningssykluser. Ingeniørteam fikser driftsfeil. Sikkerhetsoppdateringer beskytter infrastrukturservere. Overvåkingsverktøy medfører abonnementsavgifter.
- Omtreningspipeliner mottar regelmessig nylig oppdaterte bedriftsdokumenter.
- Supportingeniører feilsøker uventede produksjonsfeillogger daglig.
- Sikkerhetsteam installerer programvareoppdateringer på bedriftsservere.
- Observerbarhetsverktøy tar betalt basert på loggdatavolum.
Få et realistisk kostnadsoverslag for en skreddersydd LLM basert på ditt bruksområde, dine data, modellvalg, integrasjoner, infrastruktur og driftsettingskrav.
Beste praksis for å bygge sikre, nøyaktige og skalerbare bedrifts-LLM-er
Implementering av robuste bedrifts-LLM-er krever streng håndhevelse av datakryptering, etablering av kontinuerlige tilbakemeldingsløkker for å minimere hallusinasjoner, og design av horisontale skaleringsarkitekturer for å håndtere toppbelastninger.
La oss utforske de sentrale driftsettingsstrategiene som sikrer at AI-økosystemet ditt forblir beskyttet, svært presist og uendelig tilpasningsdyktig til fremtidig organisasjonsvekst.
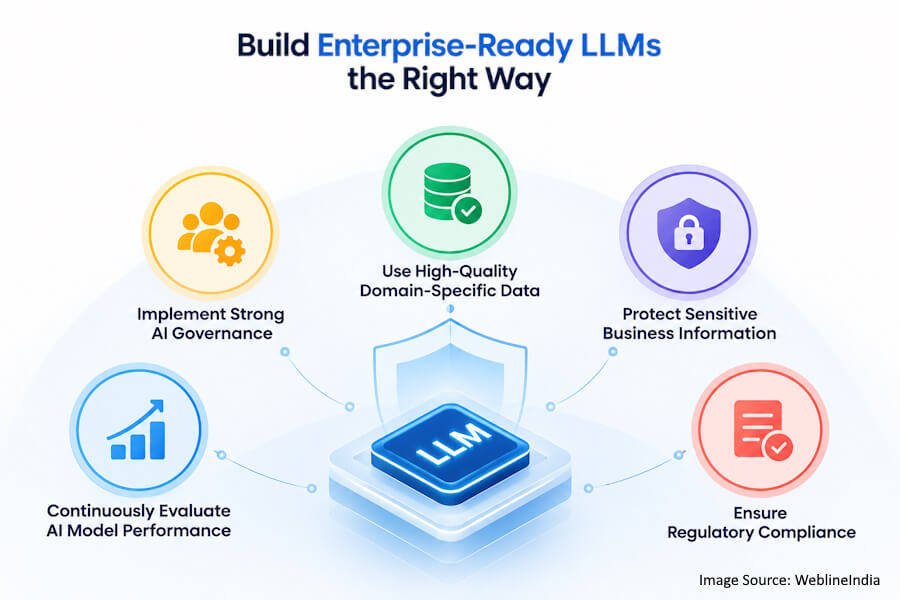
Implementere solid AI-styring
Komiteer fører tilsyn med kunstig intelligens-prosjekter. Etiske retningslinjer forhindrer partiske resultater. Versjonskontroll følger modelloppdateringer. Dokumentasjon registrerer arkitektoniske beslutninger.
Bruke høykvalitets domenespesifikke data
Kuraterte datasett forbedrer nøyaktigheten i resultatene. Fjerning av støy eliminerer forvirrende tekst. Standardiserte formater effektiviserer treningspipeliner. Regelmessige revisjoner opprettholder datakvaliteten.
- Kuraterte datasett gir klare semantiske læringssignaler for modellene.
- Støyreduksjon filtrerer bort irrelevant internett-tekst fullstendig.
- Standardiserte skjemaer organiserer bedriftsdokumenter fra flere kilder på riktig måte.
Beskytte sensitiv forretningsinformasjon
Datamaskering skjuler konfidensielle tall. Lokale servere isolerer proprietære filer. Retningslinjer for null datalagring beskytter brukernes personvern. Nettverksbrannmurer blokkerer eksterne trusler.
- Datamaskering erstatter ekte navn med sikre plassholdere.
- Lokale serverdriftsettinger isolerer filer fra offentlige nettverk.
- Avtaler om null datalagring beskytter bedriftens prompt-personvern strengt.
- Nettverksbrannmurer blokkerer uautoriserte forsøk på ekstern inntrengning.
Kontinuerlig evaluere AI-modellens ytelse
Automatiserte ytelsestester måler nøyaktighetstrender. Brukertilbakemeldinger flagger driftsproblemer. Red teaming avdekker skjulte sårbarheter. Regelmessige gjennomganger oppdaterer ytelsesmål.
- Automatiserte testskript følger nøyaktighetstrender over tid.
- Brukervurderingsknapper fanger opp tilbakemeldinger om ytelse i den virkelige verden umiddelbart.
Sikre regulatorisk etterlevelse
Juridiske team gjennomgår rutiner for datahåndtering. GDPR-retningslinjer beskytter kundenes personvern. Bransjestandarder bestemmer sikkerhetskontroller. Dokumentasjon beviser regulatorisk etterlevelse.
- Juridiske gjennomganger sikrer overholdelse av strenge personvernlover.
- GDPR-protokoller håndterer brukersamtykke og forespørsler om sletting av data.
- Bransjestandarder krever spesifikke krav til krypteringsnøkkelstyrke.
Reelle forretningseksempler på skreddersydd LLM-utvikling på tvers av bransjer
Skreddersydde LLM-er transformerer bransjer ved å automatisere kompleks juridisk dokumentanalyse i finanssektoren, drive svært personlig tilpassede diagnostiske forslag innen helsevesen, og styre svært målrettet lagerlogistikk innen detaljhandel. Oppdag hvordan organisasjoner i ulike sektorer utnytter disse skreddersydde systemene til å optimalisere arbeidsflyter, drastisk kutte overheadkostnader og sikre et enormt konkurransefortrinn.
Helsevesen
Kliniske modeller oppsummerer pasienthistorikk. Medisinske forskere analyserer studier om legemiddelinteraksjoner. Diagnostiske assistenter behandler skanningnotater. Administrative arbeidsflyter fremskynder fakturering.
- Kliniske modeller oppsummerer omfattende pasienthistorikk for leger.
- Forskningsverktøy analyserer komplekse studier om legemiddelinteraksjoner raskt.
Bank og finansielle tjenester
Algoritmer for svindeldeteksjon analyserer transaksjonsstrømmer. Algoritmiske tradere behandler markedsrapporter. Compliance-systemer gjennomgår lånesøknader. Automatiserte agenter besvarer kontospørsmål.
- Algoritmer for svindeldeteksjon flagger mistenkelige transaksjonsstrømmer umiddelbart.
- Finansielle modeller analyserer resultatrapporter for bedriftsinvestorer.
- Compliance-verktøy gjennomgår risikofaktorer i lånesøknader grundig.
- Automatiserte assistenter besvarer rutinemessige kundespørsmål om konto døgnet rundt.
Juridisk
Kontraktanalyseverktøy avdekker ugunstige klausuler. Søkemotorer for rettspraksis henter frem presedenser. Dokumentoppsummerere gjennomgår vitneforklaringer. Due diligence-pipeliner behandler fusjoner.
- Kontraktanalyseverktøy fremhever ugunstige ansvarsklausuler umiddelbart.
- Juridiske søkemotorer henter frem relevante historiske rettspresedenser.
Produksjon
Forsyningskjedemodeller forutsier materialmangel. Vedlikeholdslogger planlegger maskinreparasjoner. Kvalitetskontrollsystemer analyserer defektrapporter. Designassistenter gjennomgår tegninger.
- Forsyningskjedemodeller forutsier tidlig risiko for mangel på råmaterialer.
- Vedlikeholdslogger planlegger proaktive maskinreparasjoner i fabrikken.
- Kvalitetskontrollsystemer analyserer defektrapporter fra montering.
- Designassistenter gjennomgår komplekse tekniske ingeniørtegninger.
Detaljhandel og netthandel
Anbefalingsmotorer foreslår relevante produkter. Lagermodeller forutsier sesongmessig etterspørsel. Flerspråklige chatboter hjelper kunder over hele verden. Sentimentanalyseverktøy gjennomgår tilbakemeldinger.
- Anbefalingsmotorer foreslår relevante produkter til nettkunder.
- Lagermodeller forutsier sesongmessig lageretterspørsel nøyaktig.
Kundeservice
Sakshåndteringssystemer ruter saker automatisk. Sentimentsporing prioriterer sinte innringere. Kunnskapsbaser genererer umiddelbare svar. Svarassistenter utformer høflige svar.
- Sakshåndteringssystemer ruter kundesaker til de riktige medarbeiderne.
- Sentimentsporing prioriterer supportkøer for sinte innringere.
- Kunnskapsbaser genererer umiddelbare svar for brukerne.
- Svarassistenter utformer høflige e-postsvar til kunder.
Hvordan velge riktig utviklingsselskap for skreddersydd LLM til din virksomhet
Å evaluere potensielle partnere for skreddersydd LLM-utvikling krever analyse av deres portefølje av driftssatte bedriftsmodeller, teknisk ekspertise innen finjusteringsrammeverk, protokoller for datasikkerhet og evner til vedlikehold etter lansering.
Her dykker vi ned i de kritiske evalueringskriteriene som kreves for å velge en pålitelig teknologileverandør som med hell kan gjøre din ambisiøse visjon for kunstig intelligens om til en sikker, produksjonsklar bedriftsvirkelighet.
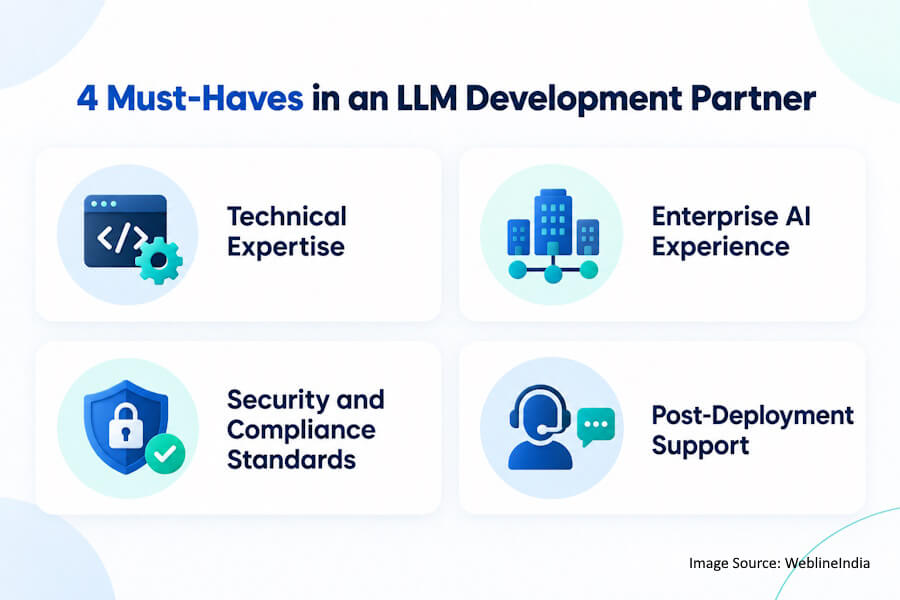
Teknisk ekspertise
Ingeniører vurderer kvalifikasjoner innen dyp læring. Team demonstrerer vellykkede modelldriftsettinger. Sertifiseringer beviser kompetanse på skyinfrastruktur. Porteføljer fremhever komplekse bedriftsløsninger.
Erfaring med bedrifts-AI
Leverandører forstår bedriftens sikkerhetskrav. Casestudier beviser bransjespesifikk kunnskap. Kundereferanser bekrefter tidligere resultater. Skaleringsevner matcher forretningsbehovene.
- Leverandører forstår strenge krav til bedriftens sikkerhetsetterlevelse.
- Casestudier beviser dyp, bransjespesifikk operativ kunnskap.
Standarder for sikkerhet og etterlevelse
Partnere håndhever strenge regler for personvern av data. Sertifiseringer verifiserer infrastruktursikkerhet. Juridiske avtaler beskytter immaterielle rettigheter. Revisjonsspor sikrer regulatorisk etterlevelse.
- Utviklingspartnere håndhever strenge interne regler for personvern av data.
- Sikkerhetssertifiseringer verifiserer robust beskyttelse av skyinfrastruktur.
- Juridiske kontrakter beskytter bedriftens proprietære immaterielle rettigheter.
- Revisjonsspor sikrer full regulatorisk etterlevelse i bransjen.
Støtte etter driftsetting
Vedlikeholdskontrakter sikrer systemets oppetid. Overvåkingstjenester følger ytelsesmålinger. Regelmessige oppdateringer holder modellene oppdaterte. Dedikerte supportteam løser feil.
- Vedlikeholdsavtaler garanterer høy oppetid for applikasjonssystemet.
- Overvåkingstjenester følger sanntidsmålinger for ytelsesnøyaktighet.
Fremtidige trender innen skreddersydd LLM-utvikling og bedrifts-AI
Landskapet for bedrifts-AI beveger seg raskt mot svært effektiv edge computing, multimodale evner og autonome agentiske arbeidsflyter som utfører komplekse forretningsprosesser i flere trinn uten menneskelig involvering.
Nå avdekker vi de kommende teknologiske gjennombruddene og strategiske innovasjonene som er i ferd med å omdefinere hvordan din virksomhet utnytter skreddersydde store språkmodeller i årene som kommer.
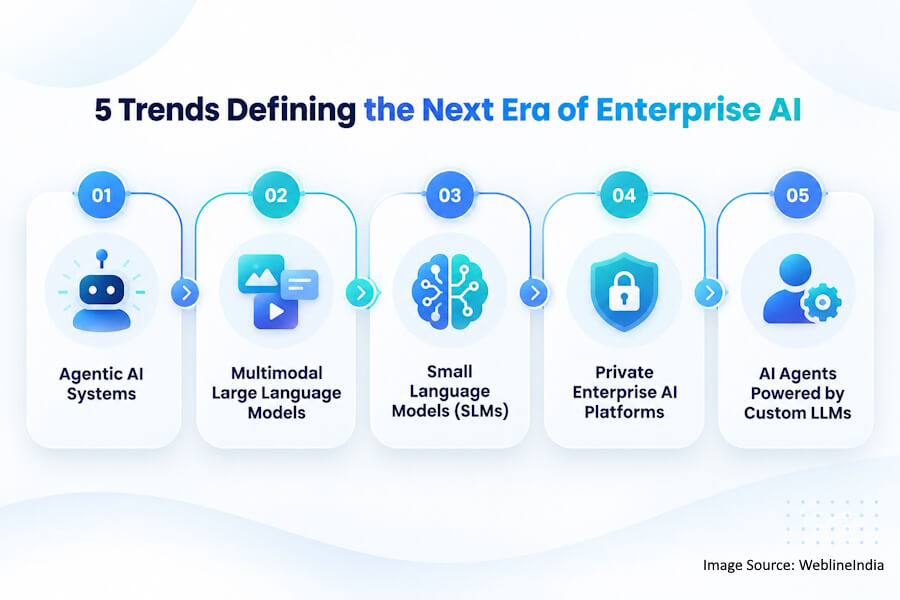
Agentiske AI-systemer
Autonome agenter utfører flertrinns arbeidsflyter. Systemer samarbeider for å løse problemer. Beslutningsmotorer håndterer komplekse oppgaver. Produktiviteten øker på tvers av avdelinger.
Multimodale store språkmodeller
Modeller behandler tekst, lyd og video. Integrerte sensorer analyserer fysiske omgivelser. Rike input forbedrer den kontekstuelle forståelsen. Bruksområdene spenner over flere sansetyper.
- Modeller behandler tekst-, lyd- og videostrømmer samtidig.
- Integrerte sensorer analyserer fysiske arbeidsmiljøer i fabrikker.
- Rike inputstrømmer forbedrer den dype kontekstuelle forståelsen.
- Bruksområdene spenner sømløst over flere typer sensoriske data.
Små språkmodeller (SLM-er)
Kompakte modeller kjører på edge-enheter. Lokal maskinvare behandler spørringer umiddelbart. Ressursbehovet synker betydelig. Personvernet forbedres gjennom lokal kjøring.
- Kompakte modeller kjører lokalt på edge-enheter.
- Lokal maskinvare behandler brukerspørringer umiddelbart.
Private bedrifts-AI-plattformer
Sikre plattformer sentraliserer verktøy for kunstig intelligens. Interne markedsplasser deler trente modeller. Styringsdashbord overvåker systembruk. Bedrifter kontrollerer sin egen AI-skjebne.
- Sikre plattformer sentraliserer bedriftens kunstig intelligens-verktøy.
- Interne markedsplasser deler skreddersydd trente modellvekter.
- Styringsdashbord overvåker bruken på tvers av hele selskapet.
- Bedrifter har full kontroll over sin egen kunstig intelligens-infrastruktur.
AI-agenter drevet av skreddersydde LLM-er
Utvikling av bedrifts-AI-agenter kan kombinere spesialiserte agenter med skreddersydde LLM-er for å utføre forretningsoperasjoner og koordinere programvarearbeidsflyter. Smarte assistenter håndterer daglige timeplaner. Effektivitetsgevinster transformerer bedriftens arbeidsflyter.
- Spesialiserte agenter utfører komplekse forretningsoperasjoner automatisk.
- Automatiserte verktøy koordinerer driftsettingspipeliner for programvareutvikling.
Avsluttende tanker om å bygge en skreddersydd LLM for langsiktig forretningssuksess
Adopsjon av kunstig intelligens avgjør fremtidens markedsledere. Generiske offentlige verktøy tilfredsstiller ikke bedriftens behov. Organisasjoner bygger skreddersydde modeller for å sikre dataene sine. Proprietære arbeidsflyter krever spesialisert intelligens. Langsiktig suksess krever robust AI-infrastruktur. Selskaper samarbeider med erfarne leverandører for å fremskynde gjennomføringen.
WeblineIndia leverer fremragende tjenester for skreddersydd LLM-utvikling. Ingeniørteam bygger sikre bedrifts-LLM-er. Spesialister finjusterer modeller for maksimal nøyaktighet. WeblineIndia transformerer forretningsdriften gjennom skreddersydde AI-løsninger. Organisasjoner oppnår varige konkurransefortrinn allerede i dag. Kontakt WeblineIndia for å starte integrasjonen av skreddersydd kunstig intelligens.
Hashtags for sosiale medier
#TilpassetLLM #StoreSpråkmodeller #BedriftsAI #GenerativAI #KunstigIntelligens #LLM #AIUtvikling #AIIngeniørfag #AgentbasertAI #AIAgenter #RetrievalAugmentedGeneration #RAG #Maskinlæring #AIInfrastruktur #DigitalTransformasjon #Bedriftsteknologi #MLOps #AIInnovasjon #PrivatAI #Forretningsautomatisering
Bygg en sikker, skalerbar skreddersydd LLM tilpasset bedriftens data og arbeidsflyter, sammen med et erfarent AI-utviklingsteam.
Ofte stilte spørsmål
Hvordan bygger jeg en tilpasset LLM for bedriften min?
Bedrifter samler inn proprietære data, velger kraftige arkitekturer med åpen kildekode, finjusterer modellvekter på sikre servere og distribuerer skalerbar infrastruktur for å automatisere interne arbeidsflyter og beskytte sensitive immaterielle eiendeler.
Bør jeg bygge eller finjustere en eksisterende LLM?
Finjustering av eksisterende grunnleggende modeller sparer penger og tid samtidig som forhåndstrent grammatikk tilpasses spesifikke domener. Opplæring fra grunnen av er fortsatt bare nødvendig for helt unike språklige eller sikkerhetsmessige krav.
Hvilke data kreves for å trene en tilpasset språkmodell?
Ingeniører samler rene interne dokumenter, tekniske manualer, historiske transkripsjoner og strukturerte databaseposter. Team må skrubbe personlige identifikatorer og formatere tekst nøye før de mater opplæringsrørledninger.
Hvor mye koster utvikling av tilpasset LLM?
Utgiftene varierer basert på parameterstørrelser, maskinvareleie og arbeidskraft for dataforberedelse. Skybaserte GPU-klynger krever betydelig kapital, mens finjustering av eksisterende adaptere reduserer de totale implementeringsbudsjettene.
Hvilken LLM med åpen kildekode er best for bedrifter?
Meta Llama og Mistral AI tilbyr eksepsjonell ytelse og åpne vekter for sikre lokale distribusjoner. Organisasjoner velger spesifikke varianter basert på parametergrenser og tilgjengelige dataressurser.
Hvor lang tid tar det å bygge en tilpasset LLM?
Tidslinjene varierer fra flere uker til flere måneder, avhengig av datasettets kompleksitet. Fasede utrullinger og forhåndstrente fundamentmodeller akselererer de første distribusjonsplanene for bedriftsteam.
Kan bedrifter lage private AI-modeller?
Bedrifter distribuerer modeller på lokal servermaskinvare eller sikre private skynett. Dette garanterer fullstendig dataisolering og forhindrer at eksterne API-leverandører ser konfidensielle bedriftsregistre.
Hvilken infrastruktur er nødvendig for LLM-utvikling?
Dyp læring krever GPU-klynger med høy ytelse, robust nettverksmaskinvare og raske vektordatabaser. DevOps-ingeniører konfigurerer skalerbare Kubernetes-noder for å håndtere store inferenstrafikkkrav.
Hvordan distribuerer bedrifter tilpassede LLM-er?
DevOps-team klargjør skyinferens-instanser eller lokale servernoder. API-gatewayer kobler sammen interne forretningsapplikasjoner mens lastbalanserere distribuerer innkommende forespørselstrafikk jevnt på tvers av servere.
Hva er fordelene med private LLM-er?
Private modeller sikrer streng databeskyttelse, eliminerer abonnementsavgifter per token og leverer nøyaktige bransjespesifikke svar. Organisasjoner beholder absolutt kontroll over modellvekter og systemsikkerhetspolicyer.
Hva er RAG, og hvordan er det sammenlignet med finjustering?
Retrieval-Augmented Generation henter dynamiske eksterne dokumenter uten å endre kjernemodellvekter. Finjustering endrer nevrale nettverksparametere direkte for spesialisert vokabular og atferdstilpasning på tvers av bedriftens arbeidsflyter.
Hvor sikre er bedriftens LLM-er?
Bedriftsplattformer håndhever strenge rollebaserte tilgangskontroller, datakryptering i ro og null-oppbevaringspolicyer. Sikkerhetsrevisjoner og lokale brannmurer beskytter konfidensiell informasjon mot ondsinnede cybertrusler.
Globalt anerkjent for enestående kvalitet og pålitelighet


Kundeuttalelser: Hør det direkte fra våre globale kunder
Våre utviklingsprosesser leverer dynamiske løsninger for å håndtere forretningsutfordringer, optimalisere kostnader og drive digital transformasjon. Løsninger støttet av eksperter styrker kundefrafall og digital tilstedeværelse, og dokumenterte suksesshistorier fremhever problemløsning i praksis gjennom innovative applikasjoner. Våre anerkjente kunder over hele verden har allerede opplevd det.
Priser og Anerkjennelser
Selv om fornøyde kunder er vår største motivasjon, har bransjeerkjennelse betydelig verdi. WeblineIndia har konsekvent ledet an innen teknologi, med priser og utmerkelser som bekrefter vår fremragende kvalitet.
OA500 Globale outsourcing‑selskaper 2025, av Outsource Accelerator
Ledende programvareutviklingsselskap, av GoodFirms
Beste fintech-produktselskap – 2022, av GESIA
Tildelt som – Beste apputviklingsselskap i India 2020, av SoftwareSuggest