Sådan bygger du en skræddersyet LLM til din virksomhed
Lær, hvordan du udvikler en skræddersyet LLM til din virksomhed, gennem en trinvis proces, der dækker dataklargøring, valg af grundmodel, finjustering, RAG, infrastruktur, implementering, sikkerhed, omkostninger og anvendelsesscenarier i virksomhedsregi.


 ChatGPT
 Perplexity
At opbygge en skræddersyet LLM til din virksomhed handler om at identificere specifikke use cases, forberede relevante data, vælge den rette modelarkitektur og implementere effektive trænings- og testprocesser. En tilpasset LLM kan forbedre automatisering, effektivitet, kundeoplevelser og beslutningstagning på tværs af hele forretningen.
Hvad er en skræddersyet Large Language Model (LLM), og hvorfor har virksomheder brug for en?
Standard fundamentale AI-modeller er lavet til brede offentlige forespørgsler. Disse generiske modeller mangler specifik operationel kontekst. Organisationer kæmper med nøjagtighedshuller. Generiske systemer hallucinerer virksomhedsspecifikke fakta. Virksomheder har brug for specialiseret domæneviden. Udvikling af en skræddersyet LLM bygger bro over netop dette hul. Proprietære data forbliver interne. Sikkerhedsprotokoller begrænser ekstern datalækage. Organisationer bygger en virksomheds-LLM til at behandle følsomme dokumenter.
Skræddersyede AI-udviklingstjenester retter sig mod specifikke arbejdsgange. Medarbejdere uploader interne tekniske manualer. Systemet lærer proprietær terminologi øjeblikkeligt. Udvikling af Large Language Models involverer omfattende parameterjustering. Virksomheder bevæger sig fra offentlige værktøjer til sikker infrastruktur. Private LLM-implementeringer garanterer dataisolering. Finansielle institutioner behandler fortrolige indberetninger sikkert. Sundhedsudbydere beskytter patientjournaler omhyggeligt.
Standardmodeller fejler på tekniske forespørgsler. Skræddersyet GPT-udvikling imødekommer nichebrancher. Organisationer bruger AI-modeludvikling til at automatisere komplekse skriveopgaver. Virksomheds-AI-modeller forstår interne nøgletal. Virksomheder tager open source-LLM-løsninger i brug for at bevare ejerskab over koden. Denne tilgang eliminerer abonnementsgebyrer til tredjepart. Proprietære vægte forbliver på lokale servere. Høj driftsmæssig kontrol styrker interne udviklingsteams. AI-infrastruktur kræver kraftfulde compute-klynger. Ingeniører konfigurerer distribuerede processeringsnoder.
De vigtigste fordele ved at bygge en skræddersyet LLM til virksomhedsapplikationer
At bygge en skræddersyet Large Language Model (LLM) giver organisationer mulighed for at bevare sikkerheden omkring proprietære data, drastisk reducere hallucinationer gennem domænespecifik finjustering og problemfrit automatisere komplekse interne arbejdsgange.
Lad os forstå, hvorfor det at skræddersy en AI-model specifikt til jeres organisatoriske data låser op for enestående driftsmæssig effektivitet og en reel konkurrencefordel i moderne virksomhedsmiljøer.
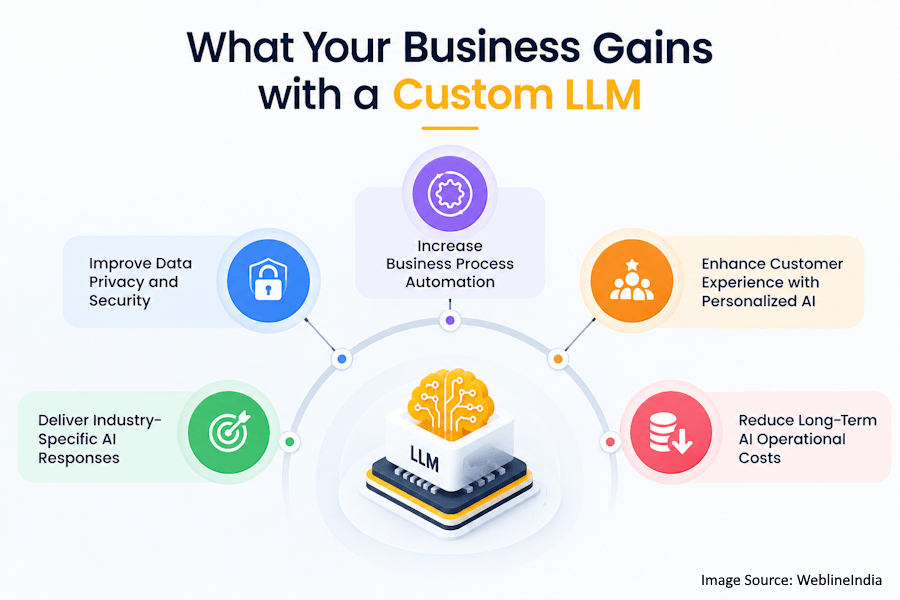
Forbedr databeskyttelse og sikkerhed
Offentlige AI-platforme gemmer brugerinput. Eksterne servere modtager proprietære virksomhedshemmeligheder. Virksomheder risikerer alvorlige lovmæssige sanktioner. Skræddersyede AI-modeludviklingstjenester eliminerer risici ved offentlig cloud. Data forbliver i lokale datacentre. Sikkerhedsteams krypterer information i hvile. Medarbejdere deler fortrolige rapporter sikkert. Compliance-ansvarlige håndhæver strenge adgangskontroller. Udvikling af private LLM’er beskytter immaterielle rettigheder.
- Virksomhedens servere gemmer prompt-logs lokalt.
- Eksterne API-udbydere ser aldrig interne data.
- Sikkerhedsingeniører konfigurerer strenge firewall-regler.
Lever branchespecifikke AI-svar
Generiske modeller misforstår teknisk fagsprog. Specialiserede domæner kræver præcist ordforråd. Skræddersyede LLM-udviklingstjenester træner modeller på nichespecifikke datasæt. Ingeniører finjusterer en LLM for at opnå forretningsmæssig nøjagtighed. Advokatfirmaer uploader arkiver med retspraksis. Medicinske forskere behandler noter fra kliniske forsøg. Systemet leverer korrekt terminologi.
- Juridiske databaser fodrer specialiserede træningspipelines med historiske dokumenter.
- Medicinske tidsskrifter forbedrer nøjagtigheden af kliniske forespørgsler til brug i hospitalsdiagnostik.
- Ingeniørteams integrerer tegninger for at guide tekniske ræsonnementsmotorer.
Øg automatiseringen af forretningsprocesser
Manuel sortering af dokumenter dræner menneskelige arbejdstimer. LLM’er kan også komplementere tjenester til automatisering af forretningsprocesser ved at understøtte arbejdsgange som dokumentbehandling, sagsrouting og informationsudtræk. Systemer ruter indgående supporthenvendelser øjeblikkeligt. Virksomheds-AI-udviklingstjenester kan understøtte arkitekturer, der er designet til at holde følsomme forretningsdata inden for kontrollerede miljøer. Algoritmer udtrækker data fra ustrukturerede fakturaer. Virksomheds-AI-modeller udfører forretningslogik med flere trin.
- Automatiseret fakturabehandling sparer regnskabsafdelinger for hundredvis af manuelle arbejdstimer hver eneste måned.
- Support-chatbots løser tekniske sager øjeblikkeligt ved at referere til interne fejlfindingswikis.
- Logistiksystemer analyserer fragtmanifester automatisk for at opdatere lagerdatabaser.
- Fejl i dataindtastning falder markant på tværs af virksomhedens afdelinger.
Forbedr kundeoplevelsen med personaliseret AI
Generiske svar frustrerer kunderne. Kunder efterspørger kontekstuel assistance. Udvikling af forretnings-AI-modeller integrerer databaser med kundehistorik. Platformen husker tidligere køb. Supportmedarbejdere løser sager hurtigere. Kundeloyaliteten stiger støt.
- Anbefalingsmotorer analyserer tidligere købsadfærd for at foreslå relevante varer.
- Chatbots refererer til den enkelte kundes abonnementsniveau for at levere præcis support baseret på kontotype.
Reducer AI-driftsomkostninger på lang sigt
Eksterne API-tokens akkumulerer høje gebyrer. Stor trafikmængde i virksomheden øger de månedlige regninger. Virksomheder træner deres egen sprogmodel for at undgå betaling pr. token. Faste hardwareomkostninger erstatter variabel API-fakturering. Organisationer styrer budgetter forudsigeligt.
- Faste infrastrukturomkostninger erstatter stigende API-regninger i perioder med høj trafik.
- Store forespørgselsmængder kører billigere på lokale virksomheds-GPU’er over tid.
- Interne teams optimerer selv inferenshastigheden uden begrænsninger fra tredjepartsplatforme.
- Ressourceallokering matcher effektivt de præcise efterspørgselstoppe i virksomheden.
Omdan jeres virksomhedsdata til en sikker, domænespecifik AI-løsning bygget omkring jeres arbejdsgange, brugere og virksomhedskrav.
Skræddersyet LLM vs. præ-trænet LLM: Hvilken AI-model er den rette for din virksomhed?
Præ-trænede modeller giver øjeblikkelige, omkostningseffektive muligheder til generelle opgaver, mens skræddersyede modeller leverer uovertruffen sikkerhed og præcision, tilpasset nøjagtigt til jeres unikke branchesprog.
Lad os dykke ned i en grundig sammenligning for at afgøre, hvilken strategisk vej der passer bedst til jeres langsigtede forretningsmål.
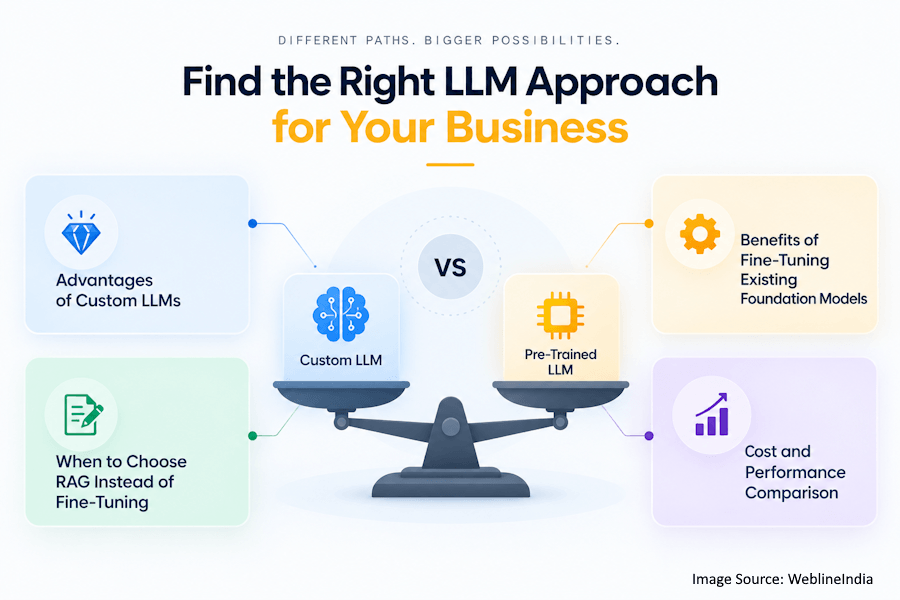
Fordele ved skræddersyede LLM’er
Organisationer ejer selv deres modelvægte. Ingeniører ændrer direkte lagene i det neurale netværk. Skræddersyet LLM-udvikling giver uovertruffen arkitektonisk kontrol. Proprietære algoritmer beskytter konkurrencefordele. Sikkerhedspolitikker håndhæver regler om nul dataopbevaring. Ydeevnen matcher præcis virksomhedens arbejdsbelastning.
- Fuldt ejerskab forhindrer fastlåsning hos leverandøren og vilkårlige prisændringer.
- Finjusteringsparametre tilpasser sig nicheindustrielle domæner med høj præcision.
- Inferenshastigheden optimeres til specifikke hardwarekonfigurationer i lokale datacentre.
Fordele ved at finjustere eksisterende fundamentmodeller
At bygge fra bunden koster millioner. Finjusteringstjenester til AI-modeller kan reducere behovet for træning fra bunden ved at tilpasse eksisterende fundamentmodeller til domænespecifikke krav. Eksisterende modeller giver et solidt grammatisk udgangspunkt. Domænespecifikke datasæt tilpasser de præ-trænede vægte. Træningscyklusser afsluttes inden for dage. Ingeniører udnytter open source-rammeværker til LLM-udvikling.
- Præ-trænede vægte giver hurtig grundlæggende kompetence uden omfattende træning fra bunden.
- De beregningsmæssige udgifter forbliver lavere end fulde flermillion-dollar træningskørsler.
- Specialiserede datasæt omdirigerer generelle ræsonnementsevner mod specifikke forretningsopgaver.
- Udviklingstiden krymper fra år til uger.
Hvornår man skal vælge RAG frem for finjustering
Træning ændrer modellens kernevægte. Retrieval-Augmented Generation lader vægtene være urørte. Virksomheder opdaterer eksterne videnbaser dagligt. RAG-systemer henter dokumenter dynamisk. Ingeniører vælger RAG til wikis, der ændres ofte. Udviklingsomkostningerne forbliver minimale.
- Dynamiske dokumentopdateringer kræver ingen genoptræningscyklusser eller vægtopdateringer.
- Eksterne vektordatabaser gemmer virksomhedens live wikis til øjeblikkelig hentning.
Sammenligning af omkostninger og ydeevne
Skræddersyede arkitekturer kræver massive computerklynger. Finjustering af fundamentmodeller kræver moderate GPU-lejemål. RAG-arkitekturer er afhængige af hurtige vektorsøgninger. Finansielle planlæggere beregner det præcise investeringsafkast. Ydeevnebenchmarks afgør det arkitektoniske valg.
- Skræddersyet fortræning medfører beregningsregninger på flere millioner dollars for rå træningskørsler.
- Finjustering kræver beskedne cloud-GPU-budgetter til opdatering af adaptervægte.
- RAG-implementeringer optimerer omkostninger til databaselagring, samtidig med at høj faktuel nøjagtighed opretholdes.
- Latensmålinger styrer de endelige produktionsvalg på tværs af forskellige forretningsenheder.
Trin-for-trin-proces til at bygge en skræddersyet LLM til din virksomhed
At bygge en skræddersyet LLM indebærer at definere specifikke forretnings-use cases, indsamle og rense proprietære data, vælge den rette basismodel, finjustere gennem specialiseret træning og grundigt evaluere ydeevnen inden sikker udrulning i virksomheden.
Lad os udforske hver fase i detaljer for at se, hvordan denne strukturerede køreplan sikrer, at jeres AI-implementering lykkes problemfrit.
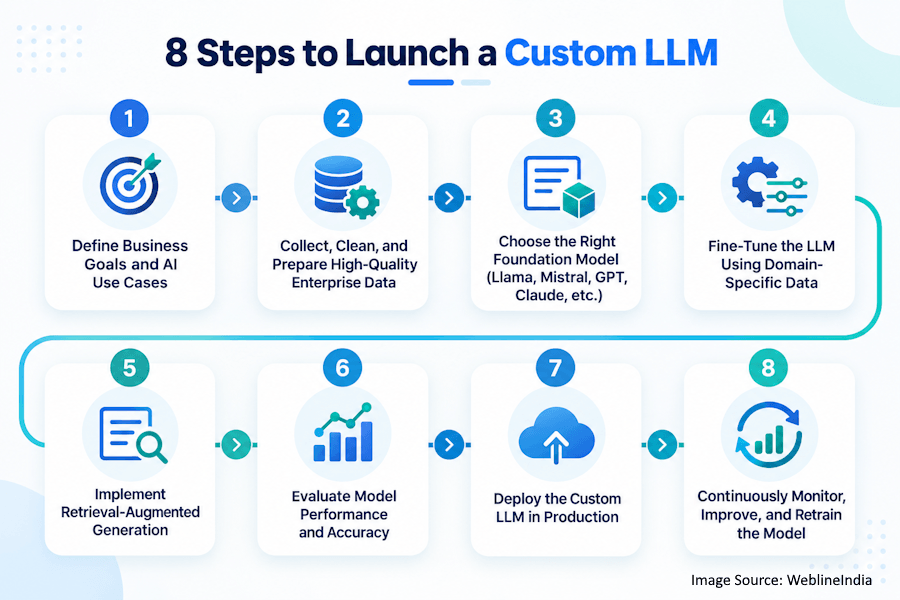
Definér forretningsmål og AI-use cases
Ledelsen skitserer præcise driftsmæssige flaskehalse. Ingeniører identificerer gentagne manuelle opgaver. Projektledere definerer succeskriterier. Klare mål forhindrer spild af computerressourcer. Interessenter gennemgår tilpasningsdokumenter grundigt.
Indsaml, rens og forbered data af høj kvalitet fra virksomheden
Rå virksomhedsdata indeholder formateringsfejl. Ingeniører renser konsekvent duplikerede poster. Tekstparsere fjerner følsomme personoplysninger. Rensede datasæt fodrer træningspipelines. Høj datakvalitet sikrer pålidelige resultater.
- Dataingeniører udtrækker rå tekst fra ældre virksomhedsdatabaser.
- Automatiserede scripts fjerner beskadigede tegnkodninger fra dokumenter.
- Rensning for personhenførbare oplysninger (PII) beskytter medarbejdernes privatliv, før træningen påbegyndes.
- Formaterede JSON-filer organiserer træningsdata korrekt til modellerne.
Vælg den rette fundamentmodel (Llama, Mistral, GPT, Claude m.fl.)
Valget af model afgør succesen længere nede ad linjen. Ingeniører tester flere basisarkitekturer. Åbne vægte giver frihed til lokal implementering. Proprietære modeller giver et solidt ræsonnementsgrundlag. Licensaftaler bestemmer de kommercielle brugsrettigheder.
- Benchmarktests evaluerer grundlæggende ræsonnementshastigheder på tværs af forskellige kandidatmodeller.
- Licensvilkår tillader kommerciel virksomhedsimplementering uden juridiske risici.
Finjustér LLM’en med domænespecifikke data
Specialiserede adaptere ændrer modellens adfærd, mens udviklingstjenester inden for machine learning kan understøtte den bredere arbejdsgang med træning, validering og modeludvikling. Loss-kurver falder under epoch-iterationer. Ingeniører validerer resultater mod testdatasæt. De endelige vægte gemmes i sikre repositories.
- LoRA-adaptere minimerer antallet af aktive træningsparametre under finjustering.
- GPU-klynger behandler terabytes af domænetekst effektivt.
- Loss-målinger følger konvergenshastigheden gennem modellens træningsepoker.
Implementer Retrieval-Augmented Generation
Tekstopdelere opdeler lange virksomhedsrapporter i mindre dele. Embedding-modeller konverterer tekst til vektorer. Vektordatabaser indekserer semantisk information. Søgealgoritmer henter relevant dokumentkontekst. Prompts kombinerer den hentede information med forespørgslerne.
- Tekstopdeling opdeler effektivt store manualer i mindre segmenter.
- Embedding-modeller oversætter ord til numeriske vektorer til indeksering.
- Vektordatabaser opbevarer multidimensionelle semantiske indekser til hurtige forespørgsler.
- Kontekstinjektion forankrer modellens svar i verificerede fakta.
Evaluer modellens ydeevne og nøjagtighed
Automatiserede testscripts måler kvaliteten af svarene. Menneskelige bedømmere vurderer subjektive resultater. Benchmarksuiter tester grænserne for ræsonnement. Sikkerhedsfiltre tester for sårbarheder over for prompt injection. Dårlige resultater udløser øjeblikkelig genoptræning.
- Automatiserede evalueringsscripts kører benchmark-testsuiter mod resultaterne.
- Menneskelige eksperter vurderer manuelt den domænespecifikke nøjagtighed til kvalitativ gennemgang.
Udrul den skræddersyede LLM i produktion
DevOps-tjenester kan understøtte etableringen af cloud-inferensservere, deploymentpipelines og skalerbare produktionsmiljøer til skræddersyede LLM’er. Loadbalancere fordeler den indgående brugertrafik. API-endpoints forbinder interne applikationer. Overvågningsværktøjer holder øje med systemets sundhedstilstand. Produktionsmiljøer sikrer høj oppetid.
- Kubernetes-klynger skalerer automatisk inferensnoder under trafiktoppe.
- API-gateways håndterer sikkert virksomhedsbrugeres autentifikationstokens.
- Loadbalancere fordeler tung forespørgselstrafik jævnt mellem servere.
- Fallback-løsninger forhindrer uventet systemnedetid under vedligeholdelse.
Overvåg, forbedr og genoptræn modellen løbende
Brugerfeedback fremhæver driftsmæssige fejl. Logningspipelines fanger forkerte svar. Data scientists udvælger nye træningsdata. Planlagt genoptræning opdaterer modellens vægte. Virksomhedssystemer udvikler sig i takt med forretningens behov.
- Feedback-knapper fanger brugerens vurderinger øjeblikkeligt efter generering.
- Logningssystemer markerer gentagne hallucinationshændelser til gennemgang.
- Datapipelines indsamler ugentligt nyligt opdaterede virksomhedspolitikker.
- Planlagte genoptræningscyklusser holder intelligensen opdateret i forhold til markedet.
Klar til at omdanne jeres LLM-køreplan til en produktionsklar løsning? Vores AI-ingeniører kan hjælpe jer med at bygge, finjustere, udrulle og skalere den.
Sådan vælger du den bedste fundamentmodel til skræddersyet LLM-udvikling
At vælge en optimal fundamentmodel kræver en afvejning af afgørende parametre som beregningsoverhead, arkitektoniske licensbegrænsninger, domænespecifik grundydelse og krav til inferenslatens op mod organisationens specifikke tekniske begrænsninger.
Lad os analysere, hvordan man systematisk evaluerer disse arkitektoniske variabler for at finde den model, der maksimerer både kapacitet og omkostningseffektivitet.
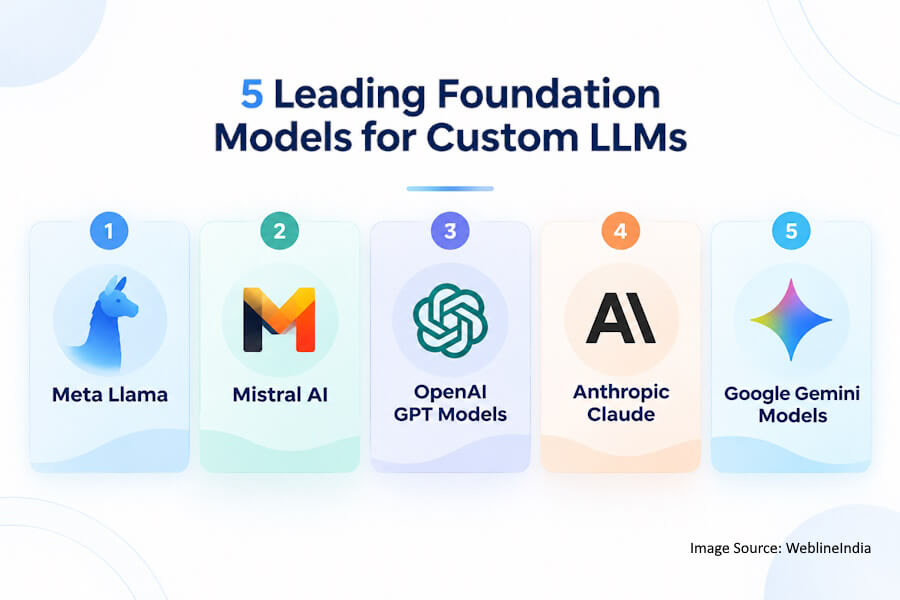
Meta Llama
Åbne vægte tiltrækker virksomhedsudviklere. Lokal implementering garanterer datasikkerhed. Finjustering af Llama-modeller kræver standardhardware. Community-fora tilbyder omfattende fejlfindingsguider.
- Open source-vægte muliggør lokaliseret serverimplementering bag firewalls.
- Parameterstørrelser spænder fra små til massive virksomhedskonfigurationer.
Mistral AI
Europæisk ingeniørkunst driver høj effektivitet. Kompakte modeller leverer hurtige inferenshastigheder. Virksomhedskunder licenserer proprietære vægtvarianter. Arkitekturdesign optimerer hukommelsesforbruget.
- Effektiv arkitektur reducerer den operationelle computeroverhead betydeligt.
- Kompakte modelstørrelser fremskynder svartiden for brugerne.
- Stærke ræsonnementsbenchmarks matcher større konkurrenter i branchen.
- Fleksibel licensering passer til forskellige kommercielle virksomhedsstrukturer.
OpenAI GPT-modeller
Proprietære API’er tilbyder stærke ræsonnementsgrundlag. Udviklere slipper for at administrere infrastrukturklynger. Regelmæssige opdateringer introducerer avancerede funktionssæt. Privatlivspolitikker beskytter virksomhedens kundedata.
- Managed API’er eliminerer infrastrukturvedligeholdelsesopgaver for interne teams.
- Avanceret ræsonnement håndterer nemt komplekse logiske problemer uden finjustering.
Anthropic Claude
Lange kontekstvinduer behandler hele bøger. Sikkerhedsforanstaltninger minimerer skadelige output. Virksomhedskunder integrerer sikre API-endpoints. Finansanalytikere analyserer store regneark direkte.
- Massive kontekstvinduer indtager hele kodebaser og omfattende rapporter.
- Indbygget “constitutional” sikkerhed reducerer skadelige eller giftige output.
- Dokumentanalyse udtrækker struktureret data fra tætte finansielle sider.
Google Gemini-modeller
Multimodale funktioner behandler tekst og video. Cloud-infrastruktur integrerer native AI-værktøjer. Virksomhedssøgefunktioner forbinder interne drev. Skalerbare arkitekturer håndterer store arbejdsbelastninger.
- Native multimodalitet behandler billeder og videostreams direkte.
- Google Cloud-integration forenkler virksomhedens deploymentpipelines.
Infrastruktur og teknologistack, der kræves til skræddersyet LLM-udvikling
Udvikling af en robust skræddersyet LLM kræver højtydende computerklynger udstyret med specialiserede GPU’er, skalerbare datapipelines, virksomhedsorkestreringsrammeværker og sikre vektordatabaser til retrieval-augmented generation.
Lad os se nærmere på den nødvendige tekniske arkitektur, der skal drive jeres AI-infrastruktur effektivt.
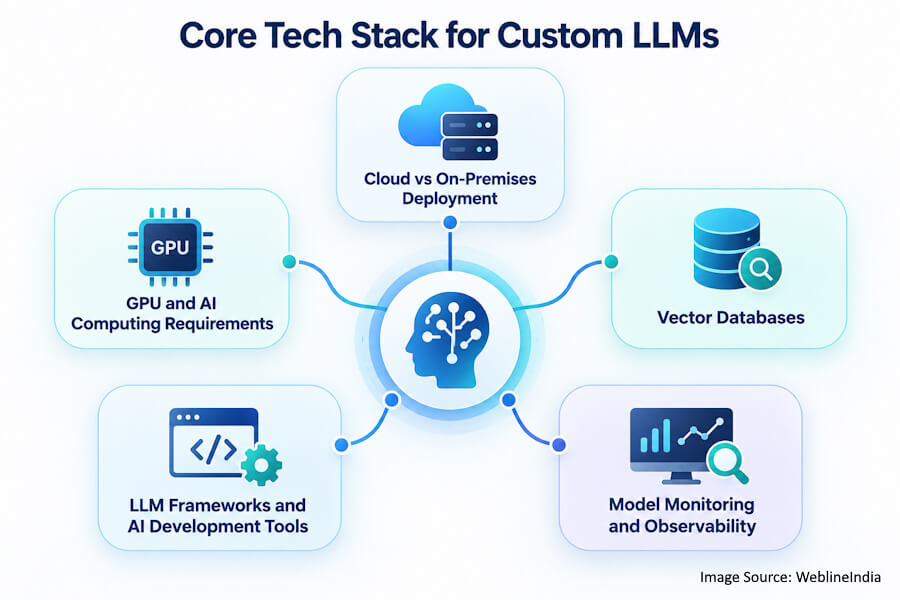
Cloud vs. on-premises-implementering
Cloud-udbydere tilbyder elastisk GPU-skalering. On-premises-servere beskytter yderst klassificerede hemmeligheder. Finansielle regler dikterer regler for hardwareplacering. Hybride arkitekturer balancerer omkostninger og sikkerhed.
Krav til GPU og AI-computerkraft
Deep learning kræver specialiserede acceleratorchips. Høj VRAM-kapacitet indlæser store modeller. Interconnect-hastigheder fremskynder distribuerede træningsopgaver. Strømforbrug driver budgetterne for datacentre.
- NVIDIA H100-klynger fremskynder modellens træningstider drastisk.
- Høje VRAM-kapaciteter indlæser massive parametervægte sikkert.
- Højhastigheds-interconnects forbinder flere træningsnoder uden latens.
Vektordatabaser
Embeddings kræver specialiserede lagringsløsninger. Lighedssøgninger henter matchende dokumentsegmenter. Skalerbare arkitekturer håndterer milliarder af vektorer. Indekseringshastighed påvirker forespørgselslatens.
- Pinecone administrerer effektivt cloud-native vektorsøgeindekser.
- Milvus skalerer problemfrit på tværs af distribuerede lokale serverklynger.
- Qdrant håndterer hurtige metadatafiltreringsoperationer under søgning.
LLM-rammeværker og AI-udviklingsværktøjer
Python-biblioteker forenkler opbygningen af pipelines. Orkestreringsværktøjer sammenkæder komplekse agenttrin. Kvantiseringspakker reducerer modellers hukommelsesaftryk. Containeriseringsværktøjer standardiserer deploymentmiljøer.
- LangChain orkestrerer komplekse, flertrinnede AI-agent-arbejdsgange.
- LlamaIndex forbinder eksterne dokumenter til modeller til brug i RAG.
Modelovervågning og observability
Målinger følger forbruget af tokens. Fejlregistrering afslører fejlpunkter i prompts. Drift-detektion opdager faldende nøjagtighedstendenser. Sikkerhedsscannere blokerer ondsindede input.
- Grafana-dashboards viser systemressourceforbrug i realtid.
- Logningsværktøjer fanger fejlspor fra brugerprompts til analyse.
- Drift-overvågning advarer ingeniører om fald i ydeevnen.
- Sikkerhedsfiltre blokerer uautoriserede forsøg på prompt injection.
Almindelige udfordringer ved skræddersyet LLM-udvikling, og hvordan man overvinder dem
Skræddersyet LLM-udvikling introducerer ofte udfordringer som stigende beregningsomkostninger, risici for databeskyttelse, katastrofal glemsel under finjustering og håndtering af model-drift over tid.
Lad os afdække de dokumenterede afhjælpningsstrategier, der kræves for succesfuldt at navigere gennem disse almindelige tekniske forhindringer.
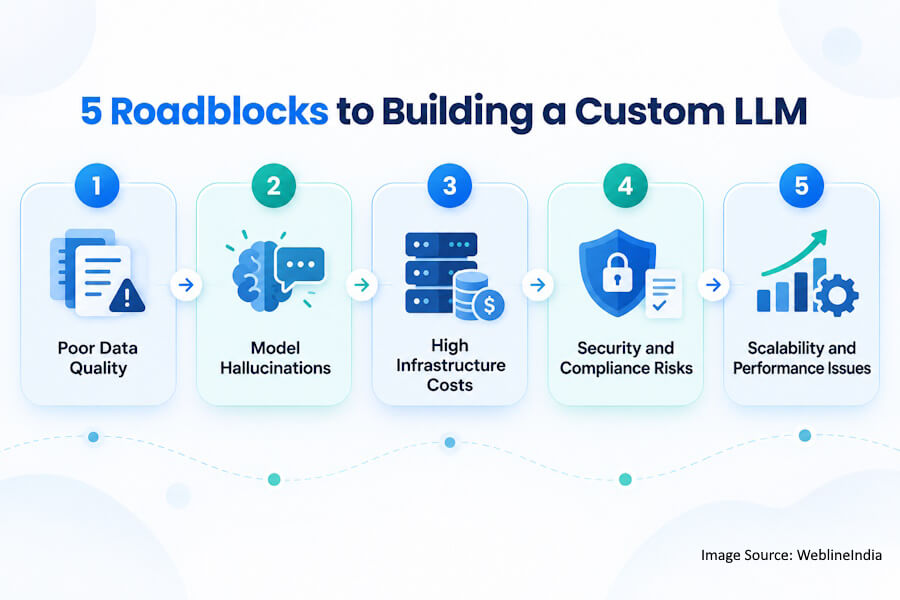
Dårlig datakvalitet
Ufuldstændige dokumenter forårsager uforudsigelig modeladfærd. Datarensningspipelines fjerner støj. Automatiserede valideringsscripts kontrollerer tekstformater. Menneskelige revisorer verificerer datasættets integritet.
- Manglende dokumentafsnit skaber logiske ræsonnementshuller under træningen.
- Automatiserede regex-scripts renser filer for beskadigede teksttegn.
Modelhallucinationer
Modeller opfinder falske historiske fakta. RAG-arkitekturer forankrer svar i virkeligheden. Strenge temperaturindstillinger reducerer kreativ opdigtning. Evalueringssuiter fanger fejl tidligt.
- Forankrende prompts begrænser svar strengt til de leverede kildedokumenter.
- Lave temperaturindstillinger reducerer graden af tilfældig outputgenerering.
- Krav om kildehenvisning tvinger modeller til at referere til dokumentkilder.
Høje infrastrukturomkostninger
GPU-leje dræner virksomhedens budgetter. Modelkvantisering reducerer hukommelsesaftrykket. Mindre modeller erstatter massive fundamentsystemer. Effektiv batching maksimerer hardwareudnyttelsen.
- Modelkvantisering halverer filstørrelser uden tab af kvalitet.
- Spot-GPU-instanser sænker cloud-leje-regningerne betydeligt.
- Batching af forespørgsler maksimerer udnyttelsen af den aktive hardwarekapacitet.
Risici for sikkerhed og compliance
Datalæk udløser lovmæssige bøder. Krypteringsprotokoller sikrer gemte filer. Adgangskontrollister begrænser brugerrettigheder. Regelmæssige audits verificerer systemets integritet.
- Krypteringsstandarder beskytter filer under interne netværksoverførsler.
- Rollebaseret adgang begrænser synligheden af følsomme dokumenter på tværs af afdelinger.
- Compliance-audits verificerer overholdelse af branchens lovmæssige rammer.
- Penetrationstests afdækker skjulte sikkerhedssårbarheder i applikationer.
Udfordringer med skalerbarhed og ydeevne
Høj brugertrafik forårsager flaskehalse i serverne. Loadbalancere fordeler indgående forespørgselsbelastning. Caching-lag gemmer resultater fra hyppige forespørgsler. Asynkrone køer håndterer store arbejdsbelastninger.
- Loadbalancere forhindrer nedbrud på grund af overbelastning af en enkelt server under trafiktoppe.
- Caching af svar leverer identiske forespørgsler øjeblikkeligt uden inferens.
Hvor meget koster det at bygge en skræddersyet LLM til din virksomhed?
At opbygge en skræddersyet virksomheds-LLM indebærer varierende økonomiske forpligtelser, fra grundlæggende API-konfigurationer til ressourcekrævende træningspipelines. Organisationer skal medregne overhead til GPU-beregning, pipelines til dataforberedelse, specialiseret teknisk talent og langsigtede vedligeholdelsesomkostninger.
Lad os gennemgå de reelle finansielle variabler og budgetoverslag for at hjælpe jer med at planlægge en præcis investeringsstrategi til jeres kommende AI-projekt.
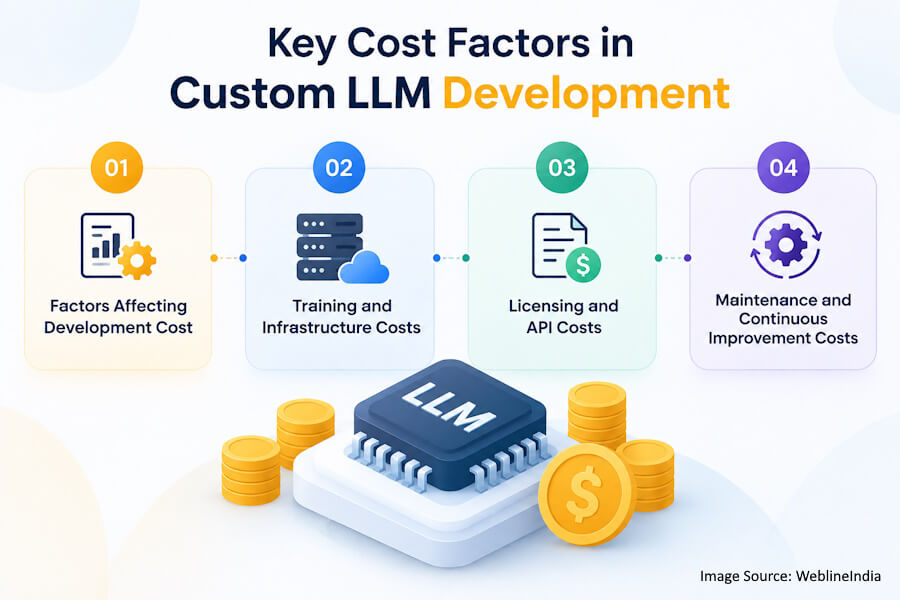
Faktorer, der påvirker udviklingsomkostningerne
Datasættets størrelse påvirker arbejdet med dataforberedelse, mens modellens antal parametre bestemmer hardwarebehovet. AI-konsulenttjenester kan hjælpe organisationer med at vurdere integrationens kompleksitet, infrastrukturkrav og andre faktorer, der påvirker projektets omfang.
- Store datasæt kræver omfattende manuel oprydningstid fra ingeniører.
- Modeller med mange parametre kræver dyr high-end GPU-hardware.
Trænings- og infrastrukturomkostninger
Computerklynger kræver betydelig finansiering. Elregninger tilføjer løbende driftsomkostninger. Cloud-udbydere opkræver timepriser for GPU. Hardwarekøb kræver forudgående kapital.
- Cloud-GPU-leje pr. time akkumuleres hurtigt under træningskørsler.
- Overhead til strøm og køling øger faciliteternes budgetter til servere.
- Opsætning af klynger kræver dyrt højhastigheds-netværksudstyr.
- Vedligeholdelseskontrakter dækker uventede hardwarefejl på serverkomponenter.
Licens- og API-omkostninger
Proprietære fundamentmodeller opkræver abonnementsgebyrer. Tilladelser til kommerciel brug medfører ekstra gebyrer. Open source-vægte eliminerer tilbagevendende licensregninger. Juridiske gennemgange sikrer compliance.
- Kommercielle API-tokens akkumulerer månedlige gebyrer baseret på volumen.
- Abonnementer på proprietære modeller skalerer med antallet af aktive brugere.
- Open source-vægte undgår byrden af tilbagevendende softwarelicensgebyrer.
Omkostninger til vedligeholdelse og løbende forbedring
Modeller kræver løbende genoptræningscyklusser. Udviklingsteams retter driftsmæssige fejl. Sikkerhedsopdateringer beskytter infrastrukturens servere. Overvågningsværktøjer medfører abonnementsgebyrer.
- Genoptræningspipelines indsamler regelmæssigt nyligt opdaterede virksomhedsdokumenter.
- Supportingeniører fejlfinder dagligt uventede fejllogfiler i produktionen.
- Sikkerhedsteams anvender softwarepatches på virksomhedens servere.
- Observability-værktøjer opkræver gebyrer baseret på mængden af logdata.
Få et realistisk overslag for en skræddersyet LLM baseret på jeres use case, data, valg af model, integrationer, infrastruktur og krav til udrulning.
Best practices for at bygge sikre, nøjagtige og skalerbare virksomheds-LLM’er
Implementering af robuste virksomheds-LLM’er kræver håndhævelse af streng datakryptering, etablering af kontinuerlige feedback-loops for at minimere hallucinationer og design af horisontale skaleringsarkitekturer til håndtering af spidsbelastninger.
Lad os udforske de centrale udrulningsstrategier, der sikrer, at jeres AI-økosystem forbliver beskyttet, yderst præcist og uendeligt tilpasningsdygtigt til fremtidig organisatorisk vækst.
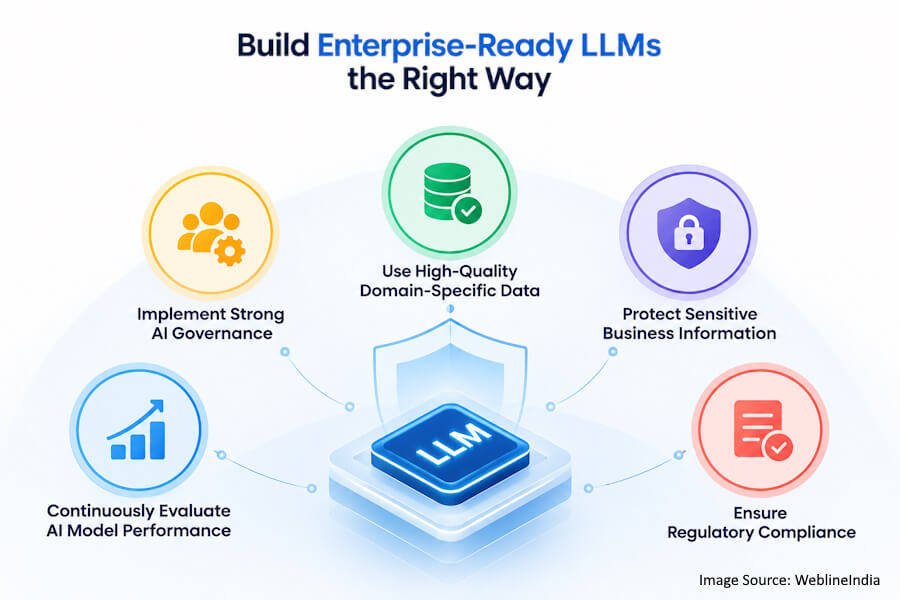
Implementer stærk AI-governance
Udvalg fører tilsyn med AI-projekter. Etiske retningslinjer forhindrer forudindtagede output. Versionsstyring følger modelopdateringer. Dokumentation registrerer arkitektoniske beslutninger.
Brug domænespecifikke data af høj kvalitet
Kuraterede datasæt forbedrer nøjagtigheden af output. Fjernelse af støj eliminerer forvirrende tekst. Standardiserede formater strømliner træningspipelines. Regelmæssige audits vedligeholder datakvaliteten.
- Kuraterede datasæt giver klare semantiske læringssignaler til modellerne.
- Støjreduktion filtrerer irrelevant internettekst helt fra.
- Standardiserede skemaer organiserer korrekt virksomhedsdokumenter fra flere kilder.
Beskyt følsomme forretningsoplysninger
Datamaskering skjuler fortrolige tal. Lokale servere isolerer proprietære filer. Politikker om nul dataopbevaring beskytter brugernes privatliv. Netværksfirewalls blokerer eksterne trusler.
- Datamaskering erstatter rigtige navne med sikre pladsholdere.
- Lokal serverimplementering isolerer filer fra offentlige netværk.
- Aftaler om nul dataopbevaring beskytter strengt virksomhedens prompt-privatliv.
- Netværksfirewalls blokerer uautoriserede eksterne indtrængningsforsøg.
Evaluer løbende AI-modellens ydeevne
Automatiserede benchmarks måler nøjagtighedstendenser. Brugerfeedback flager driftsmæssige problemer. Red teaming afdækker skjulte sårbarheder. Regelmæssige gennemgange opdaterer ydeevnemål.
- Automatiserede testscripts følger nøjagtighedstendenser over tid.
- Brugernes vurderingsknapper fanger øjeblikkelig feedback om ydeevne fra den virkelige verden.
Sikr regulatorisk compliance
Juridiske teams gennemgår praksis for datahåndtering. GDPR-retningslinjer beskytter kundernes privatliv. Branchestandarder dikterer sikkerhedskontroller. Dokumentation dokumenterer overholdelse af lovgivningen.
- Juridiske gennemgange sikrer overholdelse af strenge databeskyttelseslove.
- GDPR-protokoller håndterer brugersamtykke og anmodninger om sletning af data.
- Branchestandarder foreskriver specifikke krav til krypteringsnøglers styrke.
Praktiske use cases for skræddersyet LLM-udvikling på tværs af brancher
Skræddersyede LLM’er transformerer brancher ved at automatisere kompleks juridisk dokumentanalyse i finanssektoren, drive hyper-personaliserede diagnoseforslag inden for sundhedssektoren og styre hyper-målrettet lagerlogistik i detailhandlen. Opdag, hvordan organisationer på tværs af forskellige sektorer udnytter disse skræddersyede systemer til at optimere arbejdsgange, skære drastisk ned på omkostninger og sikre sig en massiv konkurrencefordel.
Sundhedssektoren
Kliniske modeller opsummerer patienthistorik. Medicinske forskere analyserer studier af lægemiddelinteraktioner. Diagnostiske assistenter behandler scanningsnoter. Administrative arbejdsgange fremskynder fakturering.
- Kliniske modeller opsummerer omfattende patientjournaler for læger.
- Forskningsværktøjer analyserer hurtigt komplekse studier af lægemiddelinteraktioner.
Bank og finansielle tjenester
Algoritmer til bedrageribekæmpelse analyserer transaktionsstrømme. Algoritmiske handlere behandler markedsrapporter. Compliance-systemer gennemgår låneansøgninger. Automatiserede agenter besvarer kontospørgsmål.
- Algoritmer til bedrageribekæmpelse markerer øjeblikkeligt mistænkelige transaktionsstrømme.
- Finansielle modeller analyserer regnskabsrapporter for virksomhedens investorer.
- Compliance-værktøjer gennemgår grundigt risikofaktorer i låneansøgninger.
- Automatiserede assistenter besvarer rutinemæssige kontospørgsmål fra kunder 24/7.
Jura
Kontraktanalyseværktøjer identificerer ugunstige klausuler. Søgemaskiner til retspraksis henter præcedenser. Dokumentopsummeringsværktøjer gennemgår vidneforklaringer. Due diligence-pipelines behandler fusioner.
- Kontraktanalyseværktøjer fremhæver øjeblikkeligt ugunstige ansvarsklausuler.
- Juridiske søgemaskiner henter relevante historiske retspræcedenser.
Produktion
Modeller for forsyningskæder forudsiger materialemangel. Vedligeholdelseslogs planlægger maskinreparationer. Kvalitetskontrolsystemer analyserer fejlrapporter. Designassistenter gennemgår tegninger.
- Modeller for forsyningskæder forudsiger tidligt risici for mangel på råmaterialer.
- Vedligeholdelseslogs planlægger proaktive maskinreparationer på fabrikken.
- Kvalitetskontrolsystemer analyserer fejlrapporter fra samlebåndet.
- Designassistenter gennemgår komplekse tekniske tegninger.
Detailhandel og e-handel
Anbefalingsmotorer foreslår relevante produkter. Lagermodeller forudsiger sæsonbestemt efterspørgsel. Flersprogede chatbots hjælper kunder på tværs af landegrænser. Sentimentanalyseværktøjer gennemgår feedback.
- Anbefalingsmotorer foreslår relevante produkter til onlinekunder.
- Lagermodeller forudsiger nøjagtigt sæsonbestemt lagerefterspørgsel.
Kundesupport
Ticketing-systemer ruter sager automatisk. Sentimentovervågning prioriterer vrede opkaldere. Videnbaser genererer øjeblikkelige svar. Svarassistenter udkaster høflige svar.
- Ticketing-systemer ruter kundesager til de rette medarbejdere.
- Sentimentovervågning prioriterer supportkøer med vrede opkaldere.
- Videnbaser genererer øjeblikkelige svar til brugere.
- Svarassistenter udkaster høflige e-mailsvar til kunder.
Sådan vælger du den rette udbyder af skræddersyet LLM-udvikling til din virksomhed
At evaluere potentielle partnere inden for skræddersyet LLM-udvikling kræver en analyse af deres portefølje af udrullede virksomhedsmodeller, deres tekniske ekspertise inden for finjusteringsrammeværker, protokoller for datasikkerhed og evner til vedligeholdelse efter lancering.
Her dykker vi ned i de kritiske evalueringskriterier, der kræves for at vælge en pålidelig teknologileverandør, som succesfuldt kan omdanne jeres ambitiøse AI-vision til en sikker, produktionsklar virksomhedsrealitet.
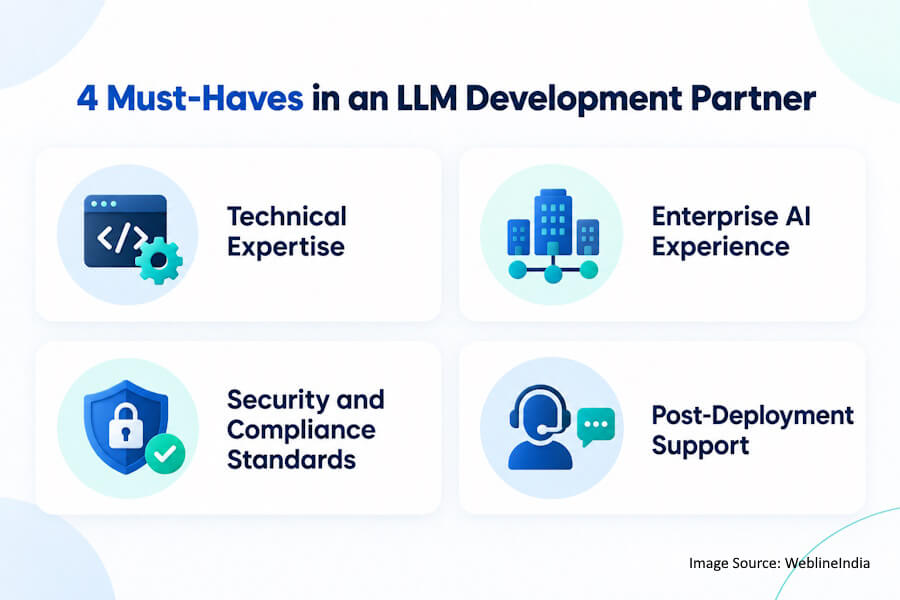
Teknisk ekspertise
Ingeniører vurderer kvalifikationer inden for deep learning. Teams demonstrerer succesfulde modeludrulninger. Certificeringer beviser kompetencer inden for cloud-infrastruktur. Porteføljer fremhæver komplekse virksomhedsløsninger.
Erfaring med virksomheds-AI
Leverandører forstår virksomhedens sikkerhedskrav. Casestudier beviser branchespecifik viden. Kundereferencer bekræfter tidligere resultater. Skaleringsevner matcher forretningens behov.
- Leverandører forstår strenge krav til virksomhedens sikkerhedscompliance.
- Casestudier beviser dyb, branchespecifik operationel viden.
Sikkerheds- og compliance-standarder
Partnere håndhæver strenge regler for databeskyttelse. Certificeringer verificerer infrastrukturens sikkerhed. Juridiske aftaler beskytter immaterielle rettigheder. Revisionsspor sikrer overholdelse af lovgivningen.
- Udviklingspartnere håndhæver strenge interne regler for databeskyttelse.
- Sikkerhedscertificeringer verificerer robust beskyttelse af cloud-infrastrukturen.
- Juridiske kontrakter beskytter proprietære virksomhedsspecifikke immaterielle rettigheder.
- Revisionsspor sikrer fuld overholdelse af branchens lovgivning.
Support efter udrulning
Vedligeholdelseskontrakter sikrer systemets oppetid. Overvågningstjenester følger ydeevnemålinger. Regelmæssige opdateringer holder modellerne up to date. Dedikerede supportteams løser fejl.
- Vedligeholdelsesaftaler garanterer høj oppetid for applikationssystemet.
- Overvågningstjenester følger nøjagtighedsmålinger for ydeevne i realtid.
Fremtidige tendenser inden for skræddersyet LLM-udvikling og virksomheds-AI
Landskabet for virksomheds-AI bevæger sig hurtigt i retning af yderst effektiv edge computing, multimodale funktioner og autonome agentiske arbejdsgange, der udfører komplekse forretningsprocesser med flere trin uden menneskelig indgriben.
Nu afdækker vi de kommende teknologiske gennembrud og strategiske innovationer, der er klar til at omdefinere, hvordan jeres virksomhed udnytter skræddersyede large language models i de kommende år.
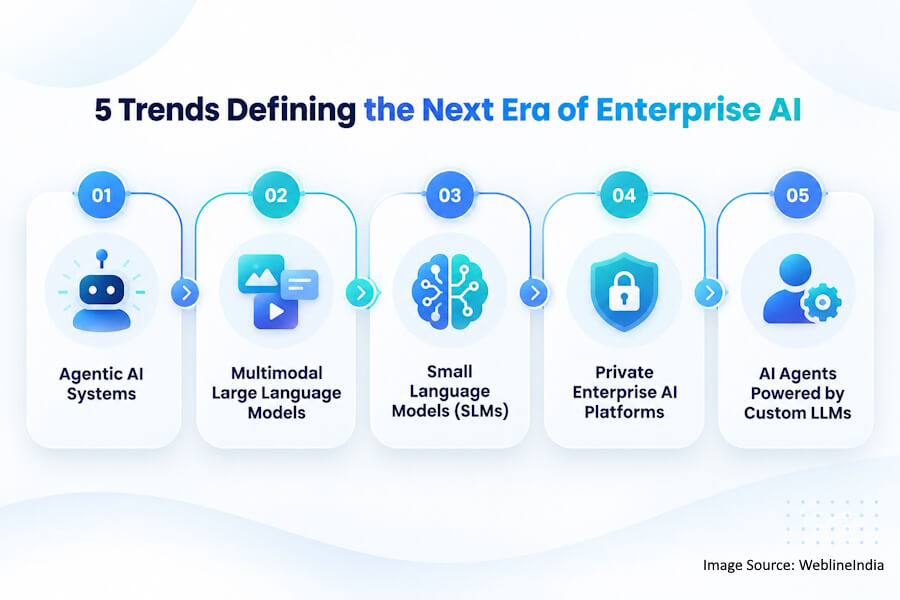
Agentiske AI-systemer
Autonome agenter udfører flertrinnede arbejdsgange. Systemer samarbejder om at løse problemer. Beslutningsmotorer håndterer komplekse opgaver. Produktiviteten stiger på tværs af afdelinger.
Multimodale large language models
Modeller behandler tekst, lyd og video. Integrerede sensorer analyserer fysiske omgivelser. Rige input forbedrer den kontekstuelle forståelse. Anvendelser spænder over flere sansetyper.
- Modeller behandler tekst-, lyd- og videostreams samtidigt.
- Integrerede sensorer analyserer fysiske arbejdsmiljøer på fabrikker.
- Rige input-strømme forbedrer den dybe kontekstuelle forståelse.
- Anvendelser spænder problemfrit over flere typer sansedata.
Small Language Models (SLM’er)
Kompakte modeller kører på edge-enheder. Lokal hardware behandler forespørgsler øjeblikkeligt. Ressourcebehovet falder markant. Privatlivet forbedres gennem lokal udførelse.
- Kompakte modeller udføres lokalt på edge-enheder.
- Lokal hardware behandler brugerens forespørgsler øjeblikkeligt.
Private virksomheds-AI-platforme
Sikre platforme centraliserer AI-værktøjer. Interne markedspladser deler trænede modeller. Governance-dashboards overvåger systemets brug. Virksomheder styrer selv deres AI-fremtid.
- Sikre platforme centraliserer virksomhedens AI-værktøjer.
- Interne markedspladser deler skræddersyet trænede modelvægte.
- Governance-dashboards overvåger brugen af systemet på tværs af hele virksomheden.
- Virksomheder styrer fuldstændigt deres egen AI-infrastruktur.
AI-agenter drevet af skræddersyede LLM’er
Udvikling af virksomheds-AI-agenter kan kombinere specialiserede agenter med skræddersyede LLM’er til at udføre forretningsopgaver og koordinere softwarearbejdsgange. Smarte assistenter håndterer daglige kalendere. Effektivitetsgevinster transformerer virksomhedens arbejdsgange.
- Specialiserede agenter udfører automatisk komplekse forretningsopgaver.
- Automatiserede værktøjer koordinerer deploymentpipelines i softwareudviklingen.
Afsluttende tanker om at bygge en skræddersyet LLM til langsigtet forretningssucces
Udbredelsen af kunstig intelligens afgør fremtidens markedsledere. Generiske offentlige værktøjer lever ikke op til virksomhedernes krav. Organisationer bygger skræddersyede modeller for at sikre deres data. Proprietære arbejdsgange kræver specialiseret intelligens. Langsigtet succes kræver en robust AI-infrastruktur. Virksomheder samarbejder med erfarne leverandører for at accelerere eksekveringen.
WeblineIndia leverer fremragende skræddersyede LLM-udviklingstjenester. Udviklingsteams bygger sikre virksomheds-LLM’er. Specialister finjusterer modeller for maksimal nøjagtighed. WeblineIndia transformerer forretningsdriften gennem skræddersyede AI-løsninger. Organisationer opnår vedvarende konkurrencefordele allerede i dag. Kontakt WeblineIndia for at komme i gang med skræddersyet integration af kunstig intelligens.
Sociale hashtags
#SkræddersyetLLM #StoreSprogmodeller #VirksomhedsAI #GenerativAI #KunstigIntelligens #LLM #AIudvikling #AIingeniørarbejde #AgentbaseretAI #AIAgenter #RetrievalAugmentedGeneration #RAG #Maskinlæring #AIinfrastruktur #DigitalTransformation #Virksomhedsteknologi #MLOps #AIinnovation #PrivatAI #Forretningsautomatisering
Byg en sikker, skalerbar skræddersyet LLM tilpasset jeres virksomhedsdata og arbejdsgange med et erfarent AI-udviklingsteam.
Ofte stillede spørgsmål
Hvordan bygger jeg en brugerdefineret LLM til min virksomhed?
Virksomheder indsamler proprietære data, vælger kraftfulde open source-arkitekturer, finjusterer modelvægte på sikre servere og implementerer skalerbar infrastruktur for at automatisere interne arbejdsgange og beskytte følsomme intellektuelle ejendomsaktiver.
Skal jeg bygge eller finjustere en eksisterende LLM?
Finjustering af eksisterende fundamentsmodeller sparer penge og tid, samtidig med at præ-trænet grammatik tilpasses specifikke domæner. Scratch-træning er kun nødvendig for helt unikke sproglige eller sikkerhedsmæssige krav.
Hvilke data kræves for at træne en brugerdefineret sprogmodel?
Ingeniører indsamler rene interne dokumenter, tekniske manualer, historiske transkripter og strukturerede databaseposter. Teams skal rengøre personlige identifikatorer og formatere tekst omhyggeligt, før de tilfører træningspipelines.
Hvor meget koster udvikling af brugerdefineret LLM?
Udgifterne varierer afhængigt af parameterstørrelser, hardwareleje og dataforberedelsesarbejde. Cloud GPU-klynger kræver betydelig kapital, mens finjustering af eksisterende adaptere sænker de samlede implementeringsbudgetter.
Hvilken open source LLM er bedst for virksomheder?
Meta Llama og Mistral AI tilbyder enestående ydeevne og åbne vægte til sikre lokale implementeringer. Organisationer vælger specifikke varianter baseret på parametergrænser og tilgængelige computerressourcer.
Hvor lang tid tager det at bygge en brugerdefineret LLM?
Tidslinjerne varierer fra flere uger til flere måneder afhængigt af datasættets kompleksitet. Fasede udrulninger og forudtrænede fundamentsmodeller fremskynder de indledende implementeringsplaner for virksomhedsteams.
Kan virksomheder oprette private AI-modeller?
Virksomheder implementerer modeller på lokal serverhardware eller sikre private cloud-undernet. Dette garanterer fuldstændig dataisolering og forhindrer eksterne API-udbydere i at se fortrolige virksomhedsregistre.
Hvilken infrastruktur er nødvendig til LLM-udvikling?
Deep learning kræver højtydende GPU-klynger, robust netværkshardware og hurtige vektordatabaser. DevOps-ingeniører konfigurerer skalerbare Kubernetes-noder til at håndtere store inferenstrafikkrav.
Hvordan implementerer virksomheder brugerdefinerede LLM'er?
DevOps-teams klargør cloud-inferens-instanser eller lokale servernoder. API-gateways forbinder interne forretningsapplikationer, mens load balancers distribuerer indgående anmodningstrafik gnidningsløst på tværs af servere.
Hvad er fordelene ved private LLM'er?
Private modeller sikrer streng databeskyttelse, eliminerer abonnementsgebyrer pr. token og leverer præcise branchespecifikke svar. Organisationer bevarer absolut kontrol over modelvægte og systemsikkerhedspolitikker.
Hvad er RAG, og hvordan kan det sammenlignes med finjustering?
Retrieval-Augmented Generation henter dynamiske eksterne dokumenter uden at ændre kernemodelvægte. Finjustering ændrer neurale netværksparametre direkte for specialiseret ordforråd og adfærdstilpasning på tværs af virksomhedens arbejdsgange.
Hvor sikre er virksomhedens LLM'er?
Virksomhedsplatforme håndhæver strenge rollebaserede adgangskontroller, datakryptering i hvile og politikker med nul opbevaring. Sikkerhedsrevisioner og lokale firewalls beskytter fortrolige oplysninger mod ondsindede cybertrusler.
Globalt anerkendt for uovertruffen kvalitet og pålidelighed


Udtalelser: Hør det direkte fra vores globale kunder
Vores udviklingsprocesser leverer dynamiske løsninger til at håndtere forretningsudfordringer, optimere omkostninger og drive digital transformation. Ekspertunderstøttede løsninger forbedrer kundeloyaliteten og den digitale tilstedeværelse, og dokumenterede succeshistorier fremhæver virkelige problemløsninger gennem innovative applikationer. Vores anerkendte kunder verden over har allerede oplevet det.
Priser og anerkendelser
Mens glade kunder er vores største motivation, har branchens anerkendelse betydelig værdi. WeblineIndia har konsekvent føret inden for teknologi, med priser og anerkendelser, der bekræfter vores ekspertise.
OA500 Globale outsourcingvirksomheder 2025, af Outsource Accelerator
Top softwareudviklingsvirksomhed, af GoodFirms
Bedste fintech-produktløsningsvirksomhed – 2022, af GESIA
Tildelt som – Årets bedste appudviklingsvirksomhed i Indien 2020, af SoftwareSuggest