Hoe u een aangepast LLM voor uw bedrijf bouwt
Leer hoe u een op maat gemaakt LLM voor uw bedrijf ontwikkelt via een stapsgewijze aanpak die onder meer datavoorbereiding, de keuze van een basismodel, fine-tuning, RAG, infrastructuur, implementatie, beveiliging, kosten en zakelijke toepassingen omvat.


 ChatGPT
 Perplexity
Een eigen LLM voor je bedrijf bouwen omvat het identificeren van specifieke toepassingen, het voorbereiden van relevante data, het kiezen van de juiste modelarchitectuur en het inrichten van effectieve trainings- en testprocessen. Een op maat gemaakte LLM kan automatisering, efficiëntie, klantervaringen en besluitvorming binnen alle bedrijfsprocessen verbeteren.
Wat is een Custom Large Language Model (LLM) en waarom heeft je bedrijf er een nodig?
Standaard fundamentele AI-modellen beantwoorden brede, publieke vragen. Deze generieke modellen missen specifieke operationele context. Organisaties kampen met nauwkeurigheidslacunes. Generieke systemen hallucineren bedrijfsfeiten. Bedrijven hebben gespecialiseerde domeinkennis nodig. Custom LLM-ontwikkeling overbrugt precies deze kloof. Bedrijfseigen data blijft intern. Beveiligingsprotocollen voorkomen datalekken naar buiten. Organisaties bouwen een enterprise LLM om gevoelige documenten te verwerken.
Custom AI-ontwikkelingsdiensten richten zich op specifieke workflows. Medewerkers uploaden interne technische handleidingen. Het systeem leert de bedrijfseigen terminologie direct. Large Language Model-ontwikkeling omvat uitgebreide parameterafstemming. Bedrijven stappen over van openbare tools naar een beveiligde infrastructuur. Private LLM-implementaties garanderen data-isolatie. Financiële instellingen verwerken vertrouwelijke dossiers veilig. Zorgverleners beschermen patiëntgegevens zorgvuldig.
Standaardmodellen falen bij technische vragen. Custom GPT-ontwikkeling richt zich op niche-sectoren. Organisaties gebruiken AI-modelontwikkeling om complexe schrijftaken te automatiseren. Enterprise AI-modellen begrijpen interne kengetallen. Bedrijven kiezen voor open-source LLM-oplossingen om eigenaarschap over hun code te behouden. Deze aanpak elimineert abonnementskosten van derden. Bedrijfseigen gewichten blijven op lokale servers. Hoge operationele controle versterkt interne engineeringteams. AI-infrastructuur vraagt om krachtige rekenclusters. Engineers configureren gedistribueerde verwerkingsnodes.
Belangrijkste voordelen van het bouwen van een eigen LLM voor zakelijke enterprise-toepassingen
Het bouwen van een eigen Large Language Model (LLM) stelt organisaties in staat de beveiliging van bedrijfseigen data te waarborgen, hallucinaties sterk te verminderen via domeinspecifieke fine-tuning en complexe interne workflows naadloos te automatiseren.
Laten we bekijken waarom het afstemmen van een AI-model op de data van jouw organisatie ongeëvenaarde operationele efficiëntie en een echt concurrentievoordeel oplevert in moderne enterprise-omgevingen.
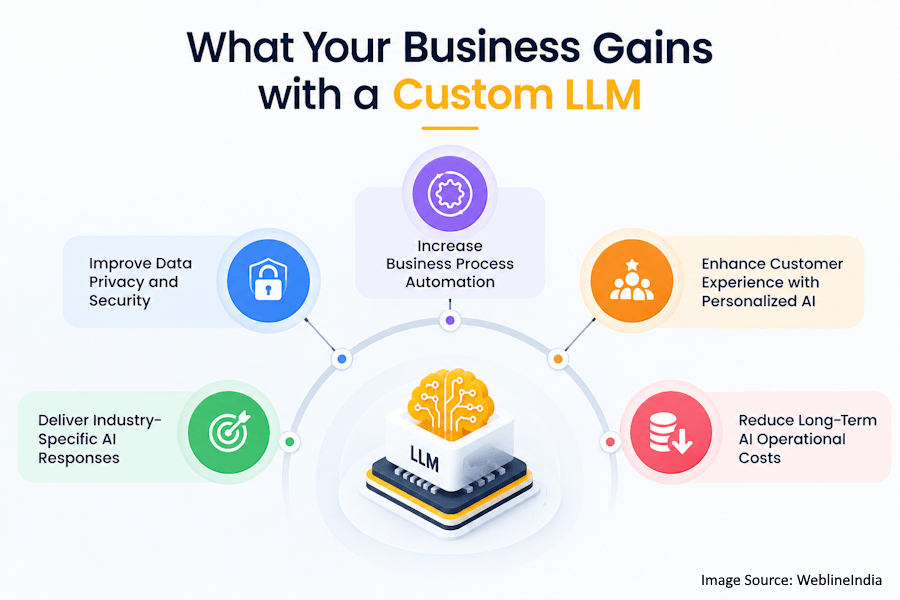
Betere gegevensprivacy en beveiliging
Openbare AI-platforms slaan gebruikersinvoer op. Externe servers nemen bedrijfsgeheimen op. Bedrijven lopen het risico op zware boetes van toezichthouders. Custom AI-modelontwikkelingsdiensten elimineren de risico’s van de publieke cloud. Data blijft binnen lokale datacenters. Beveiligingsteams versleutelen opgeslagen informatie. Medewerkers delen vertrouwelijke rapporten veilig. Compliance-officers handhaven strikte toegangscontroles. Private LLM-ontwikkeling beschermt intellectueel eigendom.
- Bedrijfsservers slaan promptlogs lokaal op.
- Externe API-providers krijgen nooit interne data te zien.
- Security engineers configureren strikte firewallregels.
Branchespecifieke AI-antwoorden
Generieke modellen begrijpen vakjargon verkeerd. Gespecialiseerde domeinen vereisen nauwkeurige terminologie. Custom LLM-ontwikkelingsdiensten trainen modellen op nichedatasets. Engineers passen fine-tuning van een LLM toe voor zakelijke nauwkeurigheid. Advocatenkantoren uploaden archieven met jurisprudentie. Medisch onderzoekers verwerken notities van klinische studies. Het systeem levert de juiste terminologie.
- Juridische databases voeden gespecialiseerde trainingspipelines met historische documenten.
- Medische tijdschriften verbeteren de nauwkeurigheid van klinische vragen voor ziekenhuisdiagnostiek.
- Engineeringteams integreren blauwdrukken om technische redeneersystemen te sturen.
Meer automatisering van bedrijfsprocessen
Handmatig documenten sorteren kost veel manuren. LLM’s kunnen ook diensten voor bedrijfsprocesautomatisering aanvullen door workflows te ondersteunen zoals documentverwerking, ticketroutering en informatie-extractie. Systemen routeren inkomende supporttickets direct. Enterprise AI-ontwikkelingsdiensten kunnen architecturen ondersteunen die zijn ontworpen om gevoelige bedrijfsdata binnen gecontroleerde omgevingen te houden. Algoritmen halen data uit ongestructureerde facturen. Enterprise AI-modellen voeren meerstaps-bedrijfslogica uit.
- Geautomatiseerde factuurverwerking bespaart boekhoudafdelingen elke maand honderden handmatige uren.
- Supportchatbots lossen technische tickets direct op door interne troubleshooting-wiki’s te raadplegen.
- Logistieke systemen verwerken vrachtmanifesten automatisch om voorraaddatabases bij te werken.
- Fouten bij data-invoer nemen aanzienlijk af binnen alle afdelingen van het bedrijf.
Een betere klantervaring met gepersonaliseerde AI
Generieke antwoorden frustreren kopers. Kopers verwachten contextuele hulp. Ontwikkeling van zakelijke AI-modellen integreert databases met klanthistorie. Het platform herinnert zich eerdere aankopen. Supportmedewerkers lossen problemen sneller op. Merkloyaliteit groeit gestaag.
- Aanbevelingssystemen analyseren eerder koopgedrag om relevante producten voor te stellen.
- Chatbots raadplegen het abonnementsniveau van individuele klanten om accuraat accountsupport te bieden.
Lagere langetermijnkosten voor AI-operaties
Externe API-tokens lopen op tot hoge kosten. Hoog enterprise-verkeer verhoogt de maandelijkse facturen. Bedrijven trainen hun eigen taalmodel om kosten per token te omzeilen. Vaste hardwarekosten vervangen variabele API-facturering. Organisaties beheren hun budgetten voorspelbaar.
- Vaste infrastructuurkosten vervangen oplopende API-rekeningen tijdens piekperiodes.
- Grote hoeveelheden queries draaien na verloop van tijd goedkoper op lokale enterprise-GPU’s.
- Interne teams optimaliseren de inferentiesnelheid zelfstandig, zonder beperkingen van externe platforms.
- Resource-toewijzing sluit efficiënt aan op de exacte pieken in de bedrijfsvraag.
Verander je bedrijfsdata in een veilige, domeinspecifieke AI-oplossing, afgestemd op jouw workflows, gebruikers en enterprise-eisen.
Custom LLM vs. voorgetrainde LLM: welk AI-model past bij jouw bedrijf?
Voorgetrainde modellen bieden direct en kostenefficiënt algemene mogelijkheden, terwijl custom modellen ongeëvenaarde beveiliging en precisie leveren, exact afgestemd op het jargon van jouw branche.
Laten we een uitgebreide vergelijking maken om te bepalen welk strategisch pad het beste past bij jouw bedrijfsdoelen op de lange termijn.
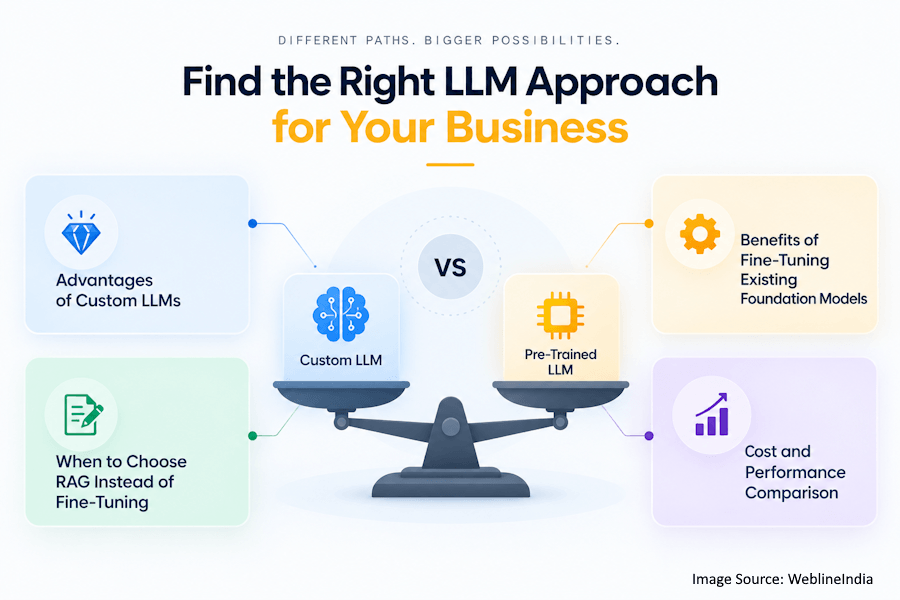
Voordelen van custom LLM’s
Organisaties bezitten hun eigen modelgewichten. Engineers passen neurale netwerklagen direct aan. Custom LLM-ontwikkeling biedt ongeëvenaarde architecturale controle. Bedrijfseigen algoritmen beschermen concurrentievoordelen. Beveiligingsbeleid dwingt zero-data-retention-regels af. Prestaties sluiten aan op de exacte enterprise-workloads.
- Volledig eigenaarschap voorkomt vendor lock-in en willekeurige prijswijzigingen.
- Fine-tuningparameters passen zich met hoge precisie aan aan industriële nichedomeinen.
- De inferentiesnelheid wordt geoptimaliseerd voor specifieke hardwareconfiguraties in lokale datacenters.
Voordelen van het fine-tunen van bestaande foundation-modellen
Van nul beginnen kost miljoenen. AI-modelfine-tuningdiensten kunnen de noodzaak van trainen vanaf nul verminderen door bestaande foundation-modellen aan te passen aan domeinspecifieke eisen. Bestaande modellen bieden een sterke taalbasis. Domeindatasets passen de voorgetrainde gewichten aan. Trainingscycli zijn binnen enkele dagen klaar. Engineers maken gebruik van open-source LLM-ontwikkelframeworks.
- Voorgetrainde gewichten bieden snel een basisniveau zonder uitgebreide training vanaf nul.
- De rekenkosten blijven lager dan bij volledige trainingsruns van meerdere miljoenen dollars.
- Gespecialiseerde datasets richten algemene redeneervaardigheden op specifieke bedrijfstaken.
- Ontwikkeltijden krimpen van jaren naar weken.
Wanneer kies je voor RAG in plaats van fine-tuning?
Training verandert de kerngewichten van het model. Retrieval-Augmented Generation laat de gewichten ongemoeid. Bedrijven werken externe kennisbanken dagelijks bij. RAG-systemen halen documenten dynamisch op. Engineers kiezen voor RAG bij wiki’s die vaak veranderen. De ontwikkelkosten blijven minimaal.
- Dynamische documentupdates vereisen geen hertrainingscycli of aanpassingen van gewichten.
- Externe vectordatabases slaan live bedrijfswiki’s op voor directe retrieval.
Vergelijking van kosten en prestaties
Custom architecturen vragen om enorme rekenclusters. Foundation fine-tuning vereist een bescheiden GPU-huur. RAG-architecturen leunen op snelle vectorzoekopdrachten. Financiële planners berekenen het exacte rendement op investering. Prestatiebenchmarks bepalen de keuze van de architectuur.
- Custom pre-training brengt rekenkosten van meerdere miljoenen dollars met zich mee voor de ruwe trainingsruns.
- Fine-tuning vraagt om bescheiden cloud-GPU-budgetten voor updates van adaptergewichten.
- RAG-implementaties optimaliseren de opslagkosten van databases en behouden tegelijk een hoge feitelijke nauwkeurigheid.
- Latentiemetingen sturen de uiteindelijke keuzes voor productie-implementatie binnen verschillende bedrijfsonderdelen.
Stapsgewijs proces om een eigen LLM voor je bedrijf te bouwen
Het bouwen van een eigen LLM omvat het definiëren van specifieke zakelijke toepassingen, het verzamelen en opschonen van bedrijfseigen data, het kiezen van het juiste basismodel, fine-tuning via gespecialiseerde training en het grondig evalueren van de prestaties vóór een veilige enterprise-implementatie.
Laten we elke fase in detail bekijken om te zien hoe deze gestructureerde roadmap zorgt dat jouw AI-implementatie soepel slaagt.
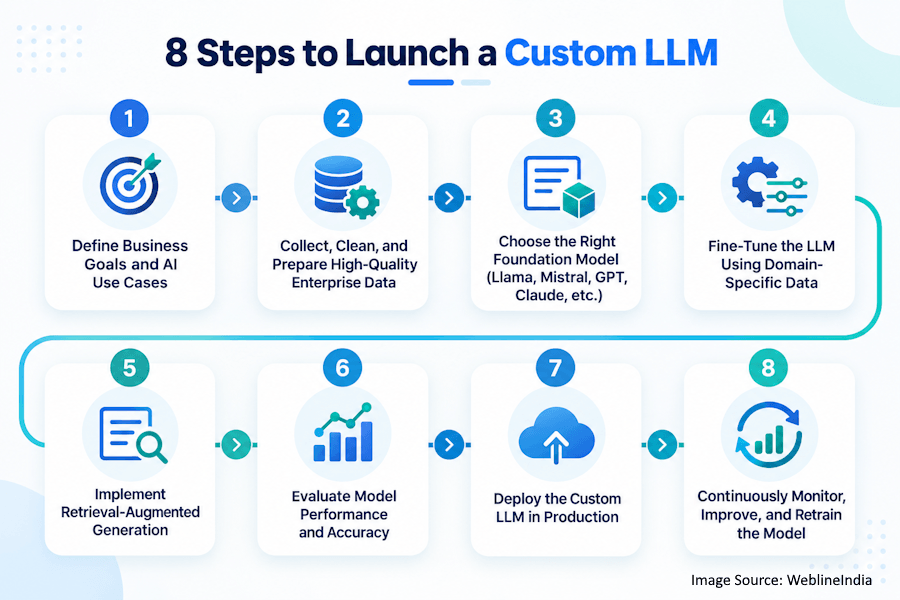
Bepaal zakelijke doelen en AI-toepassingen
Directies schetsen de exacte operationele knelpunten. Engineers isoleren repetitieve handmatige taken. Projectmanagers definiëren succesmetingen. Duidelijke doelen voorkomen verspilde rekenkracht. Stakeholders bekijken de afstemmingsdocumenten grondig.
Verzamel, reinig en bereid hoogwaardige enterprise-data voor
Ruwe bedrijfsdata bevat opmaakfouten. Engineers verwijderen dubbele records rigoureus. Tekstparsers verwijderen gevoelige persoonsgegevens. Schone datasets voeden de trainingspipelines. Hoge datakwaliteit zorgt voor betrouwbare output.
- Data engineers halen ruwe tekst uit oude enterprise-databases.
- Geautomatiseerde scripts verwijderen beschadigde tekencoderingen uit documenten.
- PII-scrubbing beschermt de privacy van medewerkers voordat de training begint.
- Geformatteerde JSON-bestanden ordenen de trainingsvoorbeelden goed voor de modellen.
Kies het juiste foundation-model (Llama, Mistral, GPT, Claude, enz.)
De modelkeuze bepaalt het succes verderop in het traject. Engineers testen meerdere basisarchitecturen. Open gewichten bieden vrijheid bij lokale implementatie. Propriëtaire modellen bieden een sterke redeneerbasis. Licentieovereenkomsten bepalen de rechten voor commercieel gebruik.
- Benchmarktests evalueren de redeneersnelheid van verschillende kandidaatmodellen.
- Licentievoorwaarden staan commerciële enterprise-implementatie toe zonder juridische risico’s.
Fine-tune de LLM met domeinspecifieke data
Gespecialiseerde adapters passen het modelgedrag aan, terwijl machine learning-ontwikkelingsdiensten de bredere workflow van training, validatie en model-engineering kunnen ondersteunen. Verliescurves dalen tijdens de epoch-iteraties. Engineers valideren de output aan de hand van testsets. De definitieve gewichten worden opgeslagen in beveiligde repositories.
- LoRA-adapters beperken het aantal actieve trainingsparameters tijdens fine-tuning.
- GPU-clusters verwerken terabytes aan domeintekst efficiënt.
- Verliesmetingen volgen de convergentiesnelheid tijdens de trainingsepochs van het model.
Implementeer Retrieval-Augmented Generation
Tekstsplitters knippen lange enterprise-rapporten in chunks. Embeddingmodellen zetten tekst om in vectoren. Vectordatabases indexeren semantische informatie. Zoekalgoritmen halen relevante documentcontext op. Prompts combineren opgehaalde feiten met de vragen.
- Tekstchunking verdeelt grote handleidingen efficiënt in kleinere segmenten.
- Embeddingmodellen vertalen woorden naar numerieke vectoren voor indexering.
- Vectordatabases slaan multidimensionale semantische indexen op voor snelle queries.
- Contextinjectie verankert de modelantwoorden in geverifieerde feiten.
Evalueer modelprestaties en nauwkeurigheid
Geautomatiseerde testscripts meten de kwaliteit van de antwoorden. Menselijke reviewers beoordelen subjectieve output. Benchmarksuites testen de grenzen van het redeneren. Beveiligingsfilters testen op kwetsbaarheden voor prompt injection. Slechte scores leiden direct tot hertraining.
- Geautomatiseerde evaluatiescripts draaien benchmarktestsuites op de output.
- Menselijke experts beoordelen de domeinnauwkeurigheid handmatig voor kwalitatieve review.
Zet de custom LLM in productie
DevOps-diensten kunnen het inrichten van cloud-inferentieservers, deploymentpipelines en schaalbare productieomgevingen voor custom LLM’s ondersteunen. Load balancers verdelen het inkomende gebruikersverkeer. API-endpoints koppelen interne applicaties. Monitoringtools volgen de systeemgezondheid. Productieomgevingen zorgen voor hoge beschikbaarheid.
- Kubernetes-clusters schalen inferentienodes automatisch op tijdens verkeerspieken.
- API-gateways beheren authenticatietokens van enterprise-gebruikers veilig.
- Load balancers verdelen zwaar aanvraagverkeer soepel over de servers.
- Fallbacks voorkomen onverwachte systeemuitval tijdens onderhoud.
Monitor, verbeter en hertrain het model continu
Gebruikersfeedback wijst op operationele fouten. Logpipelines leggen onjuiste antwoorden vast. Data scientists stellen nieuwe trainingsvoorbeelden samen. Geplande hertraining werkt de modelgewichten bij. Enterprise-systemen evolueren mee met de bedrijfsbehoeften.
- Feedbackknoppen leggen direct na het genereren beoordelingen van gebruikers vast.
- Logsystemen markeren terugkerende hallucinaties voor review.
- Datapipelines nemen wekelijks bijgewerkt bedrijfsbeleid op.
- Geplande hertrainingscycli houden de intelligentie actueel met de markt.
Klaar om je LLM-roadmap om te zetten in een productieklare oplossing? Onze AI-engineers helpen je bij het bouwen, fine-tunen, implementeren en opschalen.
Het beste foundation-model kiezen voor custom LLM-ontwikkeling
Het kiezen van een optimaal foundation-model vraagt om een afweging tussen cruciale parameters, zoals rekenoverhead, licentiebeperkingen van de architectuur, basisprestaties in het domein en eisen aan de inferentielatentie, afgezet tegen de specifieke technische randvoorwaarden van jouw organisatie.
Laten we bekijken hoe je deze architecturale variabelen systematisch evalueert om het model te vinden dat zowel capaciteit als kostenefficiëntie maximaliseert.
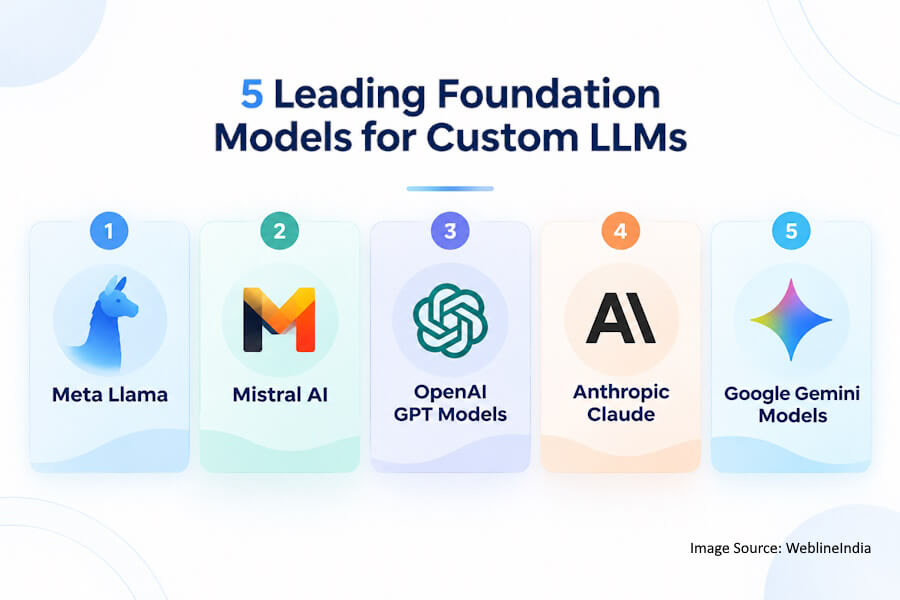
Meta Llama
Open gewichten trekken enterprise-ontwikkelaars aan. Lokale implementatie garandeert databeveiliging. Het fine-tunen van Llama-modellen vereist standaardhardware. Communityforums bieden uitgebreide troubleshootinggidsen.
- Open-sourcegewichten maken lokale serverimplementatie achter firewalls mogelijk.
- Parametergroottes schalen van kleine tot enorme enterprise-configuraties.
Mistral AI
Europese engineering zorgt voor hoge efficiëntie. Compacte modellen leveren snelle inferentiesnelheden. Enterprise-klanten nemen licenties op propriëtaire gewichtsvarianten. Architectuurontwerpen optimaliseren het geheugengebruik.
- Een efficiënte architectuur verlaagt de operationele rekenoverhead aanzienlijk.
- Compacte modelgroottes versnellen de responstijden voor gebruikers.
- Sterke redeneerbenchmarks evenaren grotere concurrenten in de sector.
- Flexibele licenties passen bij uiteenlopende commerciële bedrijfsstructuren.
OpenAI GPT-modellen
Propriëtaire API’s bieden een krachtige redeneerbasis. Ontwikkelaars hoeven geen infrastructuurclusters te beheren. Regelmatige updates brengen geavanceerde functies. Privacybeleid beschermt de data van enterprise-klanten.
- Beheerde API’s nemen infrastructuuronderhoud uit handen van interne teams.
- Geavanceerd redeneren lost complexe logische problemen eenvoudig op zonder tuning.
Anthropic Claude
Lange contextvensters verwerken complete boeken. Veiligheidsmaatregelen beperken toxische output. Enterprise-klanten integreren beveiligde API-endpoints. Financieel analisten verwerken grote spreadsheets rechtstreeks.
- Enorme contextvensters nemen complete codebases en uitgebreide rapporten op.
- Ingebouwde constitutionele veiligheid vermindert schadelijke of toxische output.
- Documentparsing haalt gestructureerde data uit dichtbeschreven financiële pagina’s.
Google Gemini-modellen
Multimodale mogelijkheden verwerken tekst en video. Cloudinfrastructuur integreert native AI-tools. Enterprise-zoekfuncties koppelen interne schijven. Schaalbare architecturen verwerken zware workloads.
- Native multimodaliteit verwerkt afbeeldingen en videostreams rechtstreeks.
- Google Cloud-integratie vereenvoudigt enterprise-deploymentpipelines.
Infrastructuur en technologiestack voor custom LLM-ontwikkeling
Het ontwikkelen van een robuuste custom LLM vraagt om krachtige rekenclusters met gespecialiseerde GPU’s, schaalbare datapipelines, enterprise-orkestratieframeworks en beveiligde vectordatabases voor retrieval-augmented generation.
Laten we de essentiële technische architectuur bekijken die nodig is om jouw enterprise AI-infrastructuur effectief aan te drijven.
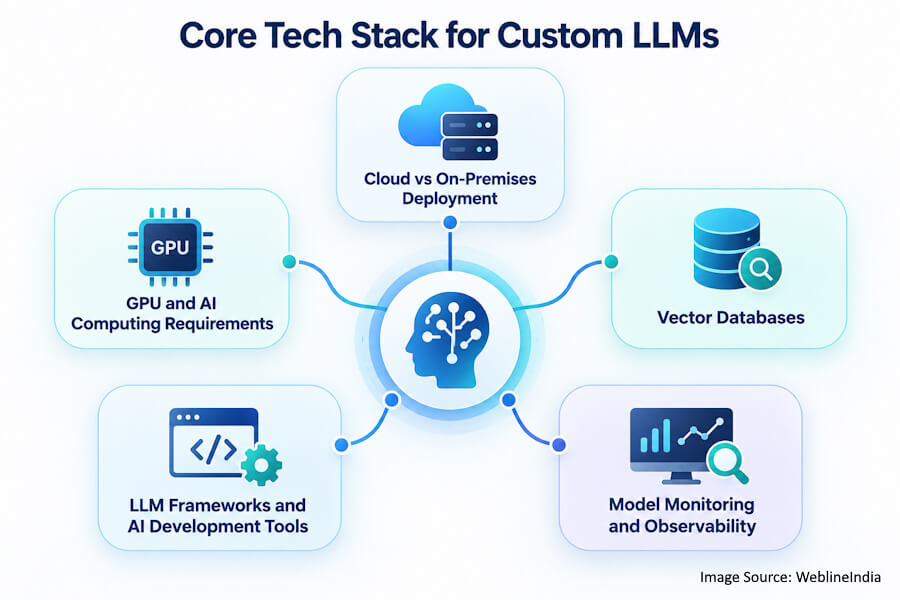
Cloud vs. on-premises implementatie
Cloudproviders bieden elastische GPU-schaling. On-premises servers beschermen streng geheime informatie. Financiële regelgeving bepaalt de regels voor hardwareplaatsing. Hybride architecturen brengen kosten en beveiliging in balans.
GPU- en AI-rekenvereisten
Deep learning vraagt om gespecialiseerde acceleratorchips. Een hoge VRAM-capaciteit laadt grote modellen. Interconnectsnelheden versnellen gedistribueerde trainingstaken. Stroomverbruik bepaalt de budgetten van datacenters.
- NVIDIA H100-clusters verkorten de trainingstijden drastisch.
- Hoge VRAM-capaciteiten laden enorme parametergewichten veilig.
- Snelle interconnects koppelen meerdere trainingsnodes zonder latentie.
Vectordatabases
Embeddings vereisen gespecialiseerde opslagoplossingen. Similariteitszoekopdrachten halen passende documentchunks op. Schaalbare architecturen verwerken miljarden vectoren. De indexeringssnelheid beïnvloedt de querylatentie.
- Pinecone beheert cloud-native vectorzoekindexen efficiënt.
- Milvus schaalt naadloos over gedistribueerde lokale serverclusters.
- Qdrant verwerkt razendsnel metadatafiltering tijdens het zoeken.
LLM-frameworks en AI-ontwikkeltools
Python-bibliotheken vereenvoudigen het bouwen van pipelines. Orkestratietools koppelen complexe agentstappen aan elkaar. Quantisatiepakketten verkleinen de geheugenvoetafdruk van modellen. Containerisatietools standaardiseren deploymentomgevingen.
- LangChain orkestreert complexe meerstaps-workflows van AI-agents.
- LlamaIndex koppelt externe documenten aan modellen voor RAG.
Modelmonitoring en observability
Metrics volgen het tokengebruik. Foutlogging legt de faalpunten van prompts bloot. Driftdetectie signaleert dalende nauwkeurigheidstrends. Beveiligingsscanners blokkeren kwaadaardige invoer.
- Grafana-dashboards tonen realtime metingen van het systeemresourcegebruik.
- Logtools leggen foutsporen van gebruikersprompts vast voor analyse.
- Driftmonitors waarschuwen engineers bij prestatiedalingen.
- Beveiligingsfilters blokkeren ongeautoriseerde prompt injection-pogingen.
Veelvoorkomende uitdagingen bij custom LLM-ontwikkeling en hoe je ze overwint
Custom LLM-ontwikkeling brengt vaak obstakels met zich mee, zoals stijgende rekenkosten, risico’s voor gegevensprivacy, catastrofaal vergeten tijdens fine-tuning en het beheersen van modeldrift na verloop van tijd.
Laten we de beproefde mitigatiestrategieën bekijken waarmee je deze technische obstakels succesvol omzeilt.
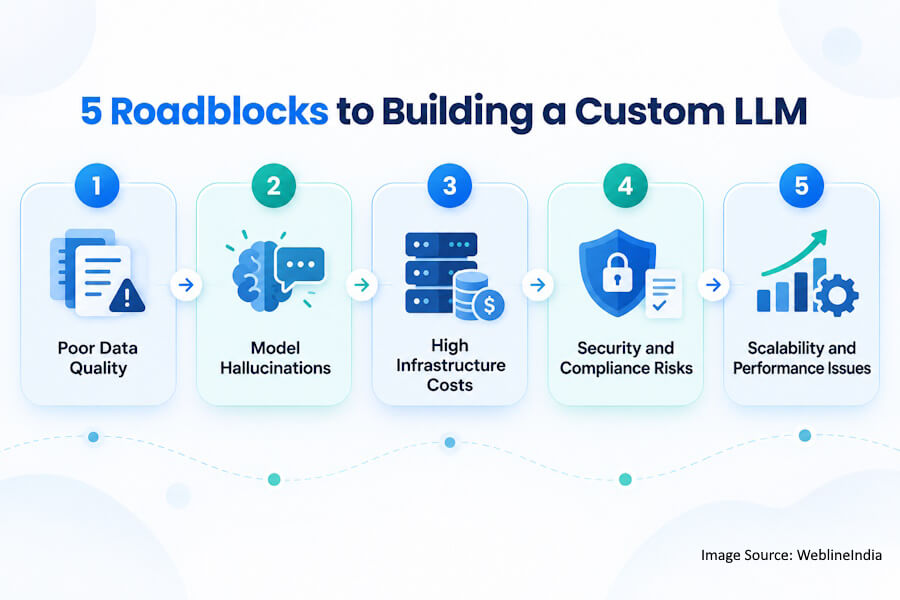
Slechte datakwaliteit
Onvolledige documenten veroorzaken grillig modelgedrag. Datareinigingspipelines verwijderen ruis. Geautomatiseerde validatiescripts controleren tekstformaten. Menselijke auditors verifiëren de integriteit van de dataset.
- Ontbrekende documentsecties creëren hiaten in het logisch redeneren tijdens de training.
- Geautomatiseerde regex-scripts verwijderen beschadigde tekens uit bestanden.
Modelhallucinaties
Modellen verzinnen onjuiste historische feiten. RAG-architecturen verankeren antwoorden in de waarheid. Strikte temperatuurinstellingen verminderen creatieve verzinsels. Evaluatiesuites vangen fouten vroeg af.
- Grounding-prompts beperken antwoorden strikt tot de aangeleverde brondocumenten.
- Lage temperatuurinstellingen verminderen de kans op willekeurige output.
- Verplichte bronvermelding dwingt modellen te verwijzen naar documentbronnen.
Hoge infrastructuurkosten
GPU-huur put bedrijfsbudgetten uit. Modelquantisatie verkleint de geheugenvoetafdruk. Kleinere modellen vervangen enorme foundation-systemen. Efficiënte batching maximaliseert het hardwaregebruik.
- Modelquantisatie halveert de bestandsgrootte zonder kwaliteitsverlies.
- Spot-GPU-instances verlagen de kosten voor cloudrekenkracht aanzienlijk.
- Request batching maximaliseert het gebruik van de actieve hardwarecapaciteit.
Beveiligings- en compliancerisico’s
Datalekken leiden tot boetes van toezichthouders. Versleutelingsprotocollen beveiligen opgeslagen bestanden. Toegangscontrolelijsten beperken gebruikersrechten. Regelmatige audits verifiëren de systeemintegriteit.
- Versleutelingsstandaarden beschermen bestanden tijdens overdracht op het interne netwerk.
- Rolgebaseerde toegang beperkt de zichtbaarheid van gevoelige documenten tussen afdelingen.
- Complianceaudits controleren of de regelgeving van de branche wordt nageleefd.
- Penetratietests brengen verborgen beveiligingskwetsbaarheden in applicaties aan het licht.
Schaalbaarheids- en prestatieproblemen
Veel gebruikersverkeer veroorzaakt serverknelpunten. Load balancers verdelen de inkomende aanvraagbelasting. Cachinglagen slaan veelvoorkomende queryresultaten op. Asynchrone wachtrijen beheren zware workloads.
- Load balancers voorkomen crashes door overbelasting van één server tijdens verkeerspieken.
- Responscaching levert identieke queries direct, zonder inferentie.
Wat kost het om een eigen LLM voor je bedrijf te bouwen?
Het bouwen van een custom enterprise LLM brengt variabele financiële verplichtingen met zich mee, variërend van eenvoudige API-configuraties tot resource-intensieve trainingspipelines. Organisaties moeten rekening houden met GPU-rekenoverhead, datavoorbereidingspipelines, gespecialiseerd engineeringtalent en onderhoudskosten op de lange termijn.
Laten we de daadwerkelijke financiële variabelen en budgetschattingen op een rij zetten, zodat je een accurate investeringsstrategie kunt opstellen voor je komende enterprise AI-project.
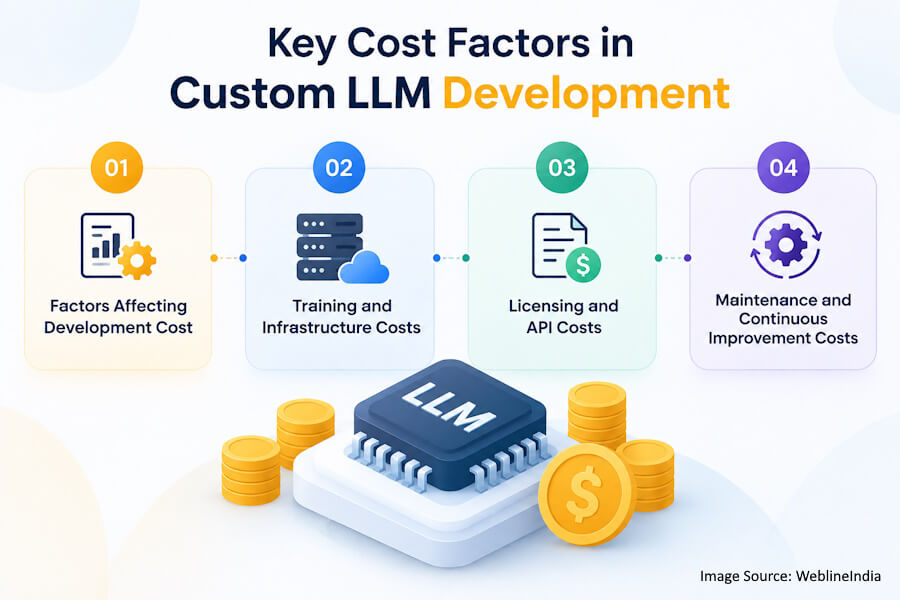
Factoren die de ontwikkelkosten beïnvloeden
De omvang van de dataset bepaalt de arbeidsinzet voor datavoorbereiding, terwijl het aantal modelparameters de hardwarebehoefte bepaalt. AI-adviesdiensten kunnen organisaties helpen de integratiecomplexiteit, infrastructuurvereisten en andere factoren die de projectomvang beïnvloeden te beoordelen.
- Grote datasets vereisen veel handmatige reinigingstijd van engineers.
- Modellen met veel parameters vragen om dure, high-end GPU-hardware.
Trainings- en infrastructuurkosten
Rekenclusters vereisen aanzienlijke financiering. Elektriciteitsrekeningen voegen doorlopende operationele kosten toe. Cloudproviders rekenen uurtarieven voor GPU’s. Hardwareaankopen vragen om kapitaal vooraf.
- Uurhuur van cloud-GPU’s loopt tijdens trainingsruns snel op.
- Stroom- en koelingsoverhead verhogen de faciliteitsbudgetten voor servers.
- Het opzetten van clusters vereist dure hogesnelheidsnetwerkapparatuur.
- Onderhoudscontracten dekken onverwachte defecten aan serveronderdelen.
Licentie- en API-kosten
Propriëtaire foundation-modellen rekenen abonnementskosten. Vergunningen voor commercieel gebruik brengen extra kosten met zich mee. Open-sourcegewichten elimineren terugkerende licentiekosten. Juridische reviews waarborgen compliance.
- Commerciële API-tokens leiden tot maandelijkse kosten op basis van volume.
- Abonnementen op propriëtaire modellen schalen mee met het aantal actieve gebruikers.
- Open-sourcegewichten vermijden de last van terugkerende softwarelicentiekosten.
Kosten voor onderhoud en continue verbetering
Modellen vragen om doorlopende hertrainingscycli. Engineeringteams verhelpen operationele bugs. Beveiligingspatches beschermen de infrastructuurservers. Monitoringtools brengen abonnementskosten met zich mee.
- Hertrainingspipelines nemen regelmatig nieuw bijgewerkte bedrijfsdocumenten op.
- Supportengineers lossen dagelijks onverwachte fouten in productielogs op.
- Beveiligingsteams passen softwarepatches toe op enterprise-servers.
- Observability-tools rekenen kosten op basis van het volume aan logdata.
Ontvang een realistische custom LLM-inschatting op basis van je toepassing, data, modelkeuze, integraties, infrastructuur en implementatie-eisen.
Best practices voor het bouwen van veilige, accurate en schaalbare enterprise-LLM’s
Het implementeren van robuuste enterprise-LLM’s vereist strikte gegevensversleuteling, continue feedbackloops om hallucinaties te minimaliseren en horizontaal schaalbare architecturen om piekbelasting op te vangen.
Laten we de belangrijkste implementatiestrategieën bekijken die ervoor zorgen dat jouw AI-ecosysteem beschermd, zeer nauwkeurig en eindeloos aanpasbaar blijft aan toekomstige groei van de organisatie.
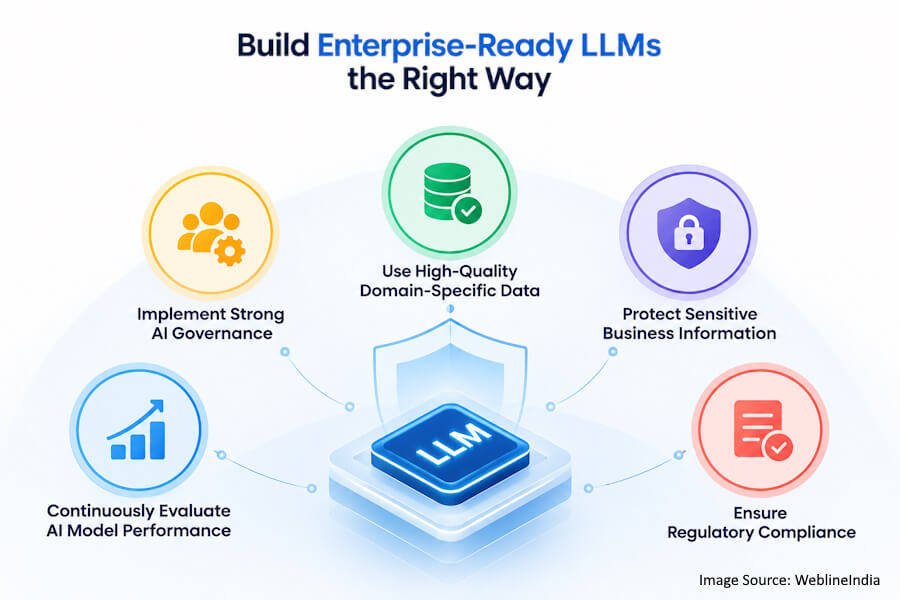
Implementeer sterke AI-governance
Commissies houden toezicht op AI-projecten. Ethische richtlijnen voorkomen bevooroordeelde output. Versiebeheer volgt modelupdates. Documentatie legt architecturale beslissingen vast.
Gebruik hoogwaardige, domeinspecifieke data
Zorgvuldig samengestelde datasets verbeteren de nauwkeurigheid van de output. Ruisverwijdering elimineert verwarrende tekst. Gestandaardiseerde formaten stroomlijnen trainingspipelines. Regelmatige audits houden de data gezond.
- Zorgvuldig samengestelde datasets geven modellen duidelijke semantische leersignalen.
- Ruisreductie filtert irrelevante internettekst volledig weg.
- Gestandaardiseerde schema’s ordenen bedrijfsdocumenten uit meerdere bronnen op de juiste manier.
Bescherm gevoelige bedrijfsinformatie
Datamasking verbergt vertrouwelijke cijfers. Lokale servers isoleren bedrijfseigen bestanden. Zero-retentionbeleid beschermt de privacy van gebruikers. Netwerkfirewalls blokkeren externe bedreigingen.
- Datamasking vervangt echte namen door veilige plaatsaanduidingen.
- Lokale serverimplementaties isoleren bestanden van openbare netwerken.
- Zero-data-retentionovereenkomsten beschermen de privacy van bedrijfsprompts strikt.
- Netwerkfirewalls blokkeren ongeautoriseerde pogingen tot externe indringing.
Evalueer de prestaties van het AI-model continu
Geautomatiseerde benchmarks meten nauwkeurigheidstrends. Gebruikersfeedback signaleert operationele problemen. Red teaming brengt verborgen kwetsbaarheden aan het licht. Regelmatige reviews werken de prestatiedoelen bij.
- Geautomatiseerde testscripts volgen de trends in nauwkeurigheidsmetingen na verloop van tijd.
- Beoordelingsknoppen voor gebruikers leggen direct feedback over de prestaties in de praktijk vast.
Zorg voor naleving van regelgeving
Juridische teams beoordelen de omgang met data. GDPR-richtlijnen beschermen de privacy van klanten. Branchestandaarden bepalen de beveiligingsmaatregelen. Documentatie bewijst de naleving van regelgeving.
- Juridische reviews waarborgen naleving van strikte wetgeving voor gegevensprivacy.
- GDPR-protocollen beheren toestemming van gebruikers en verzoeken tot gegevensverwijdering.
- Branchestandaarden schrijven specifieke sterktes van versleutelingssleutels voor.
Praktijkvoorbeelden van custom LLM-ontwikkeling in verschillende sectoren
Custom LLM’s transformeren sectoren door complexe juridische documentanalyse in de financiële wereld te automatiseren, hypergepersonaliseerde diagnostische suggesties in de zorg mogelijk te maken en hypergerichte voorraadlogistiek in de retail aan te sturen. Ontdek hoe organisaties in uiteenlopende sectoren deze op maat gemaakte systemen inzetten om workflows te optimaliseren, overheadkosten drastisch te verlagen en een enorm concurrentievoordeel te behalen.
Zorg
Klinische modellen vatten patiëntgeschiedenissen samen. Medisch onderzoekers analyseren studies naar geneesmiddelinteracties. Diagnostische assistenten verwerken notities bij scans. Administratieve workflows versnellen de facturatie.
- Klinische modellen vatten uitgebreide medische patiëntgeschiedenissen samen voor artsen.
- Onderzoekstools analyseren complexe studies naar geneesmiddelinteracties snel.
Bankieren en financiële dienstverlening
Fraudedetectie-algoritmen analyseren transactiestromen. Algoritmische handelaren verwerken marktrapporten. Compliancesystemen beoordelen leningaanvragen. Geautomatiseerde agents beantwoorden vragen over rekeningen.
- Fraudedetectie-algoritmen markeren verdachte transactiestromen direct.
- Financiële modellen analyseren winstrapporten voor zakelijke beleggers.
- Compliancetools beoordelen risicofactoren van leningaanvragen grondig.
- Geautomatiseerde assistenten beantwoorden 24/7 routinevragen van klanten over hun rekening.
Juridisch
Contractanalyzers signaleren ongunstige clausules. Zoekmachines voor jurisprudentie halen precedenten op. Documentsamenvatters beoordelen verklaringen onder ede. Due diligence-pipelines verwerken fusies.
- Contractanalyzers markeren ongunstige aansprakelijkheidsclausules direct.
- Juridische zoekmachines halen relevante historische precedenten op.
Maakindustrie
Supplychainmodellen voorspellen tekorten aan materialen. Onderhoudslogs plannen machinereparaties. Kwaliteitscontrolesystemen analyseren defectrapporten. Ontwerpassistenten beoordelen blauwdrukken.
- Supplychainmodellen voorspellen risico’s op tekorten aan grondstoffen vroegtijdig.
- Onderhoudslogs plannen proactieve reparaties van fabrieksmachines.
- Kwaliteitscontrolesystemen analyseren defectrapporten van de assemblage.
- Ontwerpassistenten beoordelen complexe technische blauwdrukken.
Retail en e-commerce
Aanbevelingssystemen stellen relevante producten voor. Voorraadmodellen voorspellen seizoensgebonden vraag. Meertalige chatbots helpen klanten wereldwijd. Sentimentanalyzers beoordelen feedback.
- Aanbevelingssystemen stellen relevante producten voor aan online kopers.
- Voorraadmodellen voorspellen de seizoensgebonden voorraadvraag nauwkeurig.
Klantenservice
Ticketingsystemen routeren problemen automatisch. Sentimenttrackers geven boze bellers voorrang. Kennisbanken genereren direct antwoorden. Antwoordassistenten stellen beleefde reacties op.
- Ticketingsystemen routeren klantproblemen naar de juiste medewerkers.
- Sentimenttrackers geven boze bellers voorrang in de supportwachtrijen.
- Kennisbanken genereren direct antwoorden voor gebruikers.
- Antwoordassistenten stellen beleefde e-mailreacties voor klanten op.
Zo kies je het juiste custom LLM-ontwikkelbedrijf voor jouw organisatie
Het evalueren van potentiële custom LLM-ontwikkelpartners vraagt om een analyse van hun portfolio van geïmplementeerde enterprise-modellen, hun technische expertise in fine-tuningframeworks, hun dataveiligheidsprotocollen en hun onderhoudsmogelijkheden na livegang.
Hier duiken we in de belangrijkste evaluatiecriteria voor het selecteren van een betrouwbare technologieleverancier die jouw ambitieuze AI-visie succesvol kan omzetten in een veilige, productieklare enterprise-realiteit.
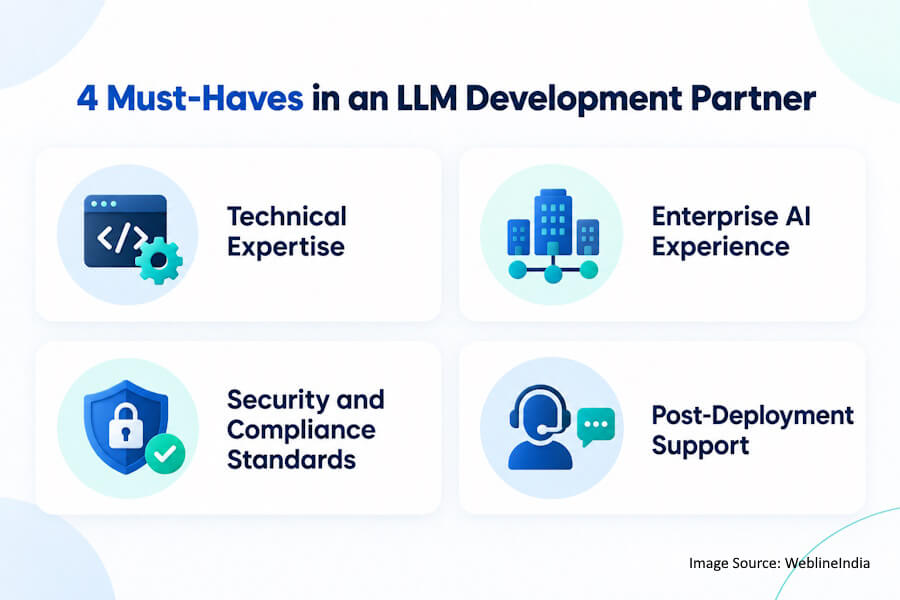
Technische expertise
Engineers evalueren de deep learning-kwalificaties. Teams tonen succesvolle modelimplementaties aan. Certificeringen bewijzen vaardigheid in cloudinfrastructuur. Portfolio’s laten complexe enterprise-oplossingen zien.
Enterprise AI-ervaring
Leveranciers begrijpen de beveiligingseisen van bedrijven. Casestudy’s bewijzen branchespecifieke kennis. Klantreferenties valideren eerdere prestaties. Schaalcapaciteiten sluiten aan op de behoeften van het bedrijf.
- Leveranciers begrijpen de strikte compliance-eisen voor bedrijfsbeveiliging.
- Casestudy’s bewijzen diepgaande, branchespecifieke operationele kennis.
Beveiligings- en compliancestandaarden
Partners handhaven strikte regels voor gegevensprivacy. Certificeringen verifiëren de beveiliging van de infrastructuur. Juridische overeenkomsten beschermen intellectueel eigendom. Audittrails waarborgen naleving van regelgeving.
- Ontwikkelpartners handhaven strikte interne regels voor gegevensprivacy.
- Beveiligingscertificeringen verifiëren robuuste bescherming van de cloudinfrastructuur.
- Juridische contracten beschermen het bedrijfseigen intellectueel eigendom.
- Audittrails waarborgen volledige naleving van de regelgeving in de sector.
Ondersteuning na implementatie
Onderhoudscontracten waarborgen de beschikbaarheid van het systeem. Monitoringdiensten volgen prestatiemetingen. Regelmatige updates houden modellen actueel. Toegewijde supportteams lossen bugs op.
- Onderhoudsovereenkomsten garanderen een hoge beschikbaarheid van applicaties en systemen.
- Monitoringdiensten volgen live de nauwkeurigheid van de prestaties.
Toekomstige trends in custom LLM-ontwikkeling en enterprise AI
Het enterprise AI-landschap verschuift snel richting hyperefficiënte edge computing, multimodale mogelijkheden en autonome agentische workflows die complexe, meerstaps-bedrijfsprocessen uitvoeren zonder menselijke tussenkomst.
Nu bekijken we de aankomende technologische doorbraken en strategische innovaties die gaan bepalen hoe jouw organisatie in de komende jaren custom large language models inzet.
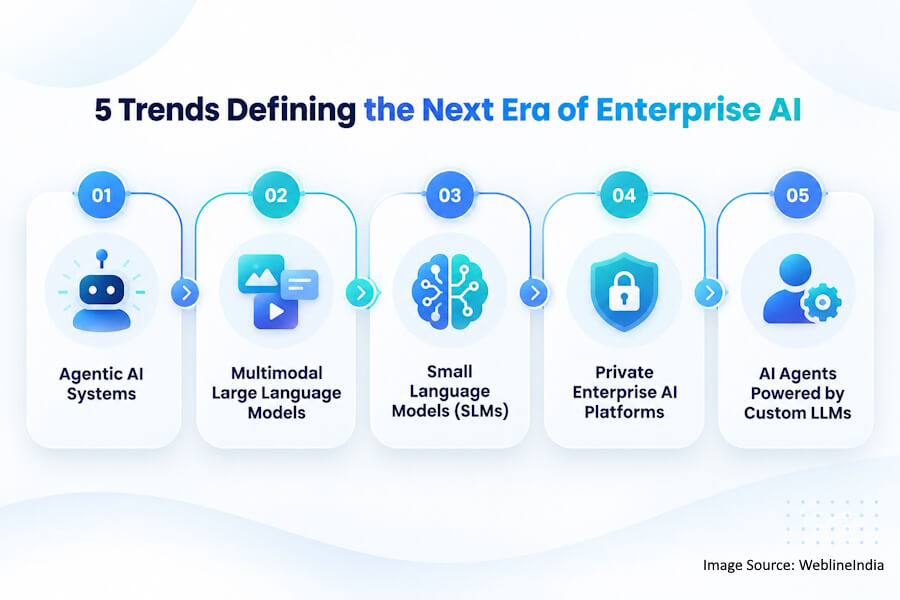
Agentische AI-systemen
Autonome agents voeren meerstaps-workflows uit. Systemen werken samen om problemen op te lossen. Beslissingsengines beheren complexe taken. De productiviteit stijgt binnen alle afdelingen.
Multimodale Large Language Models
Modellen verwerken tekst, audio en video. Geïntegreerde sensoren analyseren fysieke omgevingen. Rijke invoer verbetert het contextueel begrip. Toepassingen bestrijken meerdere zintuiglijke typen.
- Modellen verwerken tegelijkertijd tekst-, audio- en videostreams.
- Geïntegreerde sensoren analyseren fysieke fabrieksomgevingen.
- Rijke invoerstromen verbeteren het diepe contextuele begrip.
- Toepassingen bestrijken naadloos meerdere typen zintuiglijke data.
Small Language Models (SLM’s)
Compacte modellen draaien op edge-apparaten. Lokale hardware verwerkt queries direct. De resourcebehoefte daalt aanzienlijk. Privacy verbetert door lokale uitvoering.
- Compacte modellen draaien lokaal op edge-apparaten.
- Lokale hardware verwerkt gebruikersqueries direct.
Private enterprise AI-platforms
Beveiligde platforms centraliseren AI-tools. Interne marktplaatsen delen getrainde modellen. Governance-dashboards monitoren het systeemgebruik. Ondernemingen bepalen zelf hun AI-toekomst.
- Beveiligde platforms centraliseren AI-tools van het bedrijf.
- Interne marktplaatsen delen custom getrainde modelgewichten.
- Governance-dashboards monitoren het bedrijfsbrede systeemgebruik.
- Ondernemingen hebben volledige controle over hun AI-infrastructuur.
AI-agents aangedreven door custom LLM’s
Enterprise AI-agentontwikkeling kan gespecialiseerde agents combineren met custom LLM’s om bedrijfsprocessen uit te voeren en softwareworkflows te coördineren. Slimme assistenten beheren dagelijkse agenda’s. Efficiëntiewinst transformeert enterprise-workflows.
- Gespecialiseerde agents voeren complexe bedrijfsprocessen automatisch uit.
- Geautomatiseerde tools coördineren deploymentpipelines voor softwareontwikkeling.
Slotgedachten over het bouwen van een eigen LLM voor langdurig zakelijk succes
De adoptie van kunstmatige intelligentie bepaalt de toekomstige marktleiders. Generieke openbare tools schieten tekort voor enterprise-eisen. Organisaties bouwen custom modellen om hun data te beveiligen. Bedrijfseigen workflows vragen om gespecialiseerde intelligentie. Succes op de lange termijn vereist een robuuste AI-infrastructuur. Bedrijven werken samen met gespecialiseerde aanbieders om de uitvoering te versnellen.
WeblineIndia levert uitstekende Custom LLM-ontwikkelingsdiensten. Engineeringteams bouwen veilige enterprise-LLM’s. Specialisten fine-tunen modellen voor maximale nauwkeurigheid. WeblineIndia transformeert bedrijfsprocessen met custom AI-oplossingen. Organisaties behalen vandaag nog duurzame concurrentievoordelen. Neem contact op met WeblineIndia om te starten met de integratie van custom kunstmatige intelligentie.
Sociale hashtags
#CustomLLM #LargeLanguageModels #EnterpriseAI #GenerativeAI #KunstmatigeIntelligentie #LLM #AI-ontwikkeling #AI-engineering #AgenticAI #AIAgents #RetrievalAugmentedGeneration #RAG #MachineLearning #AI-infrastructuur #DigitaleTransformatie #EnterpriseTechnologie #MLOps #AI-innovatie #PrivateAI #Bedrijfsautomatisering
Bouw een veilige, schaalbare custom LLM, afgestemd op je enterprise-data en workflows, samen met een ervaren AI-ontwikkelteam.
Veelgestelde vragen
Hoe bouw ik een aangepast LLM voor mijn bedrijf?
Bedrijven verzamelen eigen data, selecteren krachtige open-source architecturen, verfijnen modelgewichten op beveiligde servers en zetten schaalbare infrastructuur in om interne workflows te automatiseren en gevoelig intellectueel eigendom te beschermen.
Moet ik een LLM vanaf nul bouwen of een bestaand model verfijnen?
Het verfijnen van bestaande basismodellen (foundation models) bespaart tijd en geld, terwijl de voorgetrainde taalstructuur wordt aangepast aan specifieke domeinen. Training vanaf nul is alleen nodig bij volledig unieke taalkundige of beveiligingstechnische vereisten.
Welke data is nodig om een aangepast taalmodel te trainen?
Ingenieurs verzamelen schone interne documenten, technische handleidingen, historische transcripties en gestructureerde databasegegevens. Teams moeten persoonsgegevens verwijderen en tekst zorgvuldig formatteren voordat deze in trainingspipelines wordt ingevoerd.
Wat kost de ontwikkeling van een aangepast LLM?
De kosten variëren afhankelijk van het aantal parameters, de huur van hardware en de arbeid voor datavoorbereiding. Cloud-GPU-clusters vereisen aanzienlijke investeringen, terwijl het verfijnen van bestaande adapters de totale implementatiekosten verlaagt.
Welk open-source LLM is het meest geschikt voor grote ondernemingen?
Meta Llama en Mistral AI bieden uitstekende prestaties en open modelgewichten voor veilige lokale implementaties. Organisaties kiezen specifieke varianten op basis van parameterlimieten en beschikbare rekenkracht.
Hoe lang duurt het om een aangepast LLM te bouwen?
De doorlooptijd varieert van enkele weken tot meerdere maanden, afhankelijk van de complexiteit van de dataset. Gefaseerde uitrol en het gebruik van voorgetrainde basismodellen versnellen de initiële implementatie voor bedrijfsteams.
Kunnen bedrijven hun eigen private AI-modellen creëren?
Ondernemingen implementeren modellen op lokale serverhardware of in beveiligde private cloud-subnets. Dit garandeert volledige data-isolatie en voorkomt dat externe API-aanbieders vertrouwelijke bedrijfsgegevens kunnen inzien.
Welke infrastructuur is nodig voor LLM-ontwikkeling?
Deep learning vereist krachtige GPU-clusters, robuuste netwerkhardware en snelle vectordatabases. DevOps-engineers configureren schaalbare Kubernetes-nodes om de zware belasting van inferentie-verkeer aan te kunnen.
Hoe implementeren bedrijven aangepaste LLM's?
DevOps-teams zetten cloud-inferentie-instanties of lokale server-nodes op. API-gateways verbinden interne bedrijfsapplicaties, terwijl load balancers het inkomende verkeer soepel over de servers verdelen.
Wat zijn de voordelen van private LLM's?
Private modellen waarborgen strikte dataprivacy, elimineren abonnementskosten per token en leveren nauwkeurige, sectorspecifieke antwoorden. Organisaties behouden volledige controle over de modelgewichten en het beveiligingsbeleid van het systeem.
Wat is RAG en hoe verhoudt dit zich tot fine-tuning?
Bij Retrieval-Augmented Generation worden actuele externe documenten dynamisch opgehaald, zonder de gewichten van het kernmodel te wijzigen. Bij fine-tuning worden de parameters van het neurale netwerk rechtstreeks aangepast om het model geschikt te maken voor gespecialiseerd vocabulaire en specifiek gedrag binnen bedrijfsmatige workflows.
Hoe veilig zijn LLM's voor bedrijven?
Bedrijfsplatforms hanteren strikte, op rollen gebaseerde toegangscontroles, versleuteling van opgeslagen gegevens en beleid waarbij gegevens niet worden bewaard (zero-retention). Beveiligingsaudits en lokale firewalls beschermen vertrouwelijke informatie tegen kwaadaardige cyberdreigingen.
Wereldwijd erkend om ongeëvenaarde kwaliteit en betrouwbaarheid


Referenties: hoor het rechtstreeks van onze wereldwijde klanten
Onze ontwikkelprocessen leveren dynamische oplossingen om zakelijke uitdagingen aan te gaan, kosten te optimaliseren en digitale transformatie te versnellen. Door experts ondersteunde oplossingen versterken klantloyaliteit en online aanwezigheid, terwijl bewezen succesverhalen laten zien hoe innovatieve applicaties echte problemen oplossen. Onze gewaardeerde klanten wereldwijd hebben het al ervaren.
Prijzen en Erkenningen
Hoewel tevreden klanten onze grootste motivatie zijn, heeft erkenning van de industrie aanzienlijke waarde. WeblineIndia is consistent toonaangevend in technologie, met prijzen en onderscheidingen die onze uitmuntendheid bevestigen.
OA500 Wereldwijde outsourcingbedrijven 2025, door Outsource Accelerator
Topsoftware-ontwikkelingsbedrijf, door GoodFirms
Beste fintech-productoplossingsbedrijf – 2022, door GESIA
Bekroond als – Beste app-ontwikkelingsbedrijf in India 2020, door SoftwareSuggest