Så här bygger du en skräddarsydd LLM för ditt företag
Lär dig hur du skapar en skräddarsydd LLM för ditt företag genom en steg-för-steg-process som omfattar dataförberedelse, val av grundmodell, finjustering, RAG, infrastruktur, driftsättning, säkerhet, kostnader och användningsområden inom företag.


 ChatGPT
 Perplexity
Att bygga en skräddarsydd LLM för ditt företag innebär att identifiera specifika användningsfall, förbereda relevant data, välja rätt modellarkitektur och implementera effektiva tränings- och testprocesser. En skräddarsydd LLM kan förbättra automatisering, effektivitet, kundupplevelser och beslutsfattande inom hela verksamheten.
Vad är en skräddarsydd stor språkmodell (LLM) och varför behöver företag en?
Standardiserade grundläggande AI-modeller är byggda för att besvara breda, allmänna frågor. Dessa generiska modeller saknar specifik operativ kontext. Organisationer kämpar med brister i noggrannhet. Generiska system hittar på företagsfakta som inte stämmer. Företag behöver specialiserad domänkunskap. Skräddarsydd LLM-utveckling överbryggar exakt detta gap. Proprietär data förblir intern. Säkerhetsprotokoll förhindrar att data läcker ut. Organisationer bygger en företags-LLM för att bearbeta känsliga dokument.
Skräddarsydda AI-utvecklingstjänster riktar in sig på specifika arbetsflöden. Anställda laddar upp interna tekniska manualer. Systemet lär sig proprietär terminologi omedelbart. Utveckling av stora språkmodeller innebär omfattande parameterjustering. Företag går från publika verktyg till säker infrastruktur. Privata LLM-driftsättningar garanterar dataisolering. Finansinstitut bearbetar konfidentiella dokument på ett säkert sätt. Vårdgivare skyddar patientjournaler noggrant.
Standardmodeller misslyckas med tekniska frågor. Skräddarsydd GPT-utveckling adresserar nischade branscher. Organisationer använder AI-modellutveckling för att automatisera komplexa skrivuppgifter. Företags-AI-modeller förstår interna mätvärden. Företag väljer LLM-lösningar med öppen källkod för att behålla äganderätten till koden. Detta tillvägagångssätt eliminerar prenumerationsavgifter till tredje part. Proprietära vikter stannar på lokala servrar. Hög operativ kontroll stärker interna ingenjörsteam. AI-infrastruktur kräver kraftfulla beräkningskluster. Ingenjörer konfigurerar distribuerade processnoder.
Viktiga fördelar med att bygga en skräddarsydd LLM för företagsapplikationer
Att bygga en skräddarsydd stor språkmodell (LLM) gör det möjligt för organisationer att behålla säkerheten kring proprietär data, drastiskt minska hallucinationer genom domänspecifik finjustering och sömlöst automatisera komplexa interna arbetsflöden.
Låt oss förstå varför det ger en oöverträffad operativ effektivitet och en verklig konkurrensfördel i moderna företagsmiljöer att skräddarsy en AI-modell specifikt efter organisationens egen data.
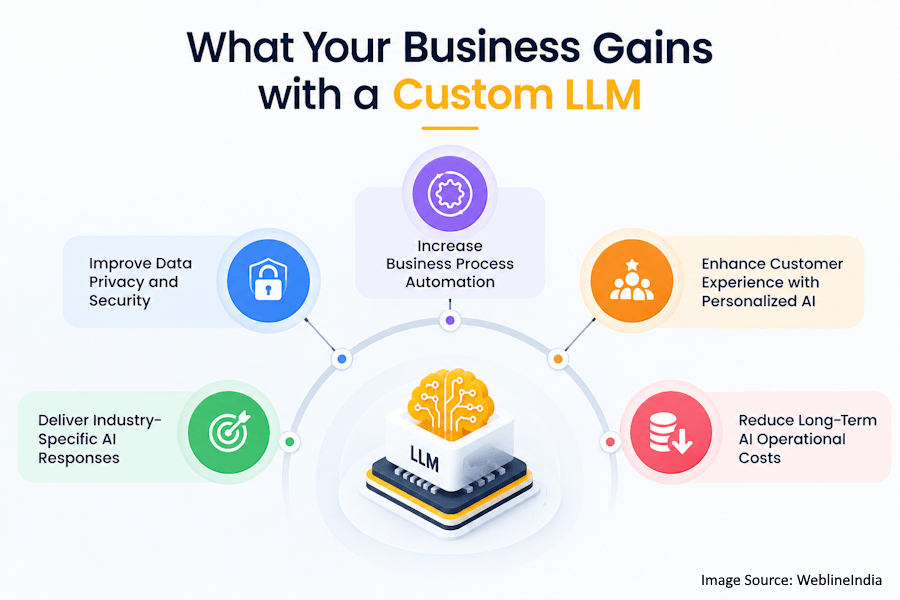
Förbättra dataskydd och säkerhet
Publika AI-plattformar sparar användarnas indata. Externa servrar tar emot proprietära företagshemligheter. Företag riskerar hårda regulatoriska sanktioner. Skräddarsydda AI-modellutvecklingstjänster eliminerar riskerna med publika moln. Datan stannar i lokala datacenter. Säkerhetsteam krypterar information i vila. Anställda kan dela konfidentiella rapporter säkert. Compliance-ansvariga upprätthåller strikt åtkomstkontroll. Privat LLM-utveckling skyddar immateriella rättigheter.
- Företagets servrar lagrar promptloggar lokalt.
- Externa API-leverantörer ser aldrig intern data.
- Säkerhetsingenjörer konfigurerar strikta brandväggsregler.
Leverera branschspecifika AI-svar
Generiska modeller missförstår tekniskt fackspråk. Specialiserade domäner kräver precist ordförråd. Skräddarsydda LLM-utvecklingstjänster tränar modeller på nischade datamängder. Ingenjörer finjusterar en LLM för att uppnå noggrannhet för verksamheten. Advokatbyråer laddar upp arkiv med rättspraxis. Medicinska forskare bearbetar anteckningar från kliniska prövningar. Systemet producerar korrekt terminologi.
- Juridiska databaser förser specialiserade träningspipelines med historiska dokument.
- Medicinska tidskrifter förbättrar noggrannheten i kliniska frågor för sjukhusdiagnostik.
- Ingenjörsteam integrerar ritningar för att vägleda tekniska resonemangsmotorer.
Öka automatiseringen av affärsprocesser
Manuell dokumentsortering tar mycket arbetstid i anspråk. LLM:er kan också komplettera tjänster för automatisering av affärsprocesser genom att stödja arbetsflöden som dokumenthantering, ärenderoutning och informationsutvinning. System dirigerar inkommande supportärenden direkt. Tjänster för företags-AI-utveckling kan stödja arkitekturer utformade för att hålla känslig företagsdata inom kontrollerade miljöer. Algoritmer extraherar data från ostrukturerade fakturor. Företags-AI-modeller utför affärslogik i flera steg.
- Automatiserad fakturahantering sparar hundratals manuella arbetstimmar för ekonomiavdelningar varje månad.
- Supportchattbotar löser tekniska ärenden direkt genom att referera till interna felsökningswikier.
- Logistiksystem tolkar fraktmanifest automatiskt för att uppdatera lagerdatabaser.
- Fel vid dataregistrering minskar avsevärt inom hela verksamheten.
Förbättra kundupplevelsen med personlig AI
Generiska svar frustrerar kunder. Kunder efterfrågar kontextuell hjälp. Utveckling av företags-AI-modeller integrerar kundhistorikdatabaser. Plattformen minns tidigare köp. Supportagenter löser ärenden snabbare. Varumärkeslojaliteten ökar stadigt.
- Rekommendationsmotorer analyserar tidigare köpbeteende för att föreslå relevanta varor.
- Chattbotar refererar till enskilda kunders prenumerationsnivåer för att ge korrekt support utifrån kontonivå.
Minska långsiktiga driftskostnader för AI
Externa API-tokens ackumulerar höga avgifter. Företagstrafik med stor volym ökar de månatliga kostnaderna. Företag tränar sin egen språkmodell för att kringgå avgifter per token. Fasta hårdvarukostnader ersätter rörlig API-fakturering. Organisationer kan budgetera på ett förutsägbart sätt.
- Fasta infrastrukturkostnader ersätter växande API-räkningar under perioder med hög trafik.
- Höga volymer av förfrågningar blir billigare över tid på lokala företags-GPU:er.
- Interna team optimerar inferenshastigheten på egen hand, utan begränsningar från tredjepartsplattformar.
- Resursallokeringen matchar effektivt exakta toppar i affärsbehoven.
Omvandla er företagsdata till en säker, domänspecifik AI-lösning byggd kring era arbetsflöden, användare och verksamhetskrav.
Skräddarsydd LLM kontra förtränad LLM: Vilken AI-modell passar ert företag?
Förtränade modeller ger omedelbara, kostnadseffektiva möjligheter för generella uppgifter, medan skräddarsydda modeller levererar oöverträffad säkerhet och precision, exakt anpassade till er unika branschterminologi.
Låt oss dyka ner i en omfattande jämförelse för att avgöra vilken strategisk väg som passar bäst med era långsiktiga affärsmål.
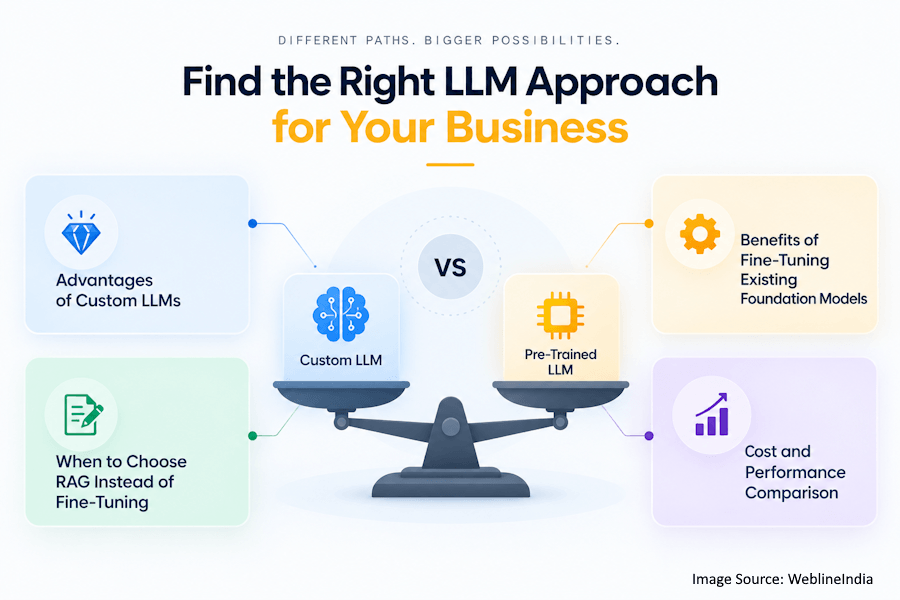
Fördelar med skräddarsydda LLM:er
Organisationer äger sina modellvikter. Ingenjörer kan modifiera de neurala nätverkets lager direkt. Skräddarsydd LLM-utveckling ger oöverträffad arkitektonisk kontroll. Proprietära algoritmer skyddar konkurrensfördelar. Säkerhetspolicyer upprätthåller regler om noll datalagring. Prestandan matchar exakt de aktuella arbetsbelastningarna i verksamheten.
- Fullt ägarskap förhindrar inlåsning hos en enskild leverantör och godtyckliga prishöjningar.
- Finjusteringsparametrar anpassas med hög precision till nischade branschdomäner.
- Inferenshastigheten optimeras för specifika hårdvarukonfigurationer i lokala datacenter.
Fördelar med att finjustera befintliga grundmodeller
Att bygga från grunden kostar miljonbelopp. Tjänster för finjustering av AI-modeller kan minska behovet av träning från grunden genom att anpassa befintliga grundmodeller efter domänspecifika krav. Befintliga modeller ger en stark grammatisk grund. Domänspecifika datamängder anpassar de förtränade vikterna. Träningscyklerna slutförs inom några dagar. Ingenjörer använder ramverk för LLM-utveckling med öppen källkod.
- Förtränade vikter ger snabb grundkompetens utan omfattande träning från grunden.
- De beräkningsmässiga kostnaderna förblir lägre än vid en fullständig träningsomgång på flera miljoner dollar.
- Specialiserade datamängder riktar om generella resonemangsförmågor mot specifika affärsuppgifter.
- Utvecklingstiden krymper från år till veckor.
När man bör välja RAG framför finjustering
Träning förändrar modellens grundläggande vikter. RAG (Retrieval-Augmented Generation) lämnar vikterna orörda. Företag uppdaterar externa kunskapsbaser dagligen. RAG-system hämtar dokument dynamiskt. Ingenjörer väljer RAG för wikier som ändras ofta. Utvecklingskostnaderna förblir minimala.
- Dynamiska dokumentuppdateringar kräver inga omträningscykler eller viktuppdateringar.
- Externa vektordatabaser lagrar företagets levande wikier för omedelbar hämtning.
Kostnads- och prestandajämförelse
Skräddarsydda arkitekturer kräver massiva beräkningskluster. Finjustering av en grundmodell kräver måttliga GPU-hyror. RAG-arkitekturer förlitar sig på snabba vektorsökningar. Finansiella planerare beräknar exakt avkastning på investeringen. Prestandabenchmarks avgör vilken arkitektur som väljs.
- Skräddarsydd förträning medför beräkningskostnader på flera miljoner dollar för de rena träningsomgångarna.
- Finjustering kräver mer blygsamma moln-GPU-budgetar för uppdatering av adaptervikter.
- RAG-implementationer optimerar kostnaderna för databaslagring samtidigt som en hög faktisk noggrannhet bibehålls.
- Latensmått styr de slutliga valen för produktionsdriftsättning inom olika affärsenheter.
Steg-för-steg-process för att bygga en skräddarsydd LLM för ert företag
Att bygga en skräddarsydd LLM innebär att definiera specifika affärsanvändningsfall, samla in och rensa proprietär data, välja rätt grundmodell, finjustera genom specialiserad träning och noggrant utvärdera prestandan innan säker driftsättning i verksamheten.
Låt oss utforska varje fas i detalj för att se hur denna strukturerade färdplan säkerställer att er AI-implementering blir en sömlös framgång.
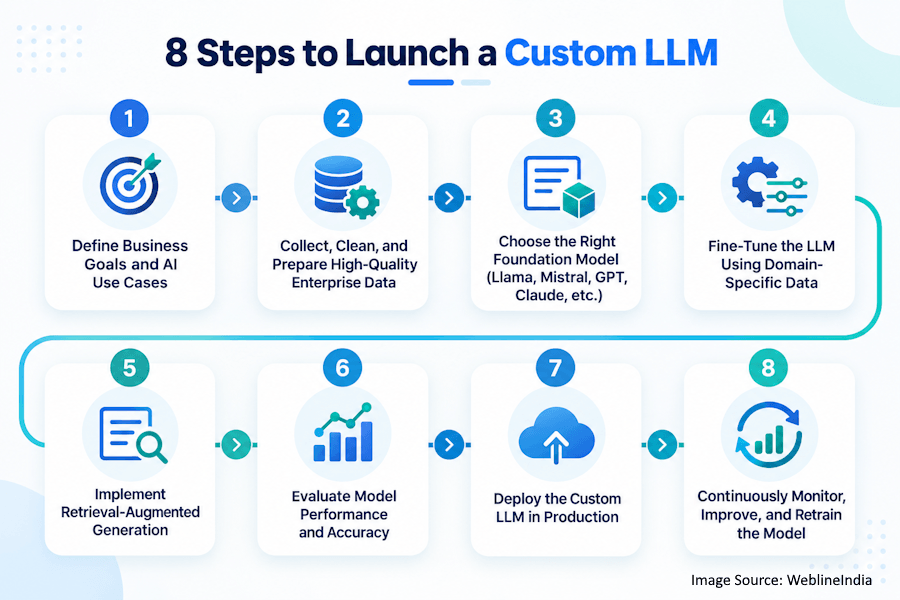
Definiera affärsmål och AI-användningsfall
Ledningen kartlägger exakt var de operativa flaskhalsarna finns. Ingenjörer identifierar repetitiva manuella uppgifter. Projektledare definierar framgångsmått. Tydliga mål förhindrar slöseri med beräkningsresurser. Intressenter granskar samordningsdokument noggrant.
Samla in, rensa och förbered högkvalitativ företagsdata
Rådata från verksamheten innehåller formateringsfel. Ingenjörer rensar bort dubbletter av poster utan pardon. Textparsrar tar bort känsliga personuppgifter. Rena datamängder matar träningspipelines. Hög datakvalitet säkerställer tillförlitliga resultat.
- Dataingenjörer extraherar rå text från äldre företagsdatabaser.
- Automatiserade skript tar bort korrupta teckenkodningar från dokument.
- Rensning av personuppgifter skyddar de anställdas integritet innan träningen påbörjas.
- Formaterade JSON-filer organiserar träningsexemplen korrekt för modellerna.
Välj rätt grundmodell (Llama, Mistral, GPT, Claude med flera)
Valet av modell avgör den framtida framgången. Ingenjörer testar flera grundarkitekturer. Öppna vikter ger frihet för lokal driftsättning. Proprietära modeller ger en stark resonemangsgrund. Licensavtal styr de kommersiella användningsrättigheterna.
- Benchmarktester utvärderar grundläggande resonemangshastigheter hos olika kandidatmodeller.
- Licensvillkoren tillåter kommersiell driftsättning i verksamheten utan juridiska risker.
Finjustera LLM:en med domänspecifik data
Specialiserade adaptrar ändrar modellens beteende, medan tjänster för utveckling av maskininlärning kan stödja det bredare arbetet med träning, validering och modellutveckling. Förlustkurvorna sjunker under träningens epoker. Ingenjörer validerar resultaten mot testdata. De slutliga vikterna sparas i säkra lagringsplatser.
- LoRA-adaptrar minimerar antalet aktiva träningsparametrar under finjusteringen.
- GPU-kluster bearbetar effektivt terabyte med domäntext.
- Förlustmått följer konvergenstakten under modellens träningsepoker.
Implementera Retrieval-Augmented Generation
Textdelare styckar upp långa företagsrapporter. Embedding-modeller omvandlar text till vektorer. Vektordatabaser indexerar semantisk information. Sökalgoritmer hämtar relevant dokumentkontext. Prompter kombinerar hämtade fakta med frågor.
- Textstyckning delar effektivt upp stora manualer i mindre segment.
- Embedding-modeller omvandlar ord till numeriska vektorer för indexering.
- Vektordatabaser lagrar flerdimensionella semantiska index för snabba sökningar.
- Kontextinjektion förankrar modellens svar i verifierade fakta.
Utvärdera modellens prestanda och noggrannhet
Automatiserade testskript mäter svarens kvalitet. Mänskliga granskare bedömer subjektiva resultat. Benchmarksviter testar resonemangsförmågans gränser. Säkerhetsfilter testas mot sårbarheter för promptinjektion. Dåliga resultat utlöser omedelbar omträning.
- Automatiserade utvärderingsskript kör testsviter mot resultaten.
- Mänskliga experter bedömer manuellt domännoggrannheten för en kvalitativ granskning.
Driftsätt den skräddarsydda LLM:en i produktion
DevOps-tjänster kan stödja tillhandahållandet av molnbaserade inferensservrar, driftsättningspipelines och skalbara produktionsmiljöer för skräddarsydda LLM:er. Lastbalanserare fördelar inkommande användartrafik. API-slutpunkter kopplar samman interna applikationer. Övervakningsverktyg följer systemets hälsa. Produktionsmiljöer säkerställer hög tillgänglighet.
- Kubernetes-kluster skalar inferensnoder automatiskt vid trafiktoppar.
- API-gatewayer hanterar säkert autentiseringstokens för användare i verksamheten.
- Lastbalanserare fördelar tung förfrågningstrafik smidigt mellan servrar.
- Reservlösningar förhindrar oväntade driftstopp vid underhåll.
Övervaka, förbättra och omträna modellen löpande
Användarnas feedback belyser operativa brister. Loggningspipelines fångar felaktiga svar. Dataforskare kurerar nya träningsexempel. Schemalagd omträning uppdaterar modellens vikter. Företagssystem utvecklas i takt med verksamhetens behov.
- Feedbackknappar fångar användarnas betygsättning direkt efter att svaret genererats.
- Loggningssystem flaggar återkommande hallucinationer för granskning.
- Datapipelines tar varje vecka emot nyligen uppdaterade företagspolicyer.
- Schemalagda omträningscykler håller intelligensen aktuell i förhållande till marknaden.
Redo att omvandla er LLM-färdplan till en produktionsfärdig lösning? Våra AI-ingenjörer kan hjälpa er att bygga, finjustera, driftsätta och skala den.
Att välja bästa grundmodell för skräddarsydd LLM-utveckling
Att välja en optimal grundmodell kräver en avvägning mellan avgörande parametrar som beräkningsmässig overhead, licensbegränsningar i arkitekturen, grundläggande prestanda inom er domän och krav på inferenslatens, ställt mot organisationens specifika tekniska förutsättningar.
Låt oss analysera hur man systematiskt utvärderar dessa arkitektoniska variabler för att identifiera den modell som maximerar både förmåga och kostnadseffektivitet.
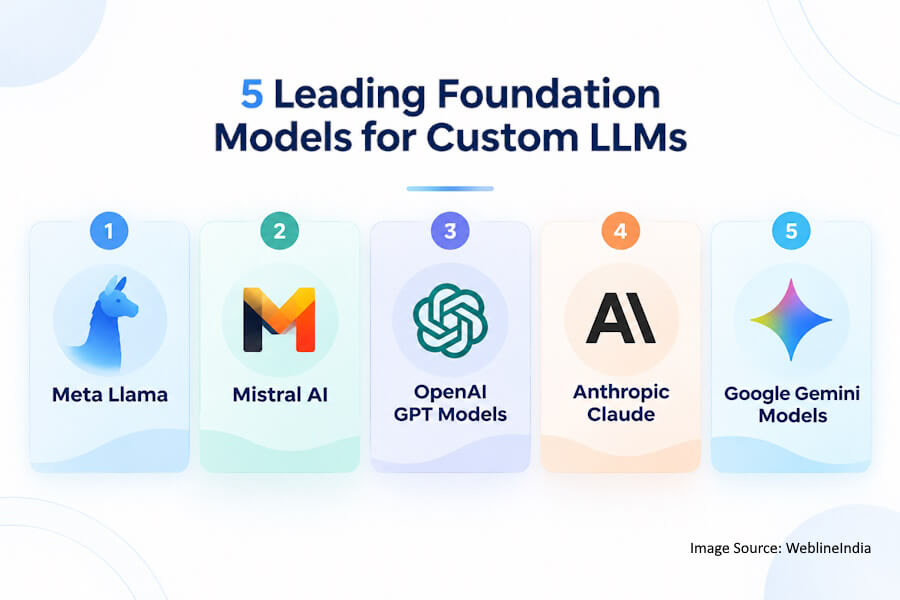
Meta Llama
Öppna vikter attraherar utvecklare inom verksamheten. Lokal driftsättning garanterar datasäkerhet. Finjustering av Llama-modeller kräver standardhårdvara. Communityforum erbjuder omfattande guider för felsökning.
- Vikter med öppen källkod möjliggör lokaliserad serverdriftsättning bakom brandväggar.
- Parameterstorlekarna skalar från små till massiva företagskonfigurationer.
Mistral AI
Europeisk ingenjörskonst driver hög effektivitet. Kompakta modeller ger snabba inferenshastigheter. Företagskunder licensierar proprietära viktvarianter. Arkitekturdesignen optimerar minnesförbrukningen.
- Effektiv arkitektur minskar avsevärt den operativa beräkningsoverheaden.
- Kompakta modellstorlekar snabbar upp svarstiderna för användarna.
- Starka resonemangsbenchmarks konkurrerar med större aktörer i branschen.
- Flexibel licensiering passar olika typer av kommersiella affärsstrukturer.
OpenAIs GPT-modeller
Proprietära API:er erbjuder en kraftfull resonemangsgrund. Utvecklare slipper hantera infrastrukturkluster. Regelbundna uppdateringar introducerar avancerade funktioner. Integritetspolicyer skyddar företagskundernas data.
- Hanterade API:er eliminerar uppgifter kring infrastrukturunderhåll för interna team.
- Avancerat resonemang hanterar komplexa logiska problem enkelt, utan justering.
Anthropic Claude
Långa kontextfönster kan bearbeta hela böcker. Säkerhetsräcken minimerar skadliga resultat. Företagskunder integrerar säkra API-slutpunkter. Finansanalytiker tolkar stora kalkylblad direkt.
- Massiva kontextfönster tar emot kompletta kodbaser och omfattande rapporter.
- Inbyggd konstitutionell säkerhet minskar skadliga eller olämpliga resultat.
- Dokumenttolkning extraherar strukturerad data från täta finansiella sidor.
Googles Gemini-modeller
Multimodala förmågor bearbetar text och video. Molninfrastrukturen integrerar inbyggda AI-verktyg. Sökfunktioner för verksamheten kopplas till interna diskar. Skalbara arkitekturer hanterar tunga arbetsbelastningar.
- Inbyggd multimodalitet bearbetar bilder och videoströmmar direkt.
- Integration med Google Cloud förenklar driftsättningspipelines för verksamheten.
Infrastruktur och teknikstack som krävs för skräddarsydd LLM-utveckling
Att utveckla en robust skräddarsydd LLM kräver högpresterande beräkningskluster utrustade med specialiserade GPU:er, skalbara datapipelines, ramverk för orkestrering i verksamheten och säkra vektordatabaser för retrieval-augmented generation.
Låt oss undersöka den nödvändiga tekniska arkitekturen för att effektivt driva er AI-infrastruktur.
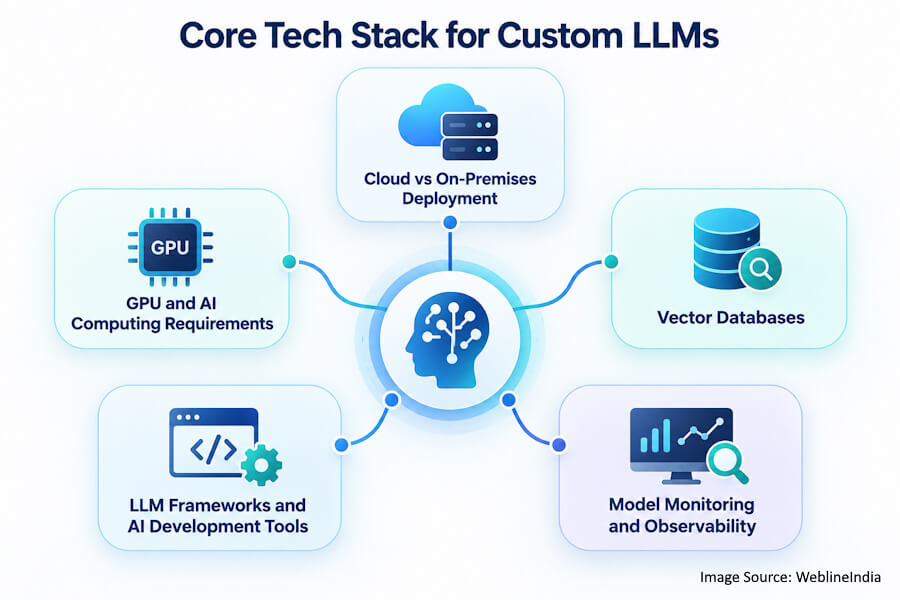
Moln jämfört med lokal driftsättning (on-premises)
Molnleverantörer erbjuder elastisk GPU-skalning. Lokala servrar skyddar mycket hemlig information. Finansiella regelverk styr reglerna för var hårdvaran ska placeras. Hybridarkitekturer balanserar kostnad och säkerhet.
Krav på GPU och AI-beräkningskraft
Djupinlärning kräver specialiserade acceleratorchip. Hög VRAM-kapacitet krävs för att ladda stora modeller. Sammankopplingshastigheten påskyndar distribuerade träningsuppgifter. Strömförbrukningen styr datacentrens budgetar.
- Kluster av NVIDIA H100 påskyndar drastiskt tiden det tar att träna modeller.
- Hög VRAM-kapacitet laddar massiva parametervikter på ett säkert sätt.
- Snabba sammankopplingar länkar flera träningsnoder utan latens.
Vektordatabaser
Embeddings kräver specialiserade lagringslösningar. Likhetssökningar hämtar matchande dokumentavsnitt. Skalbara arkitekturer hanterar miljarder vektorer. Indexeringshastigheten påverkar sökningarnas latens.
- Pinecone hanterar effektivt molnbaserade vektorsökningsindex.
- Milvus skalar sömlöst över distribuerade lokala serverkluster.
- Qdrant hanterar snabb metadatafiltrering under sökningar.
LLM-ramverk och AI-utvecklingsverktyg
Python-bibliotek förenklar konstruktionen av pipelines. Orkestreringsverktyg kedjar samman komplexa agentsteg. Kvantiseringspaket minskar modellens minnesavtryck. Containeriseringsverktyg standardiserar driftsättningsmiljöer.
- LangChain orkestrerar komplexa AI-agentarbetsflöden i flera steg.
- LlamaIndex kopplar externa dokument till modeller för RAG.
Modellövervakning och observerbarhet
Mätvärden följer förbrukningen av tokens. Felloggning avslöjar var prompter misslyckas. Avvikelsedetektering upptäcker sjunkande noggrannhetstrender. Säkerhetsskannrar blockerar skadliga indata.
- Grafana-dashboards visar systemets resursanvändning i realtid.
- Loggningsverktyg fångar felspår från användarnas prompter för analys.
- Avvikelsevakter varnar ingenjörer vid prestandaförsämringar.
- Säkerhetsfilter blockerar obehöriga försök till promptinjektion.
Vanliga utmaningar vid skräddarsydd LLM-utveckling och hur man bemästrar dem
Skräddarsydd LLM-utveckling innebär ofta utmaningar som skenande beräkningskostnader, risker för dataintegritet, katastrofal glömska under finjustering och hantering av modelldrift över tid.
Låt oss avslöja de beprövade strategierna som krävs för att framgångsrikt navigera förbi dessa vanliga tekniska hinder.
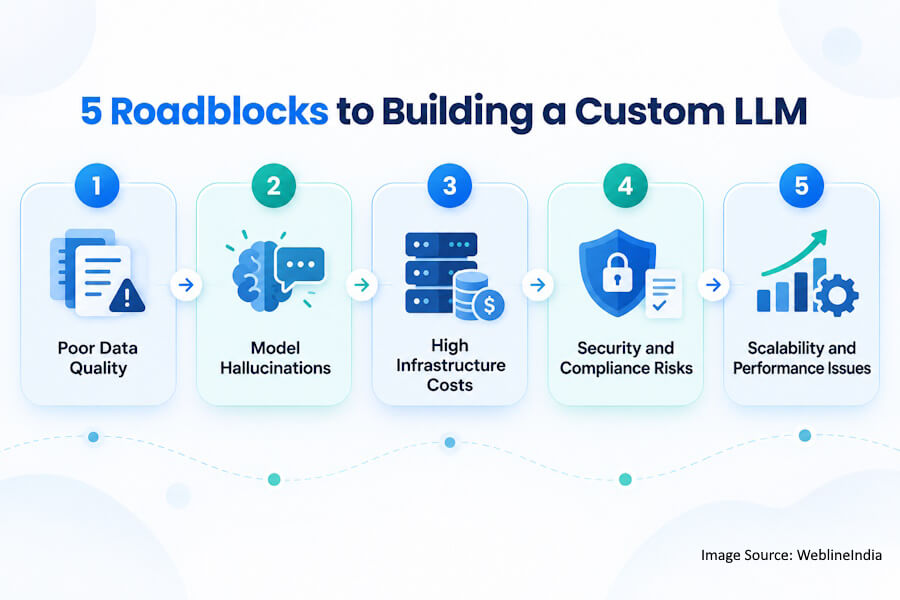
Dålig datakvalitet
Ofullständiga dokument orsakar oberäkneligt modellbeteende. Datarensningspipelines tar bort brus. Automatiserade valideringsskript kontrollerar textformat. Mänskliga granskare verifierar att datamängden är korrekt.
- Saknade dokumentavsnitt skapar luckor i det logiska resonemanget under träningen.
- Automatiserade regex-skript rensar bort korrupta tecken från filer.
Modellhallucinationer
Modeller hittar på falska historiska fakta. RAG-arkitekturer förankrar svaren i verkligheten. Strikta temperaturinställningar minskar kreativa påhitt. Utvärderingssviter fångar upp fel tidigt.
- Förankrande prompter begränsar svaren strikt till de källdokument som tillhandahållits.
- Låga temperaturinställningar minskar andelen slumpmässigt genererade resultat.
- Krav på källhänvisning tvingar modellerna att referera till dokumentkällor.
Höga infrastrukturkostnader
GPU-hyror tär på företagsbudgetar. Kvantisering av modeller minskar minnesavtrycket. Mindre modeller ersätter massiva grundsystem. Effektiv batchbearbetning maximerar hårdvaruutnyttjandet.
- Kvantisering av modeller halverar filstorlekarna utan att kvaliteten försämras.
- Spot-GPU-instanser sänker betydligt kostnaderna för molnberäkningshyra.
- Batchbearbetning av förfrågningar maximerar utnyttjandet av den aktiva hårdvarukapaciteten.
Säkerhets- och efterlevnadsrisker
Dataläckor utlöser regulatoriska böter. Krypteringsprotokoll skyddar lagrade filer. Åtkomstkontrollistor begränsar användarbehörigheter. Regelbundna granskningar verifierar systemets integritet.
- Krypteringsstandarder skyddar filer under interna nätverksöverföringar.
- Rollbaserad åtkomst begränsar synligheten av känsliga dokument mellan avdelningar.
- Efterlevnadsgranskningar verifierar att branschens regelverk följs.
- Penetrationstester avslöjar dolda säkerhetsbrister i applikationer.
Frågor om skalbarhet och prestanda
Hög användartrafik orsakar flaskhalsar på servrarna. Lastbalanserare fördelar inkommande förfrågningar. Cachelager lagrar resultat för vanliga sökningar. Asynkrona köer hanterar tunga arbetsbelastningar.
- Lastbalanserare förhindrar att en enskild server kraschar av överbelastning vid trafiktoppar.
- Cachning av svar levererar identiska sökresultat direkt, utan ny inferens.
Hur mycket kostar det att bygga en skräddarsydd LLM för ert företag?
Att konstruera en skräddarsydd LLM för verksamheten innebär varierande finansiella åtaganden, allt från grundläggande API-konfigurationer till resurskrävande träningspipelines. Organisationer måste räkna med kostnader för GPU-beräkningskraft, pipelines för databeredning, specialiserad ingenjörskompetens och långsiktiga underhållskostnader.
Låt oss bryta ner de faktiska finansiella variablerna och budgetuppskattningarna för att hjälpa er planera en korrekt investeringsstrategi för ert kommande AI-projekt.
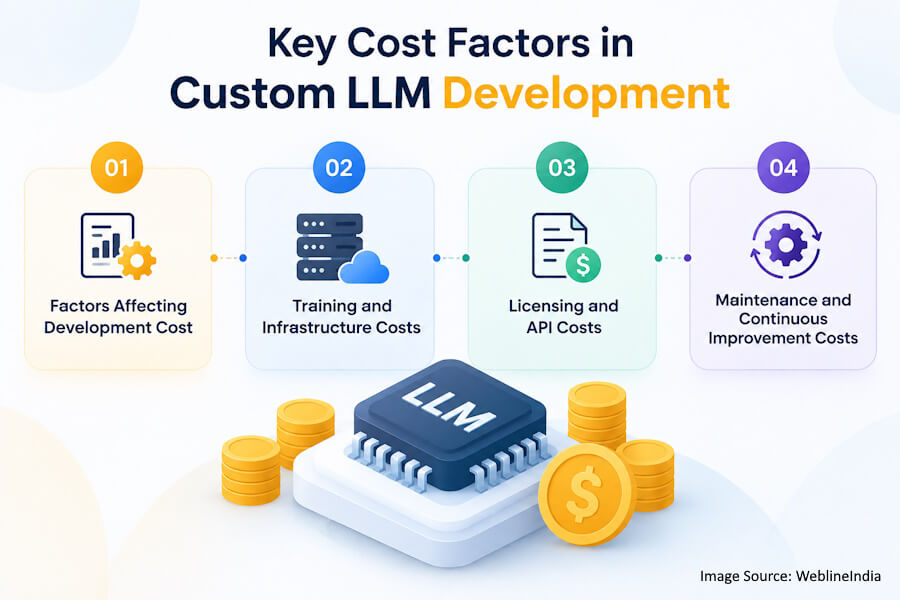
Faktorer som påverkar utvecklingskostnaden
Datamängdens storlek påverkar arbetsinsatsen för databeredning, medan modellens antal parametrar avgör hårdvarubehoven. AI-konsulttjänster kan hjälpa organisationer att bedöma integrationskomplexitet, infrastrukturkrav och andra faktorer som påverkar projektets omfattning.
- Stora datamängder kräver omfattande manuell rensningstid från ingenjörer.
- Modeller med många parametrar kräver dyr hårdvara av toppklass för GPU.
Kostnader för träning och infrastruktur
Beräkningskluster kräver betydande finansiering. Elräkningar innebär löpande driftskostnader. Molnleverantörer tar betalt per GPU-timme. Hårdvaruinköp kräver kapital i förskott.
- Timhyror för moln-GPU ackumuleras snabbt under träningskörningar.
- Ström- och kylkostnader ökar anläggningsbudgetarna för servrarna.
- Att sätta upp ett kluster kräver dyr höghastighetsutrustning för nätverk.
- Underhållsavtal täcker oväntade hårdvarufel i serverkomponenter.
Kostnader för licensiering och API
Proprietära grundmodeller tar ut prenumerationsavgifter. Tillstånd för kommersiellt bruk medför extra kostnader. Vikter med öppen källkod eliminerar återkommande licensavgifter. Juridiska granskningar säkerställer efterlevnad.
- Kommersiella API-tokens ackumulerar månatliga kostnader baserat på volym.
- Prenumerationer på proprietära modeller skalar med antalet aktiva användare.
- Vikter med öppen källkod undviker återkommande licensavgifter för mjukvara.
Kostnader för underhåll och kontinuerlig förbättring
Modeller kräver löpande omträningscykler. Ingenjörsteam åtgärdar operativa buggar. Säkerhetsuppdateringar skyddar infrastrukturens servrar. Övervakningsverktyg medför prenumerationsavgifter.
- Omträningspipelines tar regelbundet emot nyligen uppdaterade företagsdokument.
- Supportingenjörer felsöker oväntade produktionsfellogg dagligen.
- Säkerhetsteam installerar mjukvaruuppdateringar på företagets servrar.
- Observerbarhetsverktyg tar betalt baserat på volymen av loggdata.
Få en realistisk kostnadsuppskattning för en skräddarsydd LLM baserad på ert användningsfall, er data, val av modell, integrationer, infrastruktur och driftsättningskrav.
Bästa praxis för att bygga säkra, korrekta och skalbara LLM:er för verksamheten
Att implementera robusta LLM:er för verksamheten kräver strikt datakryptering, uppbyggnad av kontinuerliga feedbackloopar för att minimera hallucinationer och design av horisontellt skalbara arkitekturer för att hantera belastningstoppar.
Låt oss utforska de centrala driftsättningsstrategierna som säkerställer att ert AI-ekosystem förblir skyddat, mycket precist och obegränsat anpassningsbart för organisationens framtida tillväxt.
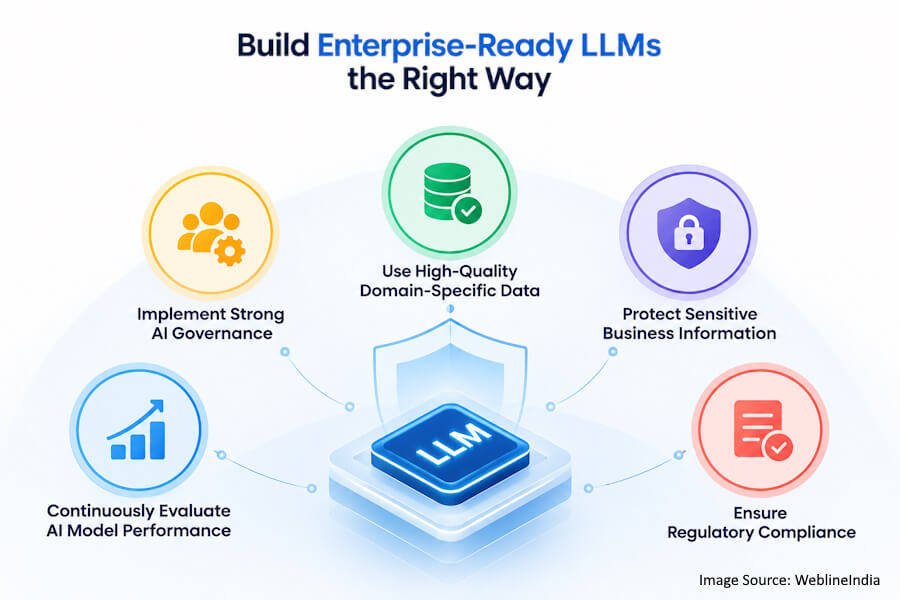
Implementera en stark AI-styrning
Kommittéer övervakar AI-projekt. Etiska riktlinjer förhindrar partiska resultat. Versionshantering följer modelluppdateringar. Dokumentation registrerar arkitektoniska beslut.
Använd domänspecifik data av hög kvalitet
Kurerade datamängder förbättrar resultatens noggrannhet. Brusreducering eliminerar förvirrande text. Standardiserade format effektiviserar träningspipelines. Regelbundna granskningar upprätthåller datans hälsa.
- Kurerade datamängder ger tydliga semantiska inlärningssignaler för modellerna.
- Brusreducering filtrerar bort irrelevant text från internet helt och hållet.
- Standardiserade scheman organiserar företagsdokument från flera källor på rätt sätt.
Skydda känslig företagsinformation
Datamaskering döljer konfidentiella siffror. Lokala servrar isolerar proprietära filer. Policyer om noll datalagring skyddar användarnas integritet. Nätverksbrandväggar blockerar externa hot.
- Datamaskering ersätter riktiga namn med säkra platshållare.
- Lokala serverdriftsättningar isolerar filer från publika nätverk.
- Avtal om noll datalagring skyddar strikt integriteten kring företagets prompter.
- Nätverksbrandväggar blockerar obehöriga externa intrångsförsök.
Utvärdera AI-modellens prestanda kontinuerligt
Automatiserade benchmarks mäter trender i noggrannhet. Användarfeedback flaggar operativa problem. Red teaming avslöjar dolda sårbarheter. Regelbundna granskningar uppdaterar prestandamålen.
- Automatiserade testskript följer trender för noggrannhetsmått över tid.
- Betygsättningsknappar för användare fångar direkt upp feedback om verklig prestanda.
Säkerställ regelefterlevnad
Juridiska team granskar hur data hanteras. GDPR-riktlinjer skyddar kundernas integritet. Branschstandarder styr säkerhetskontroller. Dokumentation styrker regelefterlevnaden.
- Juridiska granskningar säkerställer efterlevnad av strikta dataskyddslagar.
- GDPR-protokoll hanterar användarnas samtycke och begäran om radering av data.
- Branschstandarder föreskriver specifika krav på krypteringsnyckelns styrka.
Verkliga affärsanvändningsfall för skräddarsydd LLM-utveckling inom olika branscher
Skräddarsydda LLM:er förändrar branscher genom att automatisera komplex analys av juridiska dokument inom finans, driva hyperpersonliga diagnostiska förslag inom vården och styra mycket målinriktad lagerlogistik inom detaljhandeln. Upptäck hur organisationer inom olika sektorer använder dessa skräddarsydda system för att effektivisera arbetsflöden, drastiskt sänka overheadkostnader och säkra en betydande konkurrensfördel.
Sjukvård
Kliniska modeller sammanfattar patienthistorik. Medicinska forskare analyserar studier av läkemedelsinteraktioner. Diagnostiska assistenter bearbetar anteckningar från skanningar. Administrativa arbetsflöden påskyndar faktureringen.
- Kliniska modeller sammanfattar omfattande medicinsk patienthistorik åt läkare.
- Forskningsverktyg analyserar snabbt komplexa studier av läkemedelsinteraktioner.
Bank och finansiella tjänster
Algoritmer för bedrägeriupptäckt analyserar transaktionsströmmar. Algoritmiska handlare bearbetar marknadsrapporter. Compliance-system granskar låneansökningar. Automatiserade agenter besvarar frågor om konton.
- Algoritmer för bedrägeriupptäckt flaggar misstänkta transaktionsströmmar direkt.
- Finansiella modeller analyserar resultatrapporter åt investerare i verksamheten.
- Compliance-verktyg granskar noggrant riskfaktorer i låneansökningar.
- Automatiserade assistenter besvarar rutinmässiga kontofrågor från kunder dygnet runt.
Juridik
Kontraktsanalysatorer upptäcker ofördelaktiga klausuler. Sökmotorer för rättspraxis hämtar prejudikat. Dokumentsammanfattare granskar vittnesmål. Due diligence-pipelines bearbetar sammanslagningar.
- Kontraktsanalysatorer markerar direkt ofördelaktiga ansvarsklausuler.
- Juridiska sökmotorer hämtar relevanta historiska rättsfallsprejudikat.
Tillverkning
Modeller för leveranskedjan förutspår materialbrist. Underhållsloggar schemalägger maskinreparationer. Kvalitetskontrollsystem analyserar felrapporter. Designassistenter granskar ritningar.
- Modeller för leveranskedjan förutspår tidigt risker för brist på råmaterial.
- Underhållsloggar schemalägger proaktiva maskinreparationer i fabriken.
- Kvalitetskontrollsystem analyserar felrapporter från monteringen.
- Designassistenter granskar komplexa tekniska ingenjörsritningar.
Detaljhandel och e-handel
Rekommendationsmotorer föreslår relevanta produkter. Lagermodeller prognostiserar säsongsbetonad efterfrågan. Flerspråkiga chattbotar hjälper köpare över hela världen. Sentimentanalysatorer granskar feedback.
- Rekommendationsmotorer föreslår relevanta produkter till kunder på nätet.
- Lagermodeller prognostiserar säsongsbetonad lagerefterfrågan med god precision.
Kundsupport
Ärendesystem dirigerar frågor automatiskt. Sentimentspårare prioriterar arga uppringare. Kunskapsbaser genererar omedelbara svar. Svarsassistenter formulerar artiga svar.
- Ärendesystem dirigerar kundfrågor till lämpliga agenter.
- Sentimentspårare prioriterar supportköer med arga uppringare.
- Kunskapsbaser genererar omedelbara svar åt användare.
- Svarsassistenter formulerar artiga e-postsvar till kunder.
Hur man väljer rätt utvecklingsföretag för skräddarsydda LLM:er för ert företag
Att utvärdera potentiella partners för utveckling av skräddarsydda LLM:er kräver en analys av deras portfölj av driftsatta företagsmodeller, tekniska expertis inom ramverk för finjustering, dataskyddsprotokoll och kapacitet för underhåll efter lansering.
Här går vi igenom de kritiska utvärderingskriterierna som behövs för att välja en pålitlig teknikleverantör som framgångsrikt kan omvandla er ambitiösa AI-vision till en säker, produktionsfärdig verklighet för verksamheten.
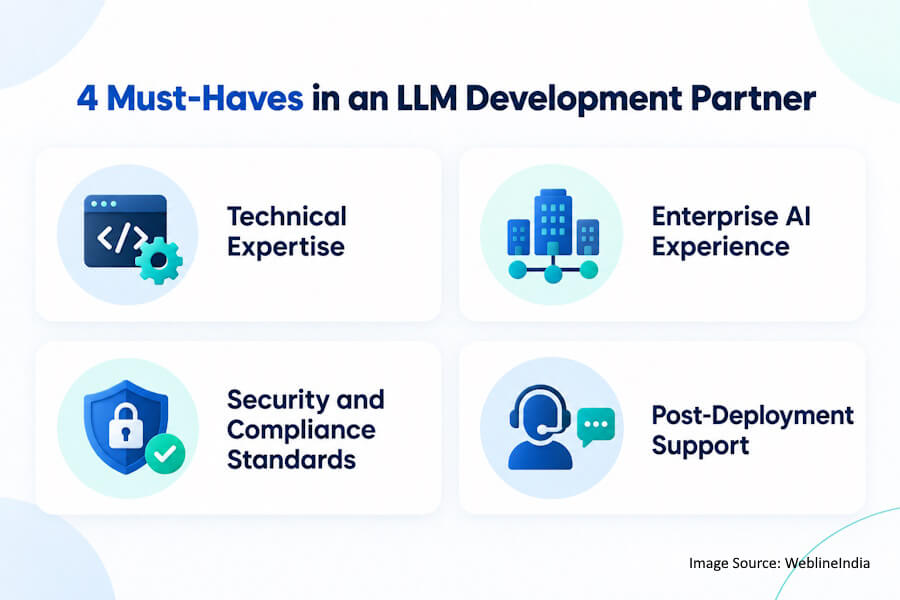
Teknisk expertis
Ingenjörer utvärderar meriter inom djupinlärning. Team demonstrerar framgångsrika modelldriftsättningar. Certifieringar bevisar kompetens inom molninfrastruktur. Portföljer belyser komplexa lösningar för verksamheten.
Erfarenhet av AI för verksamheten
Leverantörer förstår företagets säkerhetskrav. Fallstudier bevisar branschspecifik kunskap. Kundreferenser bekräftar tidigare resultat. Skalbarheten matchar verksamhetens behov.
- Leverantörer förstår strikta krav på säkerhetsefterlevnad i verksamheten.
- Fallstudier bevisar djup, branschspecifik operativ kunskap.
Säkerhets- och efterlevnadsstandarder
Partners upprätthåller strikta regler för dataintegritet. Certifieringar verifierar infrastrukturens säkerhet. Juridiska avtal skyddar immateriella rättigheter. Granskningsspår säkerställer regelefterlevnad.
- Utvecklingspartners upprätthåller strikta interna regler för dataintegritet.
- Säkerhetscertifieringar verifierar ett robust skydd av molninfrastrukturen.
- Juridiska avtal skyddar företagets proprietära immateriella rättigheter.
- Granskningsspår säkerställer full efterlevnad av branschens regelverk.
Support efter driftsättning
Underhållsavtal säkerställer systemets drifttid. Övervakningstjänster följer prestandamått. Regelbundna uppdateringar håller modellerna aktuella. Dedikerade supportteam löser buggar.
- Underhållsavtal garanterar hög drifttid för applikationssystemet.
- Övervakningstjänster följer prestandans noggrannhetsmått i realtid.
Framtida trender inom skräddarsydd LLM-utveckling och AI för verksamheten
Landskapet för AI i verksamheten förskjuts snabbt mot mycket effektiv edge-beräkning, multimodala förmågor och autonoma agentbaserade arbetsflöden som utför komplexa affärsprocesser i flera steg utan mänsklig inblandning.
Nu avslöjar vi de kommande tekniska genombrotten och strategiska innovationerna som kommer att omdefiniera hur er verksamhet utnyttjar skräddarsydda stora språkmodeller under de kommande åren.
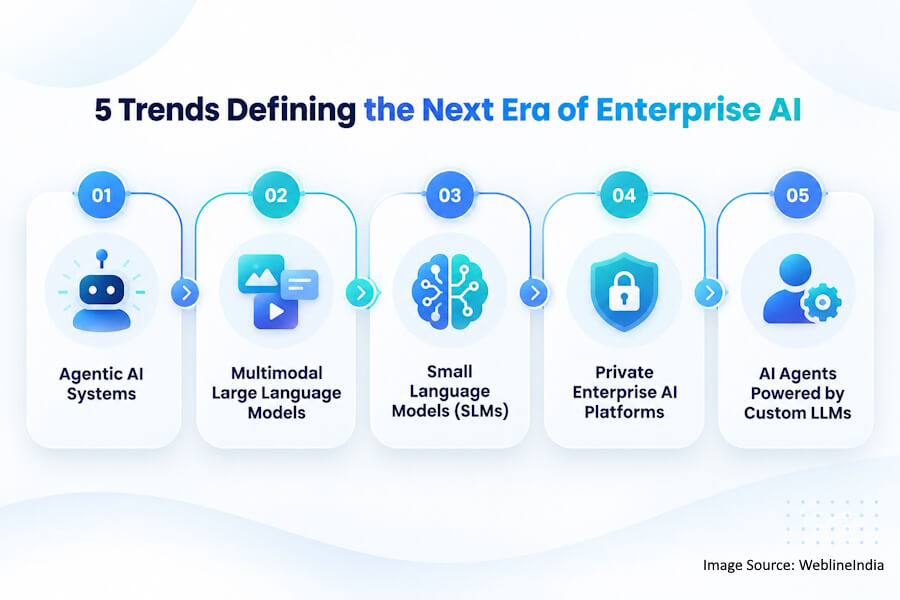
Agentbaserade AI-system
Autonoma agenter utför arbetsflöden i flera steg. System samarbetar för att lösa problem. Beslutsmotorer hanterar komplexa uppgifter. Produktiviteten ökar inom alla avdelningar.
Multimodala stora språkmodeller
Modeller bearbetar text, ljud och video. Integrerade sensorer analyserar fysiska miljöer. Rika indata förbättrar den kontextuella förståelsen. Tillämpningarna spänner över flera olika typer av sinnesdata.
- Modeller bearbetar text-, ljud- och videoströmmar samtidigt.
- Integrerade sensorer analyserar fysiska arbetsmiljöer i fabriker.
- Rika inflöden av data förbättrar den djupa kontextuella förståelsen.
- Tillämpningarna spänner sömlöst över flera typer av sinnesdata.
Små språkmodeller (SLM:er)
Kompakta modeller körs på edge-enheter. Lokal hårdvara bearbetar förfrågningar direkt. Resursbehoven minskar avsevärt. Integriteten förbättras genom lokal körning.
- Kompakta modeller körs lokalt på edge-enheter.
- Lokal hårdvara bearbetar användarnas förfrågningar direkt.
Privata AI-plattformar för verksamheten
Säkra plattformar samlar AI-verktyg på ett ställe. Interna marknadsplatser delar tränade modeller. Styrningsdashboards övervakar systemanvändningen. Verksamheter styr själva över sin AI-utveckling.
- Säkra plattformar samlar företagets AI-verktyg på ett ställe.
- Interna marknadsplatser delar skräddarsydda tränade modellvikter.
- Styrningsdashboards övervakar systemanvändningen i hela företaget.
- Verksamheter kontrollerar sin AI-infrastruktur fullt ut.
AI-agenter drivna av skräddarsydda LLM:er
Utveckling av AI-agenter för verksamheten kan kombinera specialiserade agenter med skräddarsydda LLM:er för att utföra affärsverksamhet och samordna mjukvaruflöden. Smarta assistenter hanterar det dagliga schemat. Effektivitetsvinster omvandlar arbetsflödena i hela verksamheten.
- Specialiserade agenter utför komplexa affärsuppgifter automatiskt.
- Automatiserade verktyg samordnar driftsättningspipelines för mjukvaruutveckling.
Avslutande tankar om att bygga en skräddarsydd LLM för långsiktig affärsframgång
Hur AI tas i bruk avgör vilka som blir framtidens marknadsledare. Generiska publika verktyg räcker inte till för verksamhetens krav. Organisationer bygger skräddarsydda modeller för att skydda sin data. Proprietära arbetsflöden kräver specialiserad intelligens. Långsiktig framgång kräver en robust AI-infrastruktur. Företag samarbetar med erfarna leverantörer för att påskynda genomförandet.
WeblineIndia levererar förstklassiga tjänster för skräddarsydd LLM-utveckling. Ingenjörsteam bygger säkra LLM:er för verksamheten. Specialister finjusterar modeller för maximal noggrannhet. WeblineIndia omvandlar affärsverksamheten genom skräddarsydda AI-lösningar. Organisationer uppnår varaktiga konkurrensfördelar redan idag. Kontakta WeblineIndia för att påbörja er skräddarsydda AI-integration.
Sociala hashtags
#SkräddarsyddLLM #StoraSpråkmodeller #FöretagsAI #GenerativAI #ArtificiellIntelligens #LLM #AIUtveckling #AIEngineering #AgentbaseradAI #AIAgenter #RAG #Maskininlärning #AIInfrastruktur #DigitalTransformation #Företagsteknik #MLOps #AIInnovation #PrivatAI #Affärsautomatisering
Bygg en säker, skalbar skräddarsydd LLM anpassad efter er företagsdata och era arbetsflöden tillsammans med ett erfaret AI-utvecklingsteam.
Vanliga frågor
Hur skapar jag en skräddarsydd LLM för mitt företag?
Företag samlar in egenutvecklad data, väljer kraftfulla arkitekturer med öppen källkod, finjusterar modellvikter på säkra servrar och implementerar skalbar infrastruktur för att automatisera interna arbetsflöden och skydda känsliga immateriella tillgångar.
Bör jag bygga en egen LLM eller finjustera en befintlig?
Att finjustera befintliga grundmodeller sparar både tid och pengar samtidigt som den förtränade språkförståelsen anpassas till specifika områden. Att träna en modell från grunden är endast nödvändigt vid mycket specifika krav gällande språk eller säkerhet.
Vilken data krävs för att träna en skräddarsydd språkmodell?
Ingenjörer samlar in rena interna dokument, tekniska manualer, historiska transkriptioner och strukturerade databasposter. Teamen måste rensa bort personuppgifter och formatera texten noggrant innan den matas in i träningsprocessen.
Vad kostar utvecklingen av en skräddarsydd LLM?
Kostnaderna varierar beroende på modellens storlek (antal parametrar), hyra av hårdvara och arbetsinsatsen för dataförberedelse. GPU-kluster i molnet kräver stora investeringar, medan finjustering av befintliga adaptrar sänker den totala implementeringskostnaden.
Vilken LLM med öppen källkod är bäst för företag?
Meta Llama och Mistral AI erbjuder utmärkt prestanda och tillgång till modellvikter, vilket möjliggör säker lokal drift. Organisationer väljer specifika varianter utifrån parametrar och tillgängliga beräkningsresurser.
Hur lång tid tar det att skapa en skräddarsydd LLM?
Tidsåtgången sträcker sig från några veckor till flera månader, beroende på hur komplex datamängden är. Stegvis utrullning och användning av förtränade grundmodeller påskyndar den initiala implementeringen för företagsteam.
Kan företag skapa privata AI-modeller?
Företag driftsätter modeller på lokal serverhårdvara eller i säkra, privata molnmiljöer. Detta garanterar fullständig dataseparering och förhindrar att externa API-leverantörer får insyn i konfidentiell företagsinformation.
Vilken infrastruktur krävs för utveckling av LLM:er?
Djupinlärning kräver högpresterande GPU-kluster, robust nätverkshårdvara och snabba vektordatabaser. DevOps-ingenjörer konfigurerar skalbara Kubernetes-noder för att hantera hög belastning vid inferens.
Hur driftsätter företag skräddarsydda LLM:er?
DevOps-team sätter upp instanser för inferens i molnet eller på lokala servrar. API-gateways kopplar samman interna affärssystem, medan lastbalanserare fördelar inkommande trafik jämnt mellan servrarna.
Vilka är fördelarna med privata LLM:er?
Privata modeller garanterar strikt datasekretess, eliminerar abonnemangsavgifter per token och ger korrekta, branschspecifika svar. Organisationer behåller absolut kontroll över modellvikter och systemsäkerhetspolicyer.
Vad är RAG och hur jämförs det med finjustering?
Retrieval-Augmented Generation hämtar externa dokument dynamiskt utan att ändra kärnmodellvikter. Finjustering modifierar neurala nätverksparametrar direkt för specialiserad vokabulär och beteendeanpassning över företagets arbetsflöden.
Hur säkra är företags-LLM:er?
Företagsplattformar tillämpar strikta rollbaserade åtkomstkontroller, datakryptering i vila och nolllagringspolicyer. Säkerhetsrevisioner och lokala brandväggar skyddar konfidentiell information mot skadliga cyberhot.
Globalt erkänd för oöverträffad kvalitet och pålitlighet


Kundreferenser: Hör det direkt från våra globala kunder
Våra utvecklingsprocesser levererar dynamiska lösningar för att hantera affärsutmaningar, optimera kostnader och driva digital transformation. Lösningar med expertstöd förbättrar kundlojaliteten och den digitala närvaron, och beprövade framgångsberättelser lyfter fram verklig problemlösning genom innovativa applikationer. Våra uppskattade kunder världen över har redan upplevt det.
Priser och Erkännanden
Även om nöjda kunder är vår största motivation, har branscherkännande betydande värde. WeblineIndia har konsekvent varit ledande inom teknologi, med priser och utmärkelser som bekräftar vår excellens.
OA500 Globala outsourcingföretag 2025, av Outsource Accelerator
Ledande mjukvaruutvecklingsföretag, av GoodFirms
Bästa fintech-produktlösningsföretag – 2022, av GESIA
Utsedd till – Bästa apputvecklingsföretag i Indien 2020, av SoftwareSuggest