So entwickeln Sie ein maßgeschneidertes LLM für Ihr Unternehmen
Erfahren Sie, wie Sie ein maßgeschneidertes LLM für Ihr Unternehmen entwickeln – anhand eines Schritt-für-Schritt-Ansatzes, der Datenaufbereitung, Auswahl des Basismodells, Fine-Tuning, RAG, Infrastruktur, Bereitstellung, Sicherheit, Kosten sowie Anwendungsfälle im Unternehmenskontext abdeckt.


 ChatGPT
 Perplexity
Der Aufbau eines maßgeschneiderten LLM für Ihr Unternehmen umfasst die Identifikation konkreter Anwendungsfälle, die Aufbereitung relevanter Daten, die Auswahl der passenden Modellarchitektur sowie die Umsetzung effektiver Trainings- und Testprozesse. Ein individuell angepasstes LLM kann Automatisierung, Effizienz, Kundenerlebnisse und Entscheidungsfindung in allen Unternehmensbereichen verbessern.
Was ist ein Custom Large Language Model (LLM) und warum brauchen Unternehmen eines?
Standardmäßige Foundation-Modelle der künstlichen Intelligenz bedienen allgemeine öffentliche Anfragen. Diesen generischen Modellen fehlt der spezifische betriebliche Kontext. Organisationen kämpfen mit Genauigkeitslücken. Generische Systeme halluzinieren Unternehmensfakten. Unternehmen benötigen spezialisiertes Domänenwissen. Die Custom-LLM-Entwicklung schließt genau diese Lücke. Proprietäre Daten bleiben intern. Sicherheitsprotokolle verhindern den Abfluss von Daten nach außen. Organisationen bauen ein Enterprise-LLM auf, um sensible Dokumente zu verarbeiten.
Individuelle KI-Entwicklungsdienste zielen auf spezifische Workflows ab. Mitarbeitende laden interne technische Handbücher hoch. Das System lernt die proprietäre Terminologie sofort. Die Entwicklung großer Sprachmodelle erfordert umfangreiches Parameter-Tuning. Unternehmen wechseln von öffentlichen Tools zu einer sicheren Infrastruktur. Private LLM-Deployments garantieren Datenisolation. Finanzinstitute verarbeiten vertrauliche Unterlagen sicher. Gesundheitsdienstleister schützen Patientenakten sorgfältig.
Standardmodelle scheitern an technischen Anfragen. Die Entwicklung individueller GPT-Modelle adressiert Nischenbranchen. Organisationen nutzen die KI-Modellentwicklung, um komplexe Schreibaufgaben zu automatisieren. Enterprise-KI-Modelle verstehen interne Kennzahlen. Unternehmen setzen auf Open-Source-LLM-Lösungen, um das Eigentum am Code zu behalten. Dieser Ansatz eliminiert Abonnementgebühren von Drittanbietern. Proprietäre Gewichte bleiben auf lokalen Servern. Hohe operative Kontrolle stärkt interne Engineering-Teams. KI-Infrastruktur erfordert leistungsstarke Compute-Cluster. Ingenieure konfigurieren verteilte Verarbeitungsknoten.
Die wichtigsten Vorteile eines Custom LLM für Enterprise-Anwendungen
Der Aufbau eines individuellen Large Language Model (LLM) versetzt Organisationen in die Lage, proprietäre Daten sicher zu halten, Halluzinationen durch domänenspezifisches Fine-Tuning drastisch zu reduzieren und komplexe interne Workflows nahtlos zu automatisieren.
Sehen wir uns an, warum die Anpassung eines KI-Modells an Ihre Unternehmensdaten unvergleichliche betriebliche Effizienz und einen echten Wettbewerbsvorteil in modernen Unternehmensumgebungen ermöglicht.
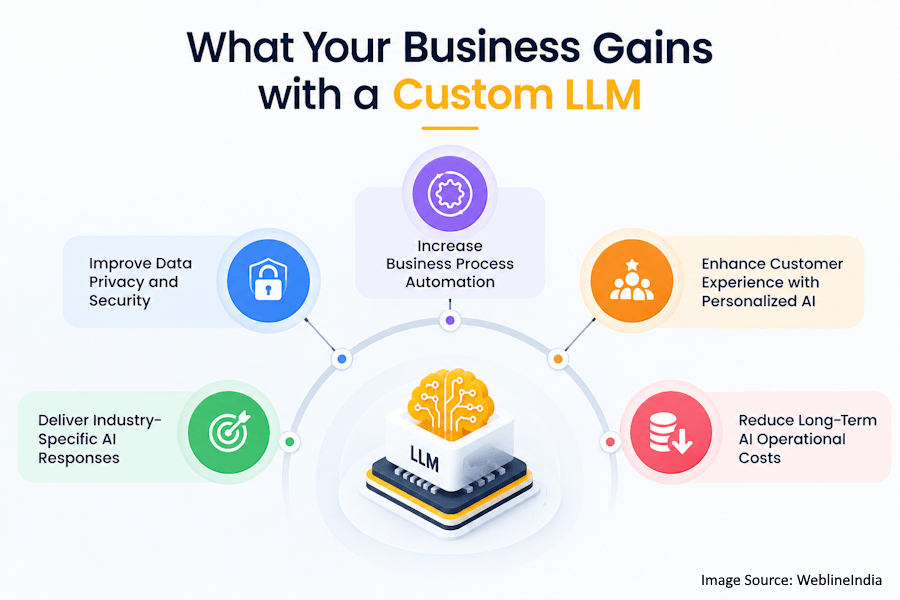
Datenschutz und Datensicherheit verbessern
Öffentliche KI-Plattformen speichern Nutzereingaben. Externe Server nehmen proprietäre Unternehmensgeheimnisse auf. Unternehmen drohen erhebliche regulatorische Strafen. Dienste zur Entwicklung individueller KI-Modelle eliminieren die Risiken der öffentlichen Cloud. Die Daten bleiben in lokalen Rechenzentren. Sicherheitsteams verschlüsseln ruhende Informationen. Mitarbeitende teilen vertrauliche Berichte sicher. Compliance-Beauftragte setzen strikte Zugriffskontrollen durch. Die Entwicklung privater LLMs schützt geistiges Eigentum.
- Unternehmensserver speichern Prompt-Protokolle lokal.
- Externe API-Anbieter sehen niemals interne Daten.
- Sicherheitsingenieure konfigurieren strikte Firewall-Regeln.
Branchenspezifische KI-Antworten liefern
Generische Modelle missverstehen technischen Fachjargon. Spezialisierte Domänen verlangen präzises Vokabular. Dienste zur Custom-LLM-Entwicklung trainieren Modelle auf Nischendatensätzen. Ingenieure nutzen das Fine-Tuning eines LLM für Geschäftsgenauigkeit. Anwaltskanzleien laden Rechtsprechungsarchive hoch. Medizinische Forschende verarbeiten Notizen aus klinischen Studien. Das System gibt die korrekte Terminologie aus.
- Rechtsdatenbanken speisen spezialisierte Trainingspipelines mit historischen Dokumenten.
- Medizinische Fachzeitschriften verbessern die Genauigkeit klinischer Anfragen für Krankenhausdiagnostik.
- Engineering-Teams integrieren Konstruktionspläne, um technische Reasoning-Engines anzuleiten.
Geschäftsprozessautomatisierung steigern
Manuelle Dokumentensortierung verschlingt Arbeitsstunden. LLMs können außerdem Dienste zur Geschäftsprozessautomatisierung ergänzen, indem sie Workflows wie Dokumentenverarbeitung, Ticket-Routing und Informationsextraktion unterstützen. Systeme leiten eingehende Support-Tickets sofort weiter. Enterprise-KI-Entwicklungsdienste können Architekturen unterstützen, die darauf ausgelegt sind, sensible Geschäftsdaten in kontrollierten Umgebungen zu halten. Algorithmen extrahieren Daten aus unstrukturierten Rechnungen. Enterprise-KI-Modelle führen mehrstufige Geschäftslogik aus.
- Die automatisierte Rechnungsverarbeitung spart Buchhaltungsabteilungen jeden Monat Hunderte manueller Arbeitsstunden.
- Support-Chatbots lösen technische Tickets sofort, indem sie auf interne Troubleshooting-Wikis zurückgreifen.
- Logistiksysteme werten Frachtmanifeste automatisch aus, um Bestandsdatenbanken zu aktualisieren.
- Dateneingabefehler gehen in allen Unternehmensabteilungen deutlich zurück.
Kundenerlebnis mit personalisierter KI verbessern
Generische Antworten frustrieren Käufer. Käufer verlangen kontextbezogene Unterstützung. Die Entwicklung von Geschäfts-KI-Modellen integriert Kundenhistoriendatenbanken. Die Plattform erinnert sich an frühere Käufe. Support-Mitarbeitende lösen Probleme schneller. Die Markentreue steigt stetig.
- Empfehlungssysteme analysieren das bisherige Kaufverhalten, um passende Artikel vorzuschlagen.
- Chatbots berücksichtigen individuelle Abonnementstufen der Kunden, um präzisen Support zur jeweiligen Kontostufe zu bieten.
Langfristige operative KI-Kosten senken
Externe API-Tokens verursachen hohe Gebühren. Hohes Datenverkehrsaufkommen im Unternehmen treibt die Monatsrechnungen in die Höhe. Unternehmen trainieren ihr eigenes Sprachmodell, um Gebühren pro Token zu umgehen. Fixe Hardwarekosten ersetzen variable API-Abrechnung. Organisationen planen ihre Budgets verlässlich.
- Fixe Infrastrukturkosten ersetzen skalierende API-Rechnungen in Zeiten hohen Datenverkehrs.
- Hohe Anfragevolumen laufen über die Zeit günstiger auf lokalen Unternehmens-GPUs.
- Interne Teams optimieren die Inferenzgeschwindigkeit eigenständig und ohne Beschränkungen durch Drittplattformen.
- Die Ressourcenzuteilung passt sich effizient exakt an Spitzen des Geschäftsbedarfs an.
Machen Sie aus Ihren Unternehmensdaten eine sichere, domänenspezifische KI-Lösung, die auf Ihre Workflows, Nutzer und Unternehmensanforderungen zugeschnitten ist.
Custom LLM vs. vortrainiertes LLM: Welches KI-Modell ist das richtige für Ihr Unternehmen?
Vortrainierte Modelle bieten sofort einsatzbereite, kosteneffiziente Fähigkeiten für allgemeine Aufgaben, während individuelle Modelle unübertroffene Sicherheit und Präzision liefern, die exakt auf Ihren branchenspezifischen Fachjargon zugeschnitten sind.
Werfen wir einen umfassenden Vergleich an, um zu klären, welcher strategische Weg am besten zu Ihren langfristigen Unternehmenszielen passt.
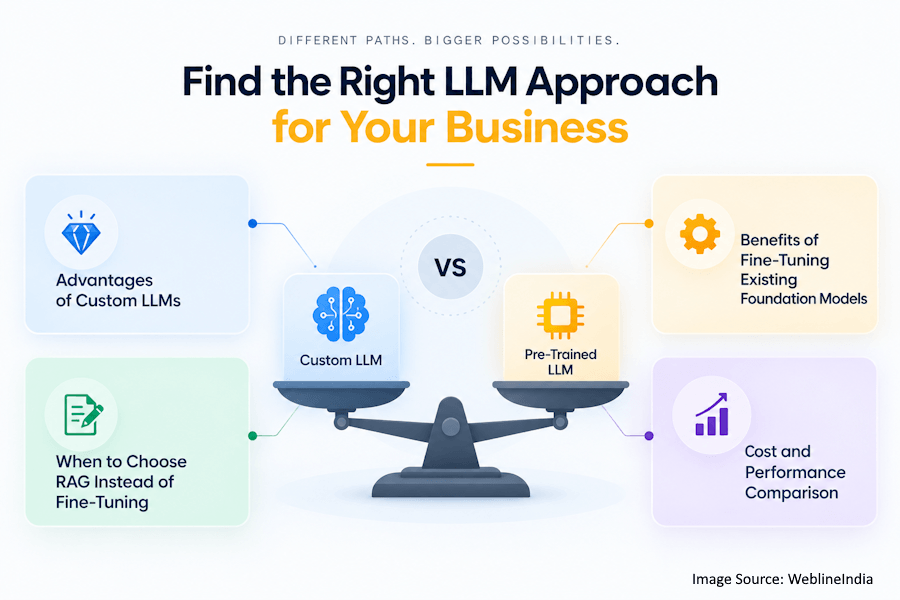
Vorteile von Custom LLMs
Organisationen besitzen ihre Modellgewichte. Ingenieure verändern die Schichten des neuronalen Netzes direkt. Custom-LLM-Entwicklung bietet unübertroffene architektonische Kontrolle. Proprietäre Algorithmen schützen Wettbewerbsvorteile. Sicherheitsrichtlinien setzen Zero-Data-Retention-Regeln durch. Die Leistung passt zu den exakten Anforderungen der Unternehmenslasten.
- Vollständiges Eigentum verhindert Vendor-Lock-in-Fallen und willkürliche Preisänderungen.
- Fine-Tuning-Parameter passen sich mit hoher Präzision an industrielle Nischendomänen an.
- Die Inferenzgeschwindigkeit wird für spezifische Hardwarekonfigurationen in lokalen Rechenzentren optimiert.
Vorteile des Fine-Tunings bestehender Foundation-Modelle
Ein Aufbau von Grund auf kostet Millionen. Dienste für das Fine-Tuning von KI-Modellen können den Bedarf an Training von Grund auf reduzieren, indem bestehende Foundation-Modelle an domänenspezifische Anforderungen angepasst werden. Bestehende Modelle liefern eine starke sprachliche Grundlage. Domänendatensätze passen die vortrainierten Gewichte an. Trainingszyklen sind innerhalb weniger Tage abgeschlossen. Ingenieure nutzen Frameworks der Open-Source-LLM-Entwicklung.
- Vortrainierte Gewichte bieten schnell eine solide Grundkompetenz ohne aufwendiges Training von Grund auf.
- Die Rechenkosten bleiben niedriger als bei vollständigen Trainingsläufen im Millionenbereich.
- Spezialisierte Datensätze lenken allgemeine Reasoning-Fähigkeiten auf konkrete Geschäftsaufgaben um.
- Entwicklungszeiträume schrumpfen von Jahren auf Wochen.
Wann RAG statt Fine-Tuning die richtige Wahl ist
Training verändert die Kerngewichte des Modells. Retrieval-Augmented Generation lässt die Gewichte unangetastet. Unternehmen aktualisieren externe Wissensdatenbanken täglich. RAG-Systeme rufen Dokumente dynamisch ab. Ingenieure wählen RAG für sich häufig ändernde Wikis. Die Entwicklungskosten bleiben minimal.
- Dynamische Dokumentenaktualisierungen erfordern keine Retraining-Zyklen oder Gewichtsaktualisierungen.
- Externe Vektordatenbanken speichern aktuelle Unternehmens-Wikis für den sofortigen Abruf.
Kosten- und Leistungsvergleich
Individuelle Architekturen erfordern massive Rechencluster. Das Fine-Tuning von Foundation-Modellen benötigt moderate GPU-Mieten. RAG-Architekturen stützen sich auf schnelle Vektorsuchen. Finanzplaner berechnen den exakten Return on Investment. Performance-Benchmarks bestimmen die Wahl der Architektur.
- Individuelles Pre-Training verursacht Rechenkosten in Millionenhöhe für reine Trainingsläufe.
- Fine-Tuning erfordert für Adapter-Gewichtsaktualisierungen nur bescheidene Cloud-GPU-Budgets.
- RAG-Implementierungen optimieren die Datenbankspeicherkosten bei gleichzeitig hoher Faktengenauigkeit.
- Latenzmetriken steuern die endgültigen Entscheidungen zum Produktiveinsatz in den verschiedenen Geschäftsbereichen.
Schritt-für-Schritt-Anleitung: So bauen Sie ein Custom LLM für Ihr Unternehmen
Der Aufbau eines Custom LLM umfasst die Definition konkreter Anwendungsfälle, das Sammeln und Bereinigen proprietärer Daten, die Auswahl des passenden Basismodells, das Fine-Tuning durch spezialisiertes Training und die gründliche Bewertung der Leistung vor dem sicheren Unternehmenseinsatz.
Sehen wir uns jede Phase im Detail an, um zu verstehen, wie dieser strukturierte Fahrplan den reibungslosen Erfolg Ihrer KI-Implementierung sicherstellt.
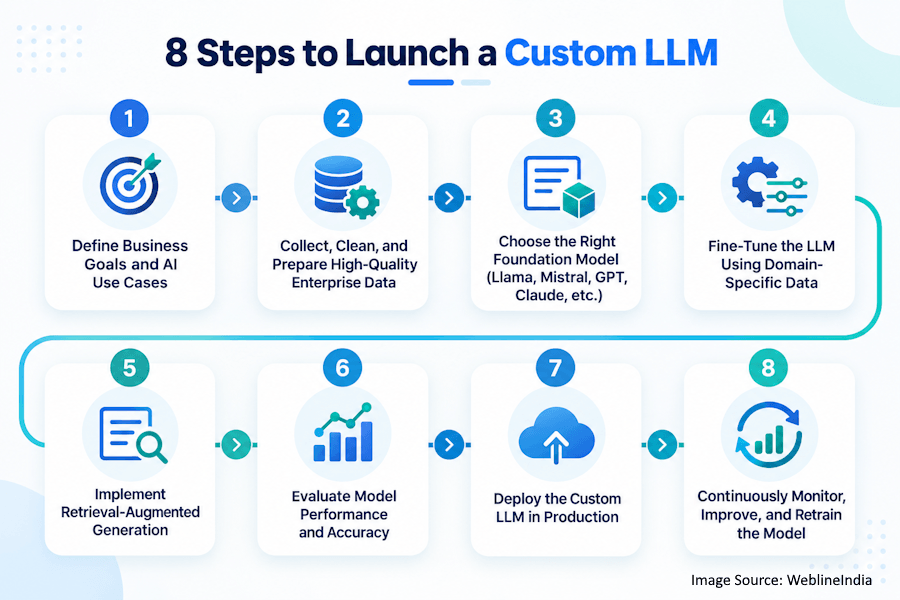
Geschäftsziele und KI-Anwendungsfälle definieren
Führungskräfte benennen exakte operative Engpässe. Ingenieure isolieren repetitive manuelle Aufgaben. Projektmanager definieren Erfolgskennzahlen. Klare Ziele verhindern verschwendete Rechenressourcen. Stakeholder prüfen Abstimmungsdokumente gründlich.
Hochwertige Unternehmensdaten sammeln, bereinigen und aufbereiten
Rohe Unternehmensdaten enthalten Formatierungsfehler. Ingenieure entfernen doppelte Datensätze konsequent. Text-Parser entfernen sensible personenbezogene Kennungen. Bereinigte Datensätze speisen die Trainingspipelines. Hohe Datenqualität sichert verlässliche Ergebnisse.
- Dateningenieure extrahieren Rohtext aus veralteten Unternehmensdatenbanken.
- Automatisierte Skripte entfernen fehlerhafte Zeichenkodierungen aus Dokumenten.
- Das Entfernen personenbezogener Daten (PII) schützt die Privatsphäre der Mitarbeitenden, bevor das Training beginnt.
- Formatierte JSON-Dateien organisieren Trainingsbeispiele sauber für die Modelle.
Das richtige Foundation-Modell wählen (Llama, Mistral, GPT, Claude usw.)
Die Modellauswahl bestimmt den weiteren Erfolg. Ingenieure testen mehrere Basisarchitekturen. Offene Gewichte bieten Freiheit beim lokalen Deployment. Proprietäre Modelle liefern starke Reasoning-Grundlagen. Lizenzvereinbarungen bestimmen die kommerziellen Nutzungsrechte.
- Benchmark-Tests bewerten die grundlegende Reasoning-Geschwindigkeit verschiedener Kandidatenmodelle.
- Lizenzbedingungen erlauben den kommerziellen Unternehmenseinsatz ohne rechtliche Risiken.
Das LLM mit domänenspezifischen Daten feinabstimmen
Spezialisierte Adapter verändern das Modellverhalten, während Dienste zur Entwicklung von Machine Learning den übergreifenden Workflow aus Training, Validierung und Modell-Engineering unterstützen können. Verlustkurven sinken im Verlauf der Epochen. Ingenieure validieren Ausgaben anhand von Testsets. Die finalen Gewichte werden in sicheren Repositories gespeichert.
- LoRA-Adapter minimieren die Anzahl aktiv trainierter Parameter beim Fine-Tuning.
- GPU-Cluster verarbeiten Terabytes an Domänentext effizient.
- Verlustmetriken verfolgen die Konvergenzraten während der Trainingsepochen des Modells.
Retrieval-Augmented Generation implementieren
Text-Splitter zerlegen lange Unternehmensberichte in Abschnitte. Embedding-Modelle wandeln Text in Vektoren um. Vektordatenbanken indizieren semantische Informationen. Suchalgorithmen rufen relevanten Dokumentkontext ab. Prompts kombinieren abgerufene Fakten mit den Anfragen.
- Text-Chunking teilt umfangreiche Handbücher effizient in kleinere Segmente.
- Embedding-Modelle übersetzen Wörter zur Indizierung in numerische Vektoren.
- Vektordatenbanken speichern mehrdimensionale semantische Indizes für schnelle Abfragen.
- Kontextinjektion verankert Modellantworten in verifizierten Fakten.
Modellleistung und Genauigkeit bewerten
Automatisierte Testskripte messen die Antwortqualität. Menschliche Prüfer bewerten subjektive Ausgaben. Benchmark-Suiten testen die Grenzen des Reasonings. Sicherheitsfilter prüfen auf Prompt-Injection-Schwachstellen. Schlechte Ergebnisse lösen sofortiges Retraining aus.
- Automatisierte Evaluierungsskripte führen Benchmark-Testsuiten gegen die Ausgaben aus.
- Fachexperten bewerten die Domänengenauigkeit manuell für die qualitative Prüfung.
Das Custom LLM in der Produktion bereitstellen
DevOps-Dienste können die Bereitstellung von Cloud-Inferenzservern, Deployment-Pipelines und skalierbaren Produktionsumgebungen für Custom LLMs unterstützen. Load Balancer verteilen den eingehenden Nutzerverkehr. API-Endpunkte verbinden interne Anwendungen. Monitoring-Tools überwachen den Systemzustand. Produktionsumgebungen gewährleisten hohe Verfügbarkeit.
- Kubernetes-Cluster skalieren Inferenzknoten bei Lastspitzen automatisch.
- API-Gateways verwalten Authentifizierungstokens der Unternehmensnutzer sicher.
- Load Balancer verteilen hohen Anfrageverkehr reibungslos auf die Server.
- Fallbacks verhindern unerwartete Systemausfälle während der Wartung.
Das Modell kontinuierlich überwachen, verbessern und neu trainieren
Nutzerfeedback zeigt betriebliche Fehler auf. Logging-Pipelines erfassen fehlerhafte Antworten. Data Scientists kuratieren neue Trainingsbeispiele. Geplantes Retraining aktualisiert die Modellgewichte. Unternehmenssysteme entwickeln sich mit den Geschäftsanforderungen weiter.
- Feedback-Schaltflächen erfassen Nutzerbewertungen unmittelbar nach der Generierung.
- Logging-Systeme markieren wiederkehrende Halluzinationen zur Überprüfung.
- Datenpipelines übernehmen aktualisierte Unternehmensrichtlinien wöchentlich.
- Geplante Retraining-Zyklen halten die Intelligenz auf dem Stand der Märkte.
Bereit, Ihre LLM-Roadmap in eine produktionsreife Lösung zu verwandeln? Unsere KI-Ingenieure helfen Ihnen beim Aufbau, Fine-Tuning, Deployment und der Skalierung.
Das beste Foundation-Modell für die Custom-LLM-Entwicklung auswählen
Die Wahl eines optimalen Foundation-Modells erfordert es, entscheidende Parameter wie Rechenaufwand, architektonische Lizenzbeschränkungen, Basisleistung in der Domäne und Latenzanforderungen der Inferenz gegen die spezifischen technischen Rahmenbedingungen Ihrer Organisation abzuwägen.
Analysieren wir, wie Sie diese architektonischen Variablen systematisch bewerten, um das Modell zu finden, das Leistungsfähigkeit und Kosteneffizienz gleichermaßen maximiert.
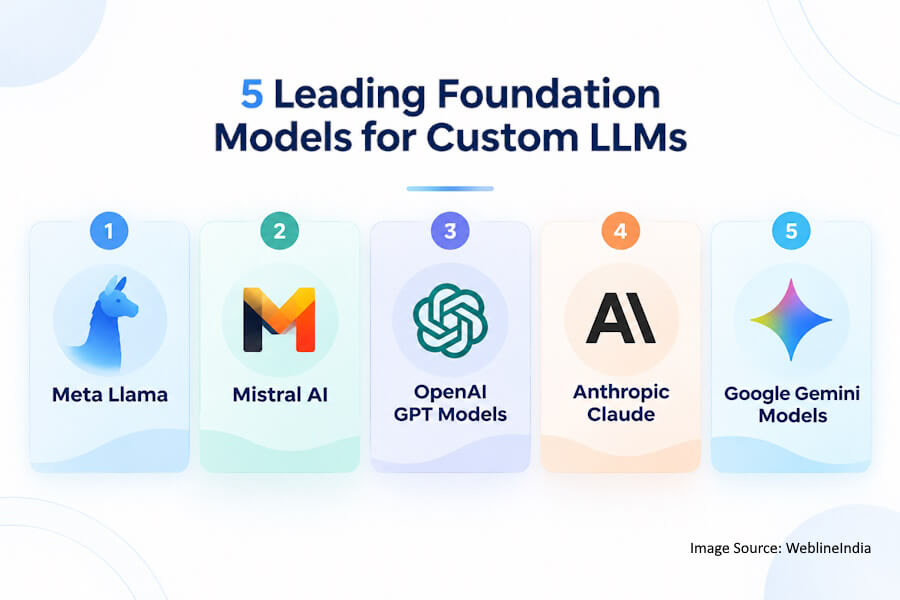
Meta Llama
Offene Gewichte begeistern Unternehmensentwickler. Lokales Deployment garantiert Datensicherheit. Das Fine-Tuning von Llama-Modellen erfordert Standardhardware. Community-Foren bieten umfangreiche Troubleshooting-Leitfäden.
- Open-Source-Gewichte erlauben ein lokales Server-Deployment hinter Firewalls.
- Die Parametergrößen reichen von kleinen bis zu massiven Unternehmenskonfigurationen.
Mistral AI
Europäische Ingenieurskunst sorgt für hohe Effizienz. Kompakte Modelle liefern schnelle Inferenzgeschwindigkeiten. Unternehmenskunden lizenzieren proprietäre Gewichtsvarianten. Architekturdesigns optimieren den Speicherverbrauch.
- Die effiziente Architektur senkt den operativen Rechenaufwand erheblich.
- Kompakte Modellgrößen beschleunigen die Antwortgenerierung für Nutzer.
- Starke Reasoning-Benchmarks stehen größeren Branchenwettbewerbern in nichts nach.
- Flexible Lizenzierung passt zu unterschiedlichen kommerziellen Geschäftsstrukturen.
OpenAI-GPT-Modelle
Proprietäre APIs bieten leistungsstarke Reasoning-Grundlagen. Entwickler müssen keine Infrastruktur-Cluster verwalten. Regelmäßige Updates bringen fortschrittliche Funktionen. Datenschutzrichtlinien schützen die Daten von Unternehmenskunden.
- Verwaltete APIs nehmen internen Teams Aufgaben der Infrastrukturwartung ab.
- Fortgeschrittenes Reasoning bewältigt komplexe Logikprobleme mühelos ohne Tuning.
Anthropic Claude
Lange Kontextfenster verarbeiten ganze Bücher. Sicherheitsleitplanken minimieren toxische Ausgaben. Unternehmenskunden integrieren sichere API-Endpunkte. Finanzanalysten werten große Tabellen direkt aus.
- Massive Kontextfenster nehmen komplette Codebasen und umfangreiche Berichte auf.
- Integrierte Constitutional-Safety-Mechanismen reduzieren schädliche oder toxische Ausgaben.
- Die Dokumentenanalyse extrahiert strukturierte Daten aus dichten Finanzseiten.
Google-Gemini-Modelle
Multimodale Fähigkeiten verarbeiten Text und Video. Die Cloud-Infrastruktur integriert native KI-Tools. Enterprise-Suchfunktionen verbinden interne Laufwerke. Skalierbare Architekturen bewältigen hohe Lasten.
- Native Multimodalität verarbeitet Bilder und Videostreams direkt.
- Die Google-Cloud-Integration vereinfacht Deployment-Pipelines im Unternehmen.
Infrastruktur und Technologie-Stack für die Custom-LLM-Entwicklung
Die Entwicklung eines robusten Custom LLM erfordert Hochleistungs-Rechencluster mit spezialisierten GPUs, skalierbare Datenpipelines, Orchestrierungs-Frameworks für Unternehmen und sichere Vektordatenbanken für Retrieval-Augmented Generation.
Betrachten wir die wesentliche technische Architektur, die Ihre Enterprise-KI-Infrastruktur wirkungsvoll antreibt.
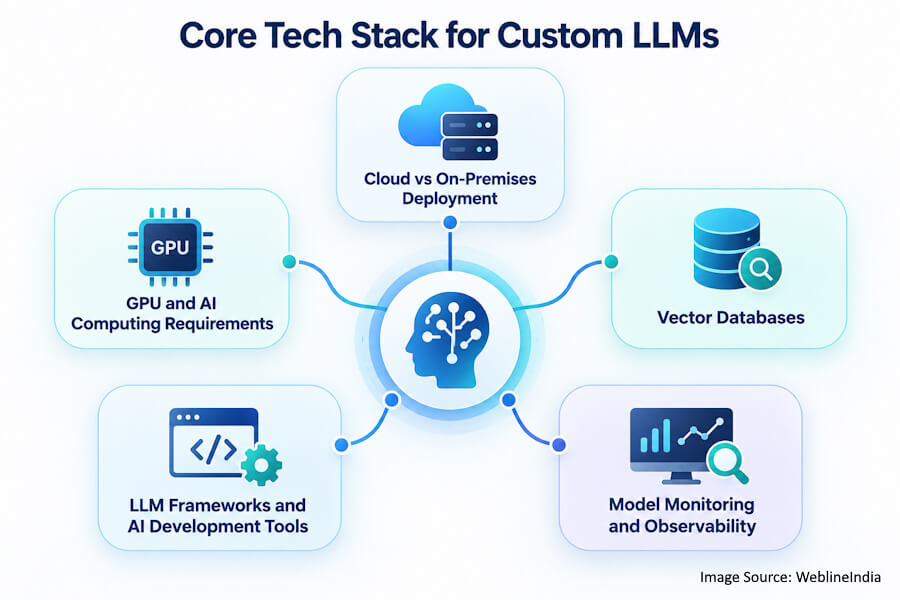
Cloud- vs. On-Premises-Deployment
Cloud-Anbieter bieten elastische GPU-Skalierung. On-Premises-Server schützen streng geheime Informationen. Finanzvorschriften legen Regeln für den Hardwarestandort fest. Hybride Architekturen balancieren Kosten und Sicherheit.
GPU- und KI-Rechenanforderungen
Deep Learning erfordert spezialisierte Beschleunigerchips. Hohe VRAM-Kapazität lädt große Modelle. Schnelle Interconnects beschleunigen verteilte Trainingsaufgaben. Der Stromverbrauch bestimmt die Budgets der Rechenzentren.
- NVIDIA-H100-Cluster verkürzen die Trainingszeiten drastisch.
- Hohe VRAM-Kapazitäten laden massive Parametergewichte sicher.
- Schnelle Interconnects verbinden mehrere Trainingsknoten ohne Latenz.
Vektordatenbanken
Embeddings erfordern spezialisierte Speicherlösungen. Ähnlichkeitssuchen rufen passende Dokumentabschnitte ab. Skalierbare Architekturen bewältigen Milliarden von Vektoren. Die Indexierungsgeschwindigkeit beeinflusst die Abfragelatenz.
- Pinecone verwaltet Cloud-native Vektorsuchindizes effizient.
- Milvus skaliert nahtlos über verteilte lokale Server-Cluster.
- Qdrant bewältigt schnelle Metadatenfilterung während der Suche.
LLM-Frameworks und KI-Entwicklungstools
Python-Bibliotheken vereinfachen den Aufbau von Pipelines. Orchestrierungstools verketten komplexe Agentenschritte. Quantisierungspakete verringern den Speicherbedarf von Modellen. Containerisierungstools standardisieren Deployment-Umgebungen.
- LangChain orchestriert komplexe mehrstufige Workflows von KI-Agenten.
- LlamaIndex verbindet externe Dokumente für RAG mit Modellen.
Modellüberwachung und Observability
Metriken erfassen den Token-Verbrauch. Fehlerprotokolle decken Fehlerstellen bei Prompts auf. Drift-Erkennung spürt nachlassende Genauigkeitstrends auf. Sicherheitsscanner blockieren bösartige Eingaben.
- Grafana-Dashboards zeigen Metriken zur Systemressourcennutzung in Echtzeit an.
- Logging-Tools erfassen Fehlerspuren von Nutzer-Prompts zur Analyse.
- Drift-Monitore warnen Ingenieure bei Leistungseinbrüchen.
- Sicherheitsfilter blockieren unautorisierte Prompt-Injection-Versuche.
Häufige Herausforderungen bei der Custom-LLM-Entwicklung und wie Sie sie meistern
Die Custom-LLM-Entwicklung bringt häufig Hürden mit sich, etwa explodierende Rechenkosten, Datenschutzrisiken, katastrophales Vergessen beim Fine-Tuning und den Umgang mit Modelldrift im Zeitverlauf.
Entdecken wir die bewährten Gegenmaßnahmen, mit denen Sie diese typischen technischen Hindernisse erfolgreich überwinden.
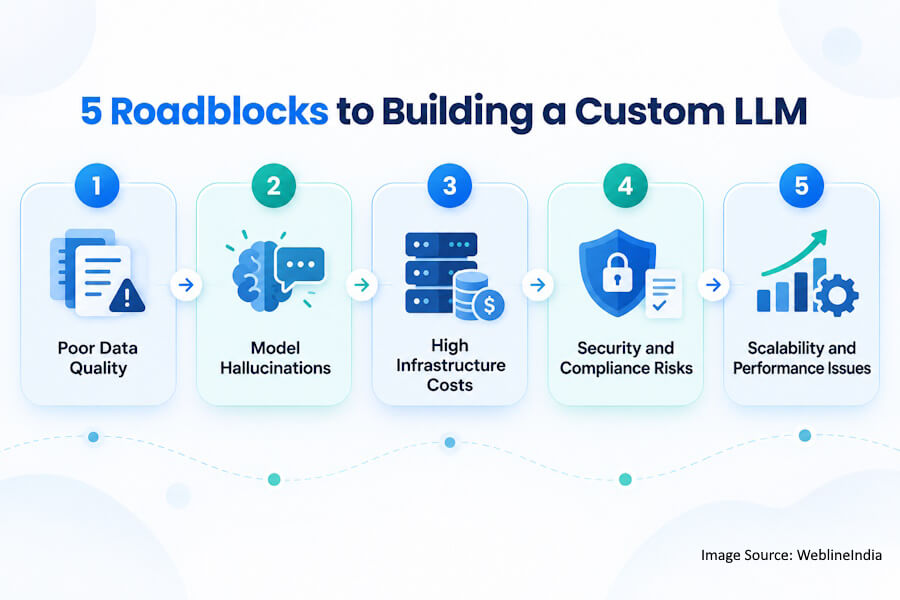
Schlechte Datenqualität
Unvollständige Dokumente führen zu unberechenbarem Modellverhalten. Datenbereinigungspipelines entfernen Rauschen. Automatisierte Validierungsskripte prüfen Textformate. Menschliche Prüfer verifizieren die Integrität der Datensätze.
- Fehlende Dokumentabschnitte erzeugen beim Training logische Lücken im Reasoning.
- Automatisierte Regex-Skripte entfernen fehlerhafte Textzeichen aus Dateien.
Modellhalluzinationen
Modelle erfinden falsche historische Fakten. RAG-Architekturen verankern Antworten in der Wahrheit. Strikte Temperatureinstellungen reduzieren kreative Erfindungen. Evaluierungssuiten fangen Fehler frühzeitig ab.
- Grounding-Prompts beschränken Antworten strikt auf die bereitgestellten Quelldokumente.
- Niedrige Temperatureinstellungen verringern die Rate zufälliger Ausgaben.
- Zitierpflichten zwingen Modelle, auf Dokumentquellen zu verweisen.
Hohe Infrastrukturkosten
GPU-Mieten belasten Unternehmensbudgets. Modellquantisierung verringert den Speicherbedarf. Kleinere Modelle ersetzen massive Foundation-Systeme. Effizientes Batching maximiert die Hardwareauslastung.
- Modellquantisierung halbiert die Dateigrößen ohne Qualitätsverlust.
- Spot-GPU-Instanzen senken die Mietkosten für Cloud-Computing erheblich.
- Request-Batching maximiert die Auslastung der aktiven Hardware-Rechenkapazität.
Sicherheits- und Compliance-Risiken
Datenlecks ziehen behördliche Bußgelder nach sich. Verschlüsselungsprotokolle sichern gespeicherte Dateien. Zugriffskontrolllisten beschränken Nutzerberechtigungen. Regelmäßige Audits überprüfen die Systemintegrität.
- Verschlüsselungsstandards schützen Dateien bei Übertragungen im internen Netzwerk.
- Rollenbasierter Zugriff begrenzt die Sichtbarkeit sensibler Dokumente über Abteilungen hinweg.
- Compliance-Audits überprüfen die Einhaltung branchenspezifischer regulatorischer Rahmenwerke.
- Penetrationstests decken verborgene Sicherheitslücken in Anwendungen auf.
Skalierbarkeits- und Performance-Probleme
Hoher Nutzerverkehr verursacht Server-Engpässe. Load Balancer verteilen die eingehende Anfragelast. Caching-Schichten speichern häufige Abfrageergebnisse. Asynchrone Warteschlangen bewältigen hohe Arbeitslasten.
- Load Balancer verhindern Abstürze durch Überlastung einzelner Server bei Verkehrsspitzen.
- Response-Caching liefert identische Anfragen sofort und ohne Inferenz.
Wie viel kostet der Aufbau eines Custom LLM für Ihr Unternehmen?
Der Aufbau eines individuellen Enterprise-LLM erfordert variable finanzielle Zusagen, die von einfachen API-Konfigurationen bis zu ressourcenintensiven Trainingspipelines reichen. Organisationen müssen GPU-Rechenaufwand, Datenaufbereitungspipelines, spezialisierte Fachkräfte und langfristige Wartungskosten einkalkulieren.
Schlüsseln wir die tatsächlichen finanziellen Variablen und Budgetschätzungen auf, damit Sie für Ihr anstehendes Enterprise-KI-Projekt eine präzise Investitionsstrategie planen können.
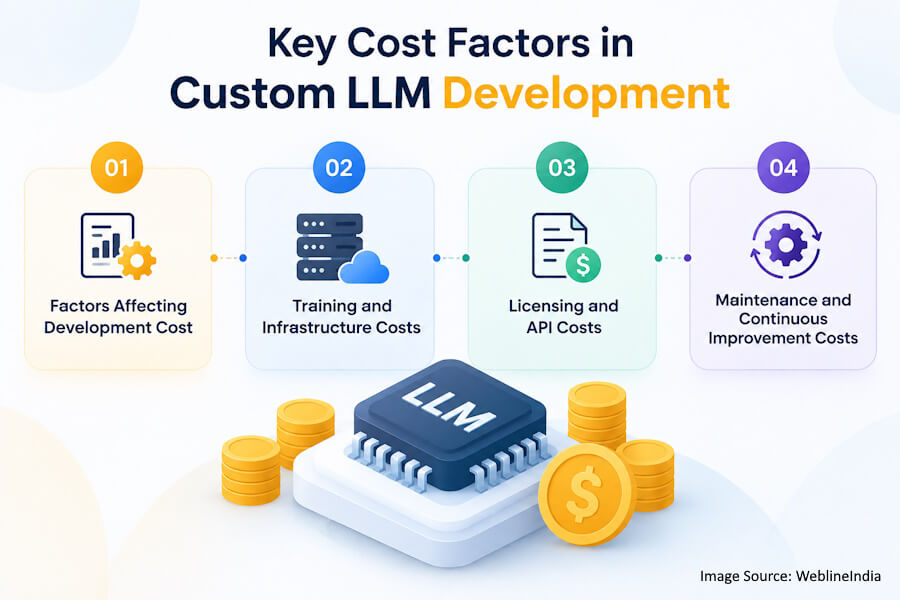
Faktoren, die die Entwicklungskosten beeinflussen
Die Datensatzgröße beeinflusst den Arbeitsaufwand bei der Datenaufbereitung, während die Anzahl der Modellparameter den Hardwarebedarf bestimmt. KI-Beratungsdienste können Organisationen dabei helfen, die Integrationskomplexität, Infrastrukturanforderungen und weitere Faktoren zu bewerten, die den Projektumfang beeinflussen.
- Große Datensätze erfordern umfangreiche manuelle Bereinigungszeit durch Ingenieure.
- Modelle mit vielen Parametern erfordern teure High-End-GPU-Hardware.
Trainings- und Infrastrukturkosten
Rechencluster erfordern erhebliche Finanzmittel. Stromrechnungen verursachen laufende Betriebskosten. Cloud-Anbieter berechnen stündliche GPU-Tarife. Hardwarekäufe erfordern Kapital im Voraus.
- Stündliche Cloud-GPU-Mieten summieren sich während der Trainingsläufe rasch.
- Strom- und Kühlungsaufwand erhöhen die Anlagenbudgets für Server.
- Die Cluster-Einrichtung erfordert teure Hochgeschwindigkeits-Netzwerkhardware.
- Wartungsverträge decken unerwartete Ausfälle von Serverkomponenten ab.
Lizenz- und API-Kosten
Proprietäre Foundation-Modelle erheben Abonnementgebühren. Genehmigungen für die kommerzielle Nutzung verursachen zusätzliche Kosten. Open-Source-Gewichte eliminieren wiederkehrende Lizenzkosten. Rechtsprüfungen stellen die Compliance sicher.
- Kommerzielle API-Tokens verursachen monatliche Kosten je nach Volumen.
- Abonnements für proprietäre Modelle skalieren mit der Zahl aktiver Nutzer.
- Open-Source-Gewichte vermeiden die Last wiederkehrender Softwarelizenzgebühren.
Wartungs- und Verbesserungskosten im laufenden Betrieb
Modelle erfordern fortlaufende Retraining-Zyklen. Engineering-Teams beheben betriebliche Fehler. Sicherheitspatches schützen die Infrastrukturserver. Monitoring-Tools verursachen Abonnementgebühren.
- Retraining-Pipelines übernehmen regelmäßig neu aktualisierte Unternehmensdokumente.
- Support-Ingenieure beheben täglich unerwartete Fehlerprotokolle aus der Produktion.
- Sicherheitsteams spielen Software-Patches auf Unternehmensserver ein.
- Observability-Tools berechnen Gebühren auf Basis des Log-Datenvolumens.
Erhalten Sie eine realistische Kostenschätzung für Ihr Custom LLM auf Basis Ihres Anwendungsfalls, Ihrer Daten, Modellwahl, Integrationen, Infrastruktur und Deployment-Anforderungen.
Best Practices für den Aufbau sicherer, präziser und skalierbarer Enterprise-LLMs
Die Umsetzung robuster Enterprise-LLMs erfordert strikte Datenverschlüsselung, kontinuierliche Feedback-Schleifen zur Minimierung von Halluzinationen und horizontal skalierende Architekturen, die Lastspitzen bewältigen.
Betrachten wir die zentralen Deployment-Strategien, die sicherstellen, dass Ihr KI-Ökosystem geschützt, hochpräzise und unbegrenzt anpassungsfähig für künftiges Unternehmenswachstum bleibt.
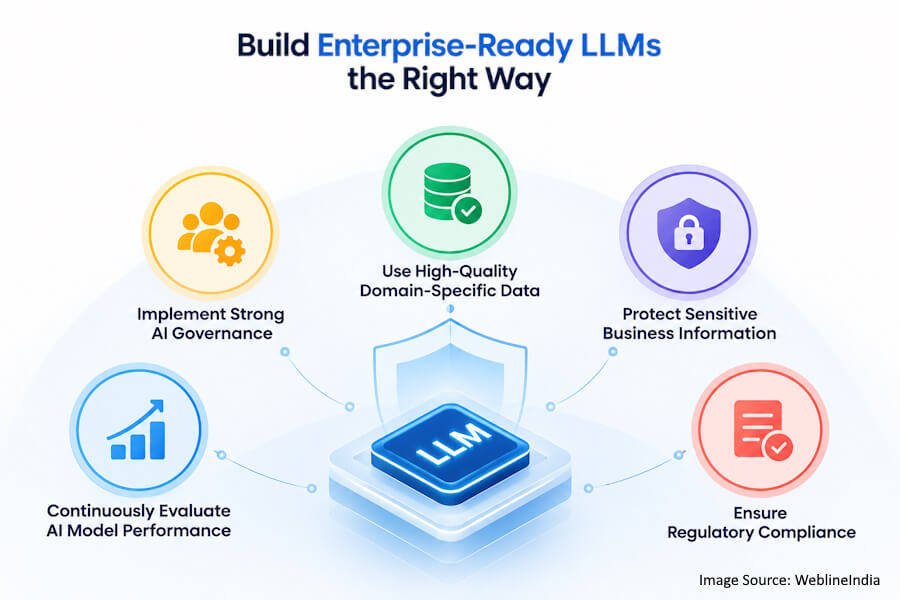
Starke KI-Governance etablieren
Gremien überwachen Projekte der künstlichen Intelligenz. Ethikrichtlinien verhindern verzerrte Ausgaben. Versionskontrolle verfolgt Modellaktualisierungen. Dokumentation hält architektonische Entscheidungen fest.
Hochwertige domänenspezifische Daten verwenden
Kuratierte Datensätze verbessern die Ausgabegenauigkeit. Rauschentfernung eliminiert verwirrenden Text. Standardisierte Formate optimieren die Trainingspipelines. Regelmäßige Audits erhalten die Datengesundheit.
- Kuratierte Datensätze liefern den Modellen klare semantische Lernsignale.
- Rauschreduzierung filtert irrelevanten Internettext vollständig heraus.
- Standardisierte Schemata organisieren Unternehmensdokumente aus mehreren Quellen sauber.
Sensible Geschäftsinformationen schützen
Datenmaskierung verbirgt vertrauliche Zahlen. Lokale Server isolieren proprietäre Dateien. Zero-Retention-Richtlinien schützen die Privatsphäre der Nutzer. Netzwerk-Firewalls blockieren externe Bedrohungen.
- Datenmaskierung ersetzt echte Namen durch sichere Platzhalter.
- Lokale Server-Deployments isolieren Dateien von öffentlichen Netzwerken.
- Zero-Data-Retention-Vereinbarungen schützen die Vertraulichkeit von Unternehmens-Prompts strikt.
- Netzwerk-Firewalls blockieren unautorisierte externe Eindringversuche.
Die Leistung des KI-Modells kontinuierlich evaluieren
Automatisierte Benchmarks messen Genauigkeitstrends. Nutzerfeedback markiert betriebliche Probleme. Red Teaming deckt verborgene Schwachstellen auf. Regelmäßige Reviews aktualisieren die Leistungsziele.
- Automatisierte Testskripte verfolgen Trends der Genauigkeitsmetriken im Zeitverlauf.
- Schaltflächen zur Nutzerbewertung erfassen praxisnahes Leistungsfeedback sofort.
Regulatorische Compliance sicherstellen
Rechtsteams prüfen die Praktiken im Umgang mit Daten. DSGVO-Richtlinien schützen die Privatsphäre der Kunden. Branchenstandards schreiben Sicherheitskontrollen vor. Dokumentation belegt die Einhaltung der Vorschriften.
- Rechtsprüfungen stellen die Einhaltung strenger Datenschutzgesetze sicher.
- DSGVO-Protokolle verwalten Nutzereinwilligungen und Löschanfragen.
- Branchenstandards schreiben bestimmte Schlüssellängen für die Verschlüsselung vor.
Praxisnahe Geschäftsanwendungen der Custom-LLM-Entwicklung in verschiedenen Branchen
Custom LLMs verändern Branchen, indem sie die komplexe Analyse juristischer Dokumente im Finanzwesen automatisieren, hochgradig personalisierte Diagnosevorschläge im Gesundheitswesen ermöglichen und hochgradig zielgerichtete Bestandslogistik im Einzelhandel vorantreiben. Entdecken Sie, wie Organisationen unterschiedlicher Sektoren diese maßgeschneiderten Systeme nutzen, um Workflows zu optimieren, Gemeinkosten drastisch zu senken und sich einen erheblichen Wettbewerbsvorteil zu sichern.
Gesundheitswesen
Klinische Modelle fassen Patientenhistorien zusammen. Medizinische Forschende analysieren Studien zu Arzneimittelwechselwirkungen. Diagnoseassistenten verarbeiten Notizen zu Bildgebungsbefunden. Administrative Workflows beschleunigen die Abrechnung.
- Klinische Modelle fassen umfangreiche medizinische Patientenhistorien für Ärztinnen und Ärzte zusammen.
- Recherchetools analysieren komplexe Studien zu Arzneimittelwechselwirkungen schnell.
Banken und Finanzdienstleistungen
Algorithmen zur Betrugserkennung analysieren Transaktionsströme. Algorithmische Händler verarbeiten Marktberichte. Compliance-Systeme prüfen Kreditanträge. Automatisierte Agenten beantworten Kontoanfragen.
- Algorithmen zur Betrugserkennung markieren verdächtige Transaktionsströme sofort.
- Finanzmodelle analysieren Ergebnisberichte für Unternehmensinvestoren.
- Compliance-Tools prüfen die Risikofaktoren von Kreditanträgen gründlich.
- Automatisierte Assistenten beantworten routinemäßige Kundenanfragen zum Konto rund um die Uhr.
Recht
Vertragsanalysatoren erkennen nachteilige Klauseln. Suchmaschinen für Rechtsprechung rufen Präzedenzfälle ab. Dokumentenzusammenfasser werten Zeugenaussagen aus. Due-Diligence-Pipelines verarbeiten Fusionen.
- Vertragsanalysatoren heben nachteilige Haftungsklauseln sofort hervor.
- Juristische Suchmaschinen rufen relevante historische Präzedenzfälle ab.
Fertigung
Lieferkettenmodelle sagen Materialengpässe voraus. Wartungsprotokolle planen Maschinenreparaturen. Qualitätskontrollsysteme analysieren Fehlerberichte. Designassistenten prüfen Konstruktionspläne.
- Lieferkettenmodelle sagen Risiken von Rohmaterialengpässen frühzeitig voraus.
- Wartungsprotokolle planen vorausschauende Reparaturen von Fabrikmaschinen.
- Qualitätskontrollsysteme analysieren Fehlerberichte aus der Montage.
- Designassistenten prüfen komplexe technische Konstruktionspläne.
Einzelhandel und E-Commerce
Empfehlungssysteme schlagen relevante Produkte vor. Bestandsmodelle prognostizieren saisonale Nachfrage. Mehrsprachige Chatbots unterstützen globale Käufer. Sentiment-Analysatoren werten Feedback aus.
- Empfehlungssysteme schlagen Online-Käufern relevante Produkte vor.
- Bestandsmodelle prognostizieren die saisonale Lagernachfrage präzise.
Kundensupport
Ticketsysteme leiten Anliegen automatisch weiter. Sentiment-Tracker priorisieren verärgerte Anrufer. Wissensdatenbanken generieren sofortige Antworten. Antwortassistenten entwerfen höfliche Rückmeldungen.
- Ticketsysteme leiten Kundenanliegen an die passenden Mitarbeitenden weiter.
- Sentiment-Tracker priorisieren Support-Warteschlangen verärgerter Anrufer.
- Wissensdatenbanken generieren sofortige Antworten für Nutzer.
- Antwortassistenten entwerfen höfliche E-Mail-Antworten an Kunden.
So wählen Sie das richtige Unternehmen für die Custom-LLM-Entwicklung aus
Die Bewertung potenzieller Partner für die Custom-LLM-Entwicklung erfordert die Analyse ihres Portfolios an produktiv eingesetzten Enterprise-Modellen, ihrer technischen Expertise mit Fine-Tuning-Frameworks, ihrer Datensicherheitsprotokolle und ihrer Wartungsmöglichkeiten nach dem Launch.
Hier gehen wir auf die entscheidenden Bewertungskriterien ein, mit denen Sie einen verlässlichen Technologieanbieter auswählen, der Ihre ehrgeizige KI-Vision erfolgreich in eine sichere, produktionsreife Unternehmensrealität verwandelt.
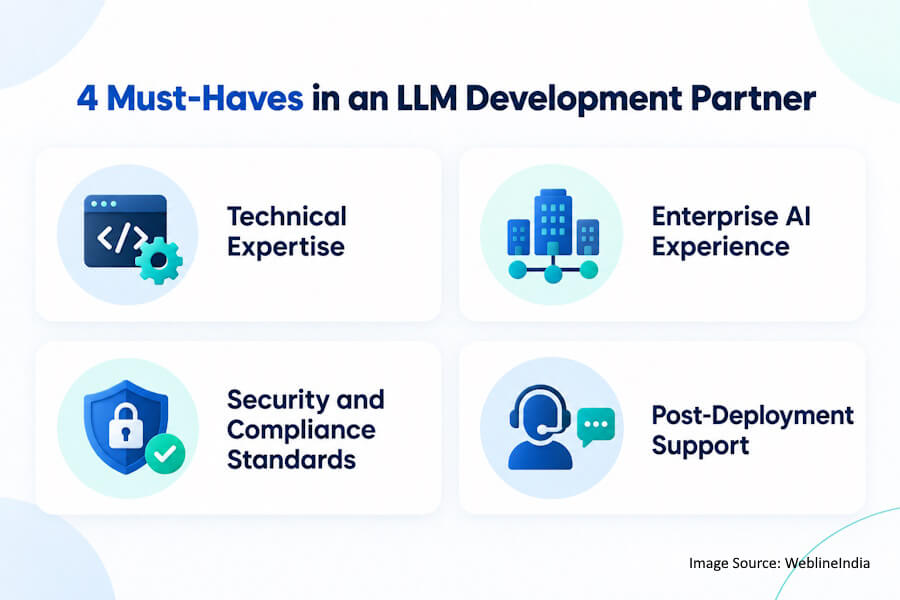
Technische Expertise
Ingenieure prüfen Qualifikationen im Deep Learning. Teams belegen erfolgreiche Modell-Deployments. Zertifizierungen belegen Kompetenz in Cloud-Infrastrukturen. Portfolios zeigen komplexe Unternehmenslösungen.
Erfahrung mit Enterprise-KI
Anbieter verstehen die Sicherheitsanforderungen von Unternehmen. Fallstudien belegen branchenspezifisches Wissen. Kundenreferenzen bestätigen frühere Leistungen. Skalierungsfähigkeiten passen zu den Geschäftsanforderungen.
- Anbieter verstehen strenge Compliance-Anforderungen an die Unternehmenssicherheit.
- Fallstudien belegen fundiertes branchenspezifisches operatives Wissen.
Sicherheits- und Compliance-Standards
Partner setzen strenge Datenschutzregeln durch. Zertifizierungen bestätigen die Sicherheit der Infrastruktur. Rechtliche Vereinbarungen schützen geistiges Eigentum. Audit-Trails gewährleisten die Einhaltung von Vorschriften.
- Entwicklungspartner setzen strenge interne Datenschutzregeln durch.
- Sicherheitszertifizierungen bestätigen den robusten Schutz der Cloud-Infrastruktur.
- Rechtsverträge schützen das proprietäre geistige Eigentum des Unternehmens.
- Audit-Trails gewährleisten die vollständige Einhaltung branchenspezifischer Vorschriften.
Support nach dem Deployment
Wartungsverträge sichern die Systemverfügbarkeit. Monitoring-Dienste verfolgen Leistungskennzahlen. Regelmäßige Updates halten Modelle aktuell. Dedizierte Support-Teams beheben Fehler.
- Wartungsvereinbarungen garantieren eine hohe Verfügbarkeit der Anwendungssysteme.
- Monitoring-Dienste verfolgen Genauigkeitskennzahlen der Live-Leistung.
Zukunftstrends in der Custom-LLM-Entwicklung und Enterprise-KI
Die Enterprise-KI-Landschaft entwickelt sich rasant in Richtung hocheffizienter Edge-Computing-Lösungen, multimodaler Fähigkeiten und autonomer agentischer Workflows, die komplexe, mehrstufige Geschäftsprozesse ohne menschliches Eingreifen ausführen.
Nun beleuchten wir die kommenden technologischen Durchbrüche und strategischen Innovationen, die neu definieren werden, wie Ihr Unternehmen in den kommenden Jahren maßgeschneiderte Large Language Models nutzt.
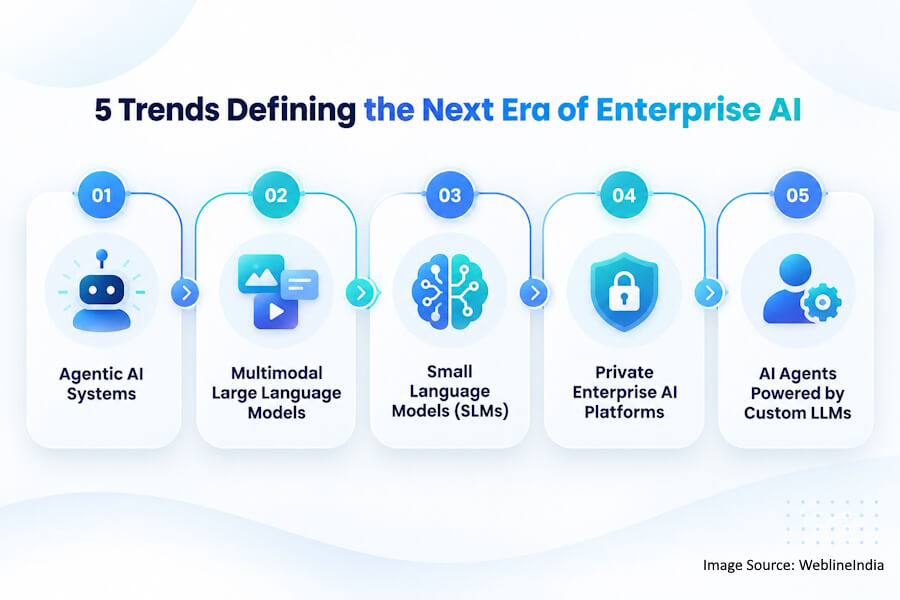
Agentische KI-Systeme
Autonome Agenten führen mehrstufige Workflows aus. Systeme arbeiten zusammen, um Probleme zu lösen. Entscheidungs-Engines steuern komplexe Aufgaben. Die Produktivität steigt in allen Abteilungen.
Multimodale Large Language Models
Modelle verarbeiten Text, Audio und Video. Integrierte Sensoren analysieren physische Umgebungen. Reichhaltige Eingaben verbessern das Kontextverständnis. Anwendungen umfassen mehrere sensorische Datentypen.
- Modelle verarbeiten Text-, Audio- und Videostreams gleichzeitig.
- Integrierte Sensoren analysieren physische Arbeitsumgebungen in Fabriken.
- Reichhaltige Eingabeströme verbessern das tiefe Kontextverständnis.
- Anwendungen umfassen nahtlos mehrere sensorische Datentypen.
Small Language Models (SLMs)
Kompakte Modelle laufen auf Edge-Geräten. Lokale Hardware verarbeitet Anfragen sofort. Der Ressourcenbedarf sinkt erheblich. Die lokale Ausführung verbessert den Datenschutz.
- Kompakte Modelle werden lokal auf Edge-Geräten ausgeführt.
- Lokale Hardware verarbeitet Nutzeranfragen sofort.
Private Enterprise-KI-Plattformen
Sichere Plattformen bündeln Tools der künstlichen Intelligenz. Interne Marktplätze teilen trainierte Modelle. Governance-Dashboards überwachen die Systemnutzung. Unternehmen behalten die Kontrolle über ihre KI-Zukunft.
- Sichere Plattformen bündeln KI-Tools des Unternehmens zentral.
- Interne Marktplätze teilen individuell trainierte Modellgewichte.
- Governance-Dashboards überwachen die unternehmensweite Systemnutzung.
- Unternehmen kontrollieren ihre KI-Infrastruktur vollständig selbst.
KI-Agenten auf Basis von Custom LLMs
Die Entwicklung von Enterprise-KI-Agenten kann spezialisierte Agenten mit Custom LLMs kombinieren, um Geschäftsabläufe auszuführen und Software-Workflows zu koordinieren. Intelligente Assistenten verwalten tägliche Terminpläne. Effizienzgewinne transformieren Unternehmens-Workflows.
- Spezialisierte Agenten führen komplexe Geschäftsabläufe automatisch aus.
- Automatisierte Tools koordinieren Deployment-Pipelines der Softwareentwicklung.
Abschließende Gedanken zum Aufbau eines Custom LLM für langfristigen Geschäftserfolg
Die Einführung künstlicher Intelligenz entscheidet über die künftigen Marktführer. Generische öffentliche Tools werden den Anforderungen von Unternehmen nicht gerecht. Organisationen bauen individuelle Modelle, um ihre Daten zu sichern. Proprietäre Workflows verlangen spezialisierte Intelligenz. Langfristiger Erfolg erfordert eine robuste KI-Infrastruktur. Unternehmen arbeiten mit erfahrenen Anbietern zusammen, um die Umsetzung zu beschleunigen.
WeblineIndia liefert herausragende Custom-LLM-Entwicklungsdienste. Engineering-Teams bauen sichere Enterprise-LLMs. Spezialisten optimieren Modelle für maximale Genauigkeit. WeblineIndia transformiert Geschäftsabläufe durch individuelle KI-Lösungen. Organisationen erzielen heute nachhaltige Wettbewerbsvorteile. Kontaktieren Sie WeblineIndia, um mit der Integration individueller künstlicher Intelligenz zu beginnen.
Social-Media-Hashtags
#CustomLLM #LargeLanguageModels #EnterpriseAI #GenerativeKI #KünstlicheIntelligenz #LLM #KI-Entwicklung #KI-Engineering #AgenticAI #KIAgenten #RetrievalAugmentedGeneration #RAG #MaschinellesLernen #KI-Infrastruktur #DigitaleTransformation #Unternehmens-IT #MLOps #KI-Innovation #PrivateAI #Geschäftsautomatisierung
Bauen Sie mit einem erfahrenen KI-Entwicklungsteam ein sicheres, skalierbares Custom LLM, das auf Ihre Unternehmensdaten und Workflows zugeschnitten ist.
Häufig gestellte Fragen
Wie erstelle ich ein maßgeschneidertes LLM für mein Unternehmen?
Unternehmen erfassen proprietäre Daten, wählen leistungsstarke Open-Source-Architekturen aus, passen Modellgewichte auf sicheren Servern an (Fine-Tuning) und implementieren skalierbare Infrastrukturen, um interne Arbeitsabläufe zu automatisieren und sensibles geistiges Eigentum zu schützen.
Sollte ich ein LLM von Grund auf neu entwickeln oder ein bestehendes anpassen?
Das Fine-Tuning bestehender Basismodelle (Foundation Models) spart Zeit und Kosten, während die vorab trainierte Sprachstruktur an spezifische Fachbereiche angepasst wird. Ein Training von Grund auf ist nur bei völlig neuartigen sprachlichen Anforderungen oder speziellen Sicherheitsvorgaben erforderlich.
Welche Daten werden für das Training eines maßgeschneiderten Sprachmodells benötigt?
Ingenieure sammeln bereinigte interne Dokumente, technische Handbücher, historische Transkripte und strukturierte Datenbankeinträge. Teams müssen personenbezogene Daten entfernen und Texte sorgfältig formatieren, bevor diese in die Trainings-Pipelines eingespeist werden.
Wie hoch sind die Kosten für die Entwicklung eines maßgeschneiderten LLM?
Die Ausgaben variieren je nach Anzahl der Parameter, Hardware-Mietkosten und dem Aufwand für die Datenaufbereitung. Cloud-GPU-Cluster erfordern hohe Investitionen, während das Fine-Tuning vorhandener Adapter das Gesamtbudget für die Implementierung senkt.
Welches Open-Source-LLM eignet sich am besten für Unternehmen?
Meta Llama und Mistral AI bieten herausragende Leistung und offene Modellgewichte für den sicheren lokalen Einsatz. Unternehmen wählen spezifische Varianten basierend auf Parametergrenzen und verfügbaren Rechenressourcen aus.
Wie lange dauert die Entwicklung eines maßgeschneiderten LLM?
Der Zeitrahmen reicht je nach Komplexität des Datensatzes von einigen Wochen bis zu mehreren Monaten. Phasenweise Rollouts und vorab trainierte Basismodelle beschleunigen die Zeitpläne für die erste Bereitstellung in Unternehmen.
Können Unternehmen private KI-Modelle erstellen?
Unternehmen betreiben Modelle auf lokaler Server-Hardware oder in sicheren Subnetzen privater Clouds. Dies gewährleistet eine vollständige Datenisolierung und verhindert, dass externe API-Anbieter Einsicht in vertrauliche Unternehmensdaten erhalten.
Welche Infrastruktur ist für die LLM-Entwicklung erforderlich?
Deep Learning erfordert leistungsstarke GPU-Cluster, robuste Netzwerkhardware und schnelle Vektordatenbanken. DevOps-Ingenieure konfigurieren skalierbare Kubernetes-Knoten, um hohe Anforderungen an das Inferenz-Datenaufkommen zu bewältigen.
Wie implementieren Unternehmen maßgeschneiderte LLMs?
DevOps-Teams stellen Cloud-Inferenz-Instanzen oder lokale Serverknoten bereit. API-Gateways verbinden interne Geschäftsanwendungen, während Load Balancer den eingehenden Anfrageverkehr effizient auf die Server verteilen.
Welche Vorteile bieten private LLMs?
Private Modelle gewährleisten strengen Datenschutz, eliminieren Abonnementgebühren pro Token und liefern präzise, branchenspezifische Antworten. Unternehmen behalten die volle Kontrolle über Modellgewichte und Sicherheitsrichtlinien des Systems.
Was ist RAG und wie unterscheidet es sich vom Fine-Tuning?
Retrieval-Augmented Generation ruft externe Live-Dokumente dynamisch ab, ohne die Gewichtungen des Kernmodells zu verändern. Beim Fine-Tuning werden die Parameter des neuronalen Netzes direkt angepasst, um das Modell auf Fachvokabular und spezifische Verhaltensweisen innerhalb von Unternehmensabläufen auszurichten.
Wie sicher sind LLMs für Unternehmen?
Unternehmensplattformen setzen strenge rollenbasierte Zugriffskontrollen, eine Verschlüsselung ruhender Daten sowie Richtlinien zum sofortigen Löschen von Daten (Zero-Retention-Policies) durch. Sicherheitsüberprüfungen und lokale Firewalls schützen vertrauliche Informationen vor Cyberbedrohungen.
Weltweit anerkannt für unübertroffene Qualität und Zuverlässigkeit


Referenzen: Hören Sie es direkt von unseren globalen Kunden
Unsere Entwicklungsprozesse liefern dynamische Lösungen, um geschäftliche Herausforderungen zu meistern, Kosten zu optimieren und die digitale Transformation voranzutreiben. Expertenunterstützte Lösungen stärken die Kundenbindung und die Online-Präsenz, während belegte Erfolgsgeschichten reale Problemlösungen durch innovative Anwendungen hervorheben. Unsere geschätzten Kunden weltweit haben es bereits erlebt.
Auszeichnungen und Anerkennungen
Zufriedene Kunden sind unsere größte Motivation, doch auch Branchenanerkennung hat einen hohen Stellenwert. WeblineIndia ist seit Jahren führend in der Technologie, und Auszeichnungen sowie Ehrungen bestätigen kontinuierlich unsere Exzellenz.
OA500 Globale Outsourcing-Unternehmen 2025, von Outsource Accelerator
Top Softwareentwicklung-Unternehmen, von GoodFirms
Bestes FinTech-Produktlösungsunternehmen – 2022, von GESIA
Ausgezeichnet als – Bestes App-Entwicklungsunternehmen in Indien 2020, von SoftwareSuggest