Cómo crear un LLM personalizado para tu negocio
Aprende a crear un LLM personalizado para tu empresa mediante un enfoque paso a paso que abarca la preparación de datos, la selección del modelo base, el ajuste fino (fine-tuning), RAG, la infraestructura, el despliegue, la seguridad, los costes y los casos de uso empresarial.


 ChatGPT
 Perplexity
Crear un LLM personalizado para su empresa implica identificar casos de uso específicos, preparar datos relevantes, seleccionar la arquitectura de modelo adecuada e implementar procesos eficaces de entrenamiento y pruebas. Un LLM a medida puede mejorar la automatización, la eficiencia, la experiencia del cliente y la toma de decisiones en todas las operaciones del negocio.
¿Qué es un modelo de lenguaje de gran tamaño (LLM) personalizado y por qué lo necesitan las empresas?
Los modelos de inteligencia artificial fundacionales estándar atienden consultas amplias del público general. Estos modelos genéricos carecen de contexto operativo específico. Las organizaciones enfrentan brechas de precisión. Los sistemas genéricos alucinan hechos corporativos. Las empresas necesitan conocimiento especializado del dominio. El desarrollo de LLM personalizados cierra precisamente esa brecha. Los datos propietarios permanecen dentro de la organización. Los protocolos de seguridad limitan la fuga de datos hacia el exterior. Las organizaciones crean un LLM empresarial para procesar documentos sensibles.
Los servicios de desarrollo de IA personalizada se enfocan en flujos de trabajo específicos. Los empleados cargan manuales técnicos internos. El sistema aprende la terminología propietaria al instante. El desarrollo de modelos de lenguaje de gran tamaño implica un intenso ajuste de parámetros. Las empresas pasan de herramientas públicas a una infraestructura segura. Las implementaciones de LLM privados garantizan el aislamiento de los datos. Las instituciones financieras procesan documentos confidenciales de forma segura. Los proveedores de salud protegen meticulosamente los historiales de sus pacientes.
Los modelos estándar fallan en consultas técnicas. El desarrollo de GPT personalizados atiende verticales de nicho. Las organizaciones utilizan el desarrollo de modelos de IA para automatizar tareas complejas de redacción. Los modelos de IA empresariales comprenden las métricas internas. Las empresas adoptan soluciones de LLM de código abierto para conservar la propiedad del código. Este enfoque elimina las tarifas de suscripción de terceros. Los pesos propietarios permanecen en servidores locales. Un alto control operativo empodera a los equipos internos de ingeniería. La infraestructura de IA exige potentes clústeres de cómputo. Los ingenieros configuran nodos de procesamiento distribuido.
Beneficios clave de crear un LLM personalizado para aplicaciones empresariales
Crear un modelo de lenguaje de gran tamaño (LLM) personalizado permite a las organizaciones proteger sus datos propietarios, reducir drásticamente las alucinaciones mediante un ajuste fino específico del dominio y automatizar sin fricciones flujos de trabajo internos complejos.
Veamos por qué adaptar un modelo de IA específicamente a los datos de su organización aporta una eficiencia operativa inigualable y una verdadera ventaja competitiva en los entornos empresariales modernos.
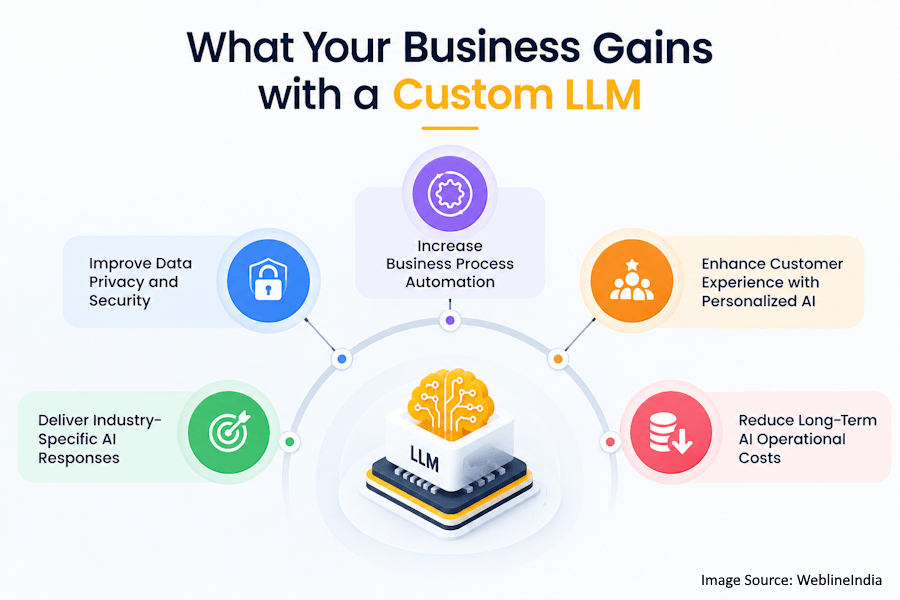
Mejorar la privacidad y la seguridad de los datos
Las plataformas públicas de inteligencia artificial almacenan lo que los usuarios introducen. Servidores externos absorben secretos corporativos propietarios. Las empresas se exponen a severas sanciones regulatorias. Los servicios de desarrollo de modelos de IA personalizados eliminan los riesgos de la nube pública. Los datos permanecen dentro de centros de datos locales. Los equipos de seguridad cifran la información en reposo. Los empleados comparten informes confidenciales de forma segura. Los oficiales de cumplimiento aplican controles de acceso estrictos. El desarrollo de LLM privados protege la propiedad intelectual.
- Los servidores corporativos almacenan localmente los registros de prompts.
- Los proveedores externos de API nunca ven datos internos.
- Los ingenieros de seguridad configuran reglas estrictas de firewall.
Ofrecer respuestas de IA específicas para cada sector
Los modelos genéricos malinterpretan la jerga técnica. Los dominios especializados exigen un vocabulario preciso. Los servicios de desarrollo de LLM personalizados entrenan modelos con conjuntos de datos de nicho. Los ingenieros aplican el ajuste fino de un LLM para lograr precisión empresarial. Los despachos jurídicos cargan archivos de jurisprudencia. Los investigadores médicos procesan notas de ensayos clínicos. El sistema produce la terminología correcta.
- Las bases de datos jurídicas alimentan canalizaciones de entrenamiento especializadas con documentos históricos.
- Las revistas médicas mejoran la precisión de las consultas clínicas para el diagnóstico hospitalario.
- Los equipos de ingeniería integran planos para guiar los motores de razonamiento técnico.
Aumentar la automatización de procesos de negocio
La clasificación manual de documentos consume horas de trabajo humano. Los LLM también pueden complementar los servicios de automatización de procesos de negocio, apoyando flujos de trabajo como el procesamiento de documentos, el enrutamiento de tickets y la extracción de información. Los sistemas enrutan al instante los tickets de soporte entrantes. Los servicios de desarrollo de IA empresarial pueden respaldar arquitecturas diseñadas para mantener los datos sensibles del negocio dentro de entornos controlados. Los algoritmos extraen datos de facturas no estructuradas. Los modelos de IA empresariales ejecutan lógica de negocio de varios pasos.
- El procesamiento automatizado de facturas ahorra a los departamentos de contabilidad cientos de horas manuales cada mes.
- Los chatbots de soporte resuelven tickets técnicos al instante consultando wikis internas de resolución de problemas.
- Los sistemas logísticos analizan automáticamente los manifiestos de envío para actualizar las bases de datos de inventario.
- Los errores de captura de datos disminuyen de forma significativa en todos los departamentos de la empresa.
Mejorar la experiencia del cliente con IA personalizada
Las respuestas genéricas frustran a los compradores. Los compradores exigen asistencia contextual. El desarrollo de modelos de IA para negocios integra bases de datos con el historial de los clientes. La plataforma recuerda las compras anteriores. Los agentes de soporte resuelven los problemas más rápido. La lealtad a la marca aumenta de manera constante.
- Los motores de recomendación analizan el comportamiento de compra previo para sugerir artículos relevantes.
- Los chatbots consultan el nivel de suscripción de cada cliente para ofrecer soporte preciso sobre su cuenta.
Reducir los costos operativos de IA a largo plazo
Los tokens de API externas acumulan tarifas elevadas. El tráfico empresarial de alto volumen incrementa las facturas mensuales. Las empresas entrenan su propio modelo de lenguaje para evitar los cargos por token. Los costos fijos de hardware sustituyen la facturación variable de las API. Las organizaciones gestionan sus presupuestos de forma predecible.
- Los costos fijos de infraestructura sustituyen las facturas de API que crecen en períodos de mucho tráfico.
- Los volúmenes altos de consultas resultan más económicos en GPU empresariales locales a lo largo del tiempo.
- Los equipos internos optimizan las velocidades de inferencia de forma independiente, sin las limitaciones de plataformas de terceros.
- La asignación de recursos se ajusta con eficiencia a los picos exactos de demanda del negocio.
Convierta los datos de su empresa en una solución de IA segura y específica de su dominio, creada en torno a sus flujos de trabajo, usuarios y requisitos empresariales.
LLM personalizado vs. LLM preentrenado: ¿qué modelo de IA es el adecuado para su empresa?
Los modelos preentrenados ofrecen capacidades inmediatas y rentables para tareas generales, mientras que los modelos personalizados brindan una seguridad y una precisión inigualables, adaptadas exactamente a la jerga particular de su sector.
Veamos una comparación completa para determinar qué camino estratégico se alinea mejor con sus objetivos empresariales a largo plazo.
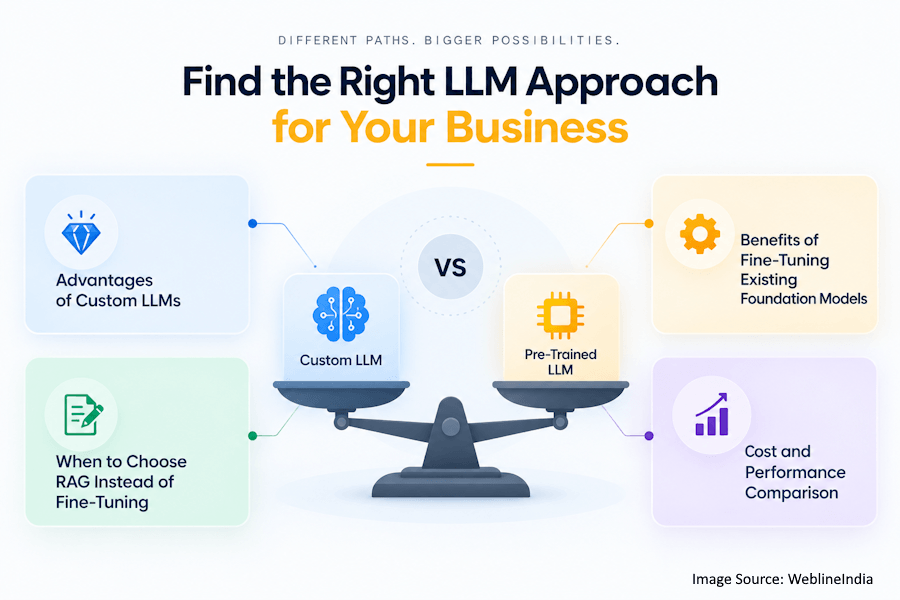
Ventajas de los LLM personalizados
Las organizaciones son dueñas de los pesos de su modelo. Los ingenieros modifican directamente las capas de la red neuronal. El desarrollo de LLM personalizados ofrece un control arquitectónico inigualable. Los algoritmos propietarios protegen las ventajas competitivas. Las políticas de seguridad aplican reglas de cero retención de datos. El rendimiento se ajusta a las cargas de trabajo exactas de la empresa.
- La propiedad total evita las trampas de la dependencia de un proveedor y los cambios arbitrarios de precios.
- Los parámetros de ajuste fino se adaptan con gran precisión a dominios industriales de nicho.
- La velocidad de inferencia se optimiza para configuraciones de hardware específicas en centros de datos locales.
Beneficios del ajuste fino de modelos fundacionales existentes
Construir desde cero cuesta millones. Los servicios de ajuste fino de modelos de IA pueden reducir la necesidad de entrenar desde cero al adaptar modelos fundacionales existentes a requisitos específicos del dominio. Los modelos existentes aportan una sólida base gramatical. Los conjuntos de datos del dominio adaptan los pesos preentrenados. Los ciclos de entrenamiento terminan en cuestión de días. Los ingenieros aprovechan marcos de desarrollo de LLM de código abierto.
- Los pesos preentrenados ofrecen rápidamente una competencia base sin un entrenamiento extenso desde cero.
- Los gastos computacionales se mantienen por debajo de los de un entrenamiento completo de varios millones de dólares.
- Los conjuntos de datos especializados reorientan las capacidades generales de razonamiento hacia tareas empresariales específicas.
- Los plazos de desarrollo se reducen de años a semanas.
Cuándo elegir RAG en lugar del ajuste fino
El entrenamiento modifica los pesos centrales del modelo. La generación aumentada por recuperación (RAG) deja los pesos intactos. Las empresas actualizan a diario las bases de conocimiento externas. Los sistemas RAG obtienen documentos de forma dinámica. Los ingenieros eligen RAG para wikis que cambian con frecuencia. Los costos de desarrollo se mantienen mínimos.
- Las actualizaciones dinámicas de documentos no requieren ciclos de reentrenamiento ni actualizaciones de pesos.
- Las bases de datos vectoriales externas almacenan wikis corporativas actualizadas para su recuperación instantánea.
Comparación de costos y rendimiento
Las arquitecturas personalizadas exigen enormes clústeres de cómputo. El ajuste fino de modelos fundacionales requiere alquileres moderados de GPU. Las arquitecturas RAG dependen de búsquedas vectoriales rápidas. Los planificadores financieros calculan el retorno de la inversión exacto. Los puntos de referencia de rendimiento determinan la elección de la arquitectura.
- El preentrenamiento personalizado genera facturas computacionales de varios millones de dólares por las ejecuciones de entrenamiento en bruto.
- El ajuste fino requiere presupuestos modestos de GPU en la nube para actualizar los pesos de los adaptadores.
- Las implementaciones RAG optimizan los costos de almacenamiento de bases de datos y mantienen una alta precisión factual.
- Las métricas de latencia orientan las decisiones finales de despliegue en producción entre las distintas unidades de negocio.
Proceso paso a paso para crear un LLM personalizado para su empresa
Crear un LLM personalizado implica definir casos de uso empresariales específicos, recopilar y depurar datos propietarios, seleccionar el modelo base adecuado, aplicar ajuste fino mediante un entrenamiento especializado y evaluar rigurosamente el rendimiento antes de un despliegue empresarial seguro.
Exploremos cada fase en detalle para ver cómo esta hoja de ruta estructurada garantiza que la implementación de su IA tenga éxito sin contratiempos.
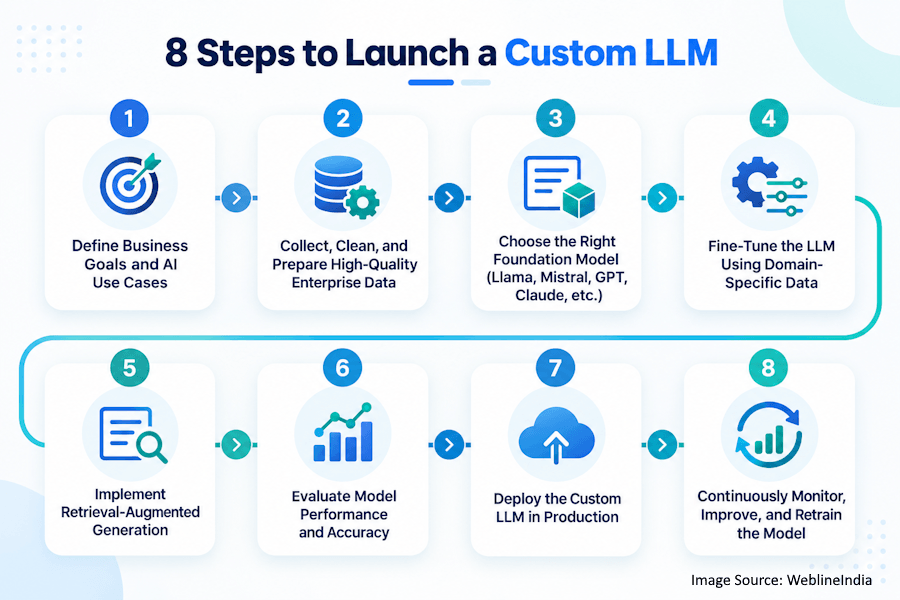
Definir los objetivos de negocio y los casos de uso de IA
Los directivos delimitan los cuellos de botella operativos exactos. Los ingenieros aíslan las tareas manuales repetitivas. Los gerentes de proyecto definen las métricas de éxito. Unos objetivos claros evitan el desperdicio de recursos de cómputo. Las partes interesadas revisan a fondo los documentos de alineación.
Recopilar, depurar y preparar datos empresariales de alta calidad
Los datos corporativos en bruto contienen errores de formato. Los ingenieros eliminan sin piedad los registros duplicados. Los analizadores de texto retiran los identificadores personales sensibles. Los conjuntos de datos limpios alimentan las canalizaciones de entrenamiento. Una alta calidad de datos garantiza resultados fiables.
- Los ingenieros de datos extraen texto en bruto de bases de datos empresariales heredadas.
- Los scripts automatizados eliminan de los documentos las codificaciones de caracteres dañadas.
- La eliminación de datos personales (PII) protege la privacidad de los empleados antes de iniciar el entrenamiento.
- Los archivos JSON con formato organizan correctamente las muestras de entrenamiento para los modelos.
Elegir el modelo fundacional adecuado (Llama, Mistral, GPT, Claude, etc.)
La selección del modelo determina el éxito posterior. Los ingenieros prueban varias arquitecturas base. Los pesos abiertos ofrecen libertad de despliegue local. Los modelos propietarios ofrecen sólidas bases de razonamiento. Los acuerdos de licencia establecen los derechos de uso comercial.
- Las pruebas de referencia evalúan las velocidades de razonamiento base de distintos modelos candidatos.
- Los términos de licencia permiten el despliegue empresarial comercial sin riesgos legales.
Aplicar ajuste fino al LLM con datos específicos del dominio
Los adaptadores especializados modifican el comportamiento del modelo, mientras que los servicios de desarrollo de aprendizaje automático pueden respaldar el flujo de trabajo más amplio de entrenamiento, validación e ingeniería del modelo. Las curvas de pérdida descienden a lo largo de las iteraciones por época. Los ingenieros validan los resultados con conjuntos de prueba. Los pesos finales se guardan en repositorios seguros.
- Los adaptadores LoRA minimizan el número de parámetros activos durante el ajuste fino.
- Los clústeres de GPU procesan con eficiencia terabytes de texto del dominio.
- Las métricas de pérdida hacen seguimiento de las tasas de convergencia durante las épocas de entrenamiento del modelo.
Implementar la generación aumentada por recuperación (RAG)
Los divisores de texto fragmentan los informes empresariales extensos. Los modelos de embeddings convierten el texto en vectores. Las bases de datos vectoriales indexan la información semántica. Los algoritmos de búsqueda recuperan el contexto relevante de los documentos. Los prompts combinan los hechos recuperados con las consultas.
- La fragmentación de texto (chunking) divide con eficiencia los manuales extensos en segmentos más pequeños.
- Los modelos de embeddings traducen las palabras a vectores numéricos para su indexación.
- Las bases de datos vectoriales almacenan índices semánticos multidimensionales para consultas rápidas.
- La inyección de contexto fundamenta las respuestas del modelo en hechos verificados.
Evaluar el rendimiento y la precisión del modelo
Los scripts de pruebas automatizadas miden la calidad de las respuestas. Los revisores humanos califican los resultados subjetivos. Los conjuntos de referencia ponen a prueba los límites del razonamiento. Los filtros de seguridad comprueban las vulnerabilidades de inyección de prompts. Las puntuaciones bajas activan un reentrenamiento inmediato.
- Los scripts de evaluación automatizados ejecutan conjuntos de pruebas de referencia sobre los resultados.
- Los expertos humanos califican manualmente la precisión del dominio en una revisión cualitativa.
Desplegar el LLM personalizado en producción
Los servicios de DevOps pueden respaldar el aprovisionamiento de servidores de inferencia en la nube, las canalizaciones de despliegue y los entornos de producción escalables para LLM personalizados. Los balanceadores de carga distribuyen el tráfico entrante de usuarios. Los endpoints de API conectan las aplicaciones internas. Las herramientas de monitoreo vigilan el estado del sistema. Los entornos de producción garantizan alta disponibilidad.
- Los clústeres de Kubernetes escalan automáticamente los nodos de inferencia durante los picos de tráfico.
- Las puertas de enlace de API gestionan de forma segura los tokens de autenticación de los usuarios empresariales.
- Los balanceadores de carga distribuyen sin problemas el tráfico intenso de solicitudes entre los servidores.
- Los mecanismos de respaldo evitan caídas inesperadas del sistema durante el mantenimiento.
Monitorear, mejorar y reentrenar el modelo de forma continua
Los comentarios de los usuarios ponen de relieve los fallos operativos. Las canalizaciones de registro capturan las respuestas incorrectas. Los científicos de datos seleccionan nuevas muestras de entrenamiento. El reentrenamiento programado actualiza los pesos del modelo. Los sistemas empresariales evolucionan con las necesidades del negocio.
- Los botones de comentarios capturan al instante las valoraciones de los usuarios tras cada generación.
- Los sistemas de registro señalan para su revisión los episodios recurrentes de alucinación.
- Las canalizaciones de datos incorporan cada semana las políticas corporativas recién actualizadas.
- Los ciclos de reentrenamiento programados mantienen la inteligencia al día con los mercados.
¿Listo para convertir su hoja de ruta de LLM en una solución lista para producción? Nuestros ingenieros de IA pueden ayudarle a crearla, ajustarla, desplegarla y escalarla.
Cómo elegir el mejor modelo fundacional para el desarrollo de un LLM personalizado
Seleccionar un modelo fundacional óptimo exige equilibrar parámetros cruciales como la carga computacional, las restricciones de licencia de la arquitectura, el rendimiento base en el dominio y los requisitos de latencia de inferencia frente a las restricciones técnicas específicas de su organización.
Analicemos cómo evaluar de forma sistemática estas variables arquitectónicas para identificar el modelo que maximiza tanto la capacidad como la rentabilidad.
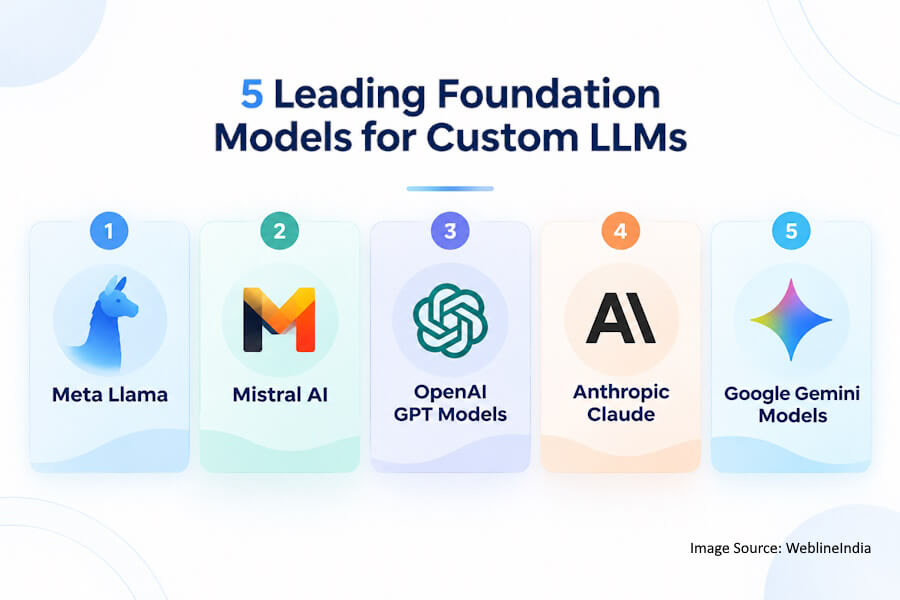
Meta Llama
Los pesos abiertos atraen a los desarrolladores empresariales. El despliegue local garantiza la seguridad de los datos. El ajuste fino de los modelos Llama requiere hardware estándar. Los foros de la comunidad ofrecen amplias guías de resolución de problemas.
- Los pesos de código abierto permiten un despliegue local en servidores detrás de firewalls.
- Los tamaños de parámetros abarcan desde configuraciones pequeñas hasta enormes configuraciones empresariales.
Mistral AI
La ingeniería europea impulsa una alta eficiencia. Los modelos compactos ofrecen velocidades de inferencia rápidas. Los clientes empresariales licencian variantes de pesos propietarios. Los diseños de arquitectura optimizan el consumo de memoria.
- Una arquitectura eficiente reduce de forma significativa la carga computacional operativa.
- Los tamaños compactos de modelo aceleran los tiempos de generación de respuestas para los usuarios.
- Sus sólidos resultados de razonamiento en pruebas de referencia rivalizan con los de competidores más grandes del sector.
- Las licencias flexibles se adaptan a diversas estructuras empresariales comerciales.
Modelos GPT de OpenAI
Las API propietarias ofrecen potentes bases de razonamiento. Los desarrolladores evitan gestionar clústeres de infraestructura. Las actualizaciones periódicas introducen conjuntos de funciones avanzadas. Las políticas de privacidad protegen los datos de los clientes empresariales.
- Las API administradas eliminan las tareas de mantenimiento de infraestructura para los equipos internos.
- El razonamiento avanzado resuelve problemas lógicos complejos con facilidad y sin necesidad de ajuste.
Anthropic Claude
Las ventanas de contexto largas procesan libros enteros. Las salvaguardas de seguridad minimizan los resultados tóxicos. Los clientes empresariales integran endpoints de API seguros. Los analistas financieros procesan directamente hojas de cálculo de gran tamaño.
- Las enormes ventanas de contexto admiten bases de código completas e informes densos.
- La seguridad constitucional integrada reduce los resultados dañinos o tóxicos.
- El análisis de documentos extrae datos estructurados de páginas financieras densas.
Modelos Google Gemini
Las capacidades multimodales procesan texto y video. La infraestructura en la nube integra herramientas de IA nativas. Las capacidades de búsqueda empresarial conectan las unidades internas. Las arquitecturas escalables soportan cargas de trabajo pesadas.
- La multimodalidad nativa procesa directamente imágenes y flujos de video.
- La integración con Google Cloud simplifica las canalizaciones de despliegue empresarial.
Infraestructura y pila tecnológica necesarias para el desarrollo de un LLM personalizado
Desarrollar un LLM personalizado robusto exige clústeres de cómputo de alto rendimiento equipados con GPU especializadas, canalizaciones de datos escalables, marcos de orquestación empresariales y bases de datos vectoriales seguras para la generación aumentada por recuperación.
Examinemos la arquitectura técnica esencial para impulsar con eficacia su infraestructura de IA empresarial.
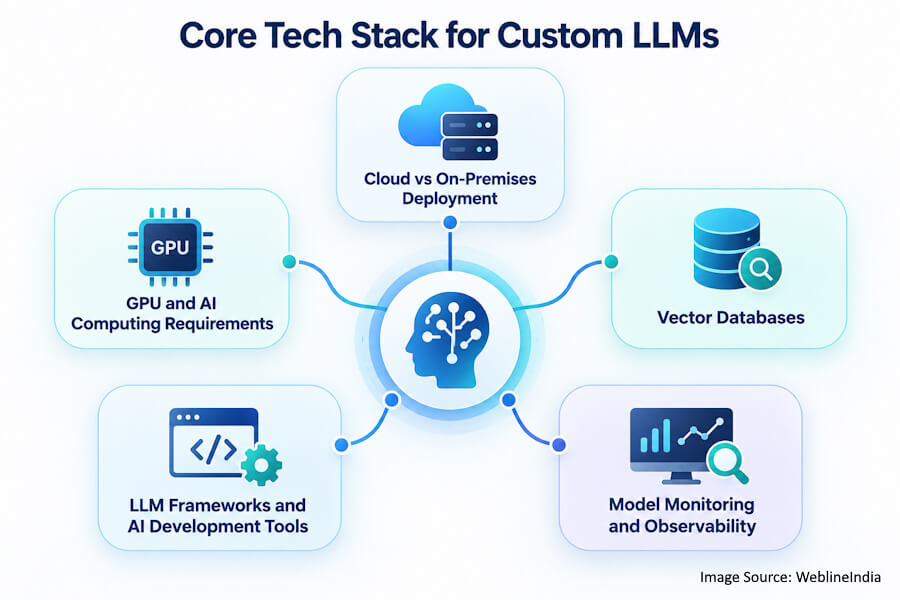
Despliegue en la nube vs. en instalaciones propias (on-premises)
Los proveedores de nube ofrecen escalado elástico de GPU. Los servidores on-premises protegen secretos de máxima confidencialidad. Las normativas financieras dictan reglas sobre la ubicación del hardware. Las arquitecturas híbridas equilibran costo y seguridad.
Requisitos de GPU y de cómputo para IA
El aprendizaje profundo exige chips aceleradores especializados. Una alta capacidad de VRAM permite cargar modelos grandes. Las velocidades de interconexión aceleran las tareas de entrenamiento distribuido. El consumo de energía condiciona los presupuestos del centro de datos.
- Los clústeres NVIDIA H100 aceleran drásticamente los tiempos de entrenamiento de los modelos.
- Las altas capacidades de VRAM cargan con seguridad enormes pesos de parámetros.
- Las interconexiones de alta velocidad enlazan varios nodos de entrenamiento sin latencia.
Bases de datos vectoriales
Los embeddings requieren soluciones de almacenamiento especializadas. Las búsquedas por similitud recuperan los fragmentos de documentos coincidentes. Las arquitecturas escalables manejan miles de millones de vectores. La velocidad de indexación afecta la latencia de las consultas.
- Pinecone gestiona con eficiencia índices de búsqueda vectorial nativos de la nube.
- Milvus escala sin problemas en clústeres de servidores locales distribuidos.
- Qdrant maneja operaciones rápidas de filtrado de metadatos durante la búsqueda.
Marcos de trabajo para LLM y herramientas de desarrollo de IA
Las bibliotecas de Python simplifican la construcción de canalizaciones. Las herramientas de orquestación encadenan pasos complejos de agentes. Los paquetes de cuantización reducen la huella de memoria de los modelos. Las herramientas de contenedorización estandarizan los entornos de despliegue.
- LangChain orquesta flujos de trabajo complejos de agentes de inteligencia artificial de varios pasos.
- LlamaIndex conecta documentos externos con los modelos para RAG.
Monitoreo de modelos y observabilidad
Las métricas hacen seguimiento de las tasas de consumo de tokens. El registro de errores expone los puntos de fallo de los prompts. La detección de deriva (drift) identifica tendencias de pérdida de precisión. Los escáneres de seguridad bloquean entradas maliciosas.
- Los paneles de Grafana muestran en tiempo real métricas de uso de los recursos del sistema.
- Las herramientas de registro capturan trazas de errores de los prompts de usuario para su análisis.
- Los monitores de deriva alertan a los ingenieros sobre caídas de rendimiento.
- Los filtros de seguridad bloquean los intentos no autorizados de inyección de prompts.
Desafíos comunes en el desarrollo de LLM personalizados y cómo superarlos
El desarrollo de LLM personalizados suele plantear obstáculos como gastos computacionales desorbitados, riesgos para la privacidad de los datos, el olvido catastrófico durante el ajuste fino y la gestión de la deriva del modelo con el tiempo.
Descubramos las estrategias de mitigación probadas que se necesitan para sortear con éxito estos obstáculos técnicos comunes.
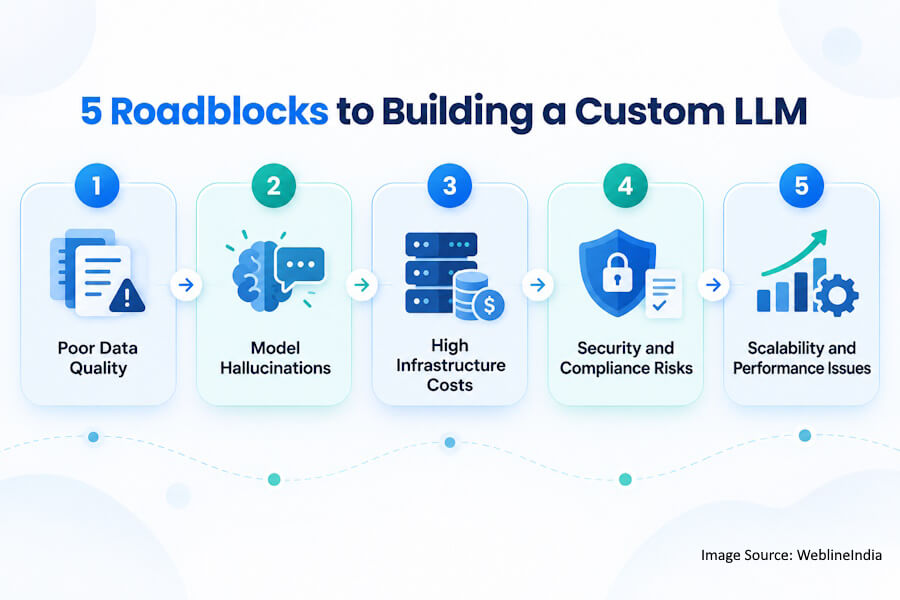
Mala calidad de los datos
Los documentos incompletos provocan un comportamiento errático del modelo. Las canalizaciones de limpieza de datos eliminan el ruido. Los scripts de validación automatizados comprueban los formatos de texto. Los auditores humanos verifican la integridad del conjunto de datos.
- Las secciones faltantes de los documentos generan vacíos de razonamiento lógico durante el entrenamiento.
- Los scripts automatizados de expresiones regulares eliminan de los archivos los caracteres de texto dañados.
Alucinaciones del modelo
Los modelos inventan hechos históricos falsos. Las arquitecturas RAG fundamentan las respuestas en la verdad. Los ajustes estrictos de temperatura reducen las invenciones creativas. Los conjuntos de evaluación detectan los errores a tiempo.
- Los prompts de anclaje restringen las respuestas estrictamente a los documentos fuente proporcionados.
- Los ajustes de temperatura baja disminuyen la tasa de generación aleatoria de resultados.
- Los requisitos de citación obligan a los modelos a hacer referencia a las fuentes documentales.
Altos costos de infraestructura
El alquiler de GPU drena los presupuestos corporativos. La cuantización de modelos reduce la huella de memoria. Los modelos más pequeños sustituyen a los enormes sistemas fundacionales. El procesamiento por lotes eficiente maximiza el aprovechamiento del hardware.
- La cuantización de modelos reduce a la mitad el tamaño de los archivos sin pérdida de calidad.
- Las instancias de GPU Spot reducen de forma significativa las facturas de alquiler de cómputo en la nube.
- El procesamiento de solicitudes por lotes maximiza la utilización de la capacidad de cómputo activa del hardware.
Riesgos de seguridad y cumplimiento
Las filtraciones de datos desencadenan multas regulatorias. Los protocolos de cifrado protegen los archivos almacenados. Las listas de control de acceso restringen los permisos de los usuarios. Las auditorías periódicas verifican la integridad del sistema.
- Los estándares de cifrado protegen los archivos durante las transferencias en la red interna.
- El acceso basado en roles limita la visibilidad de los documentos sensibles entre departamentos.
- Las auditorías de cumplimiento verifican la adhesión a los marcos regulatorios del sector.
- Las pruebas de penetración descubren vulnerabilidades de seguridad ocultas en las aplicaciones.
Problemas de escalabilidad y rendimiento
El alto tráfico de usuarios provoca cuellos de botella en los servidores. Los balanceadores de carga distribuyen las cargas de solicitudes entrantes. Las capas de caché almacenan los resultados de las consultas frecuentes. Las colas asíncronas gestionan las cargas de trabajo pesadas.
- Los balanceadores de carga evitan las caídas por sobrecarga de un solo servidor durante los picos de tráfico.
- El almacenamiento en caché de respuestas atiende consultas idénticas al instante, sin necesidad de inferencia.
¿Cuánto cuesta crear un LLM personalizado para su empresa?
Construir un LLM empresarial personalizado implica compromisos financieros variables, que van desde configuraciones básicas de API hasta canalizaciones de entrenamiento que consumen muchos recursos. Las organizaciones deben tener en cuenta la carga de cómputo de GPU, las canalizaciones de preparación de datos, el talento de ingeniería especializado y los costos de mantenimiento a largo plazo.
Desglosemos las variables financieras reales y las estimaciones presupuestarias para ayudarle a planificar una estrategia de inversión precisa para su próximo proyecto de inteligencia artificial empresarial.
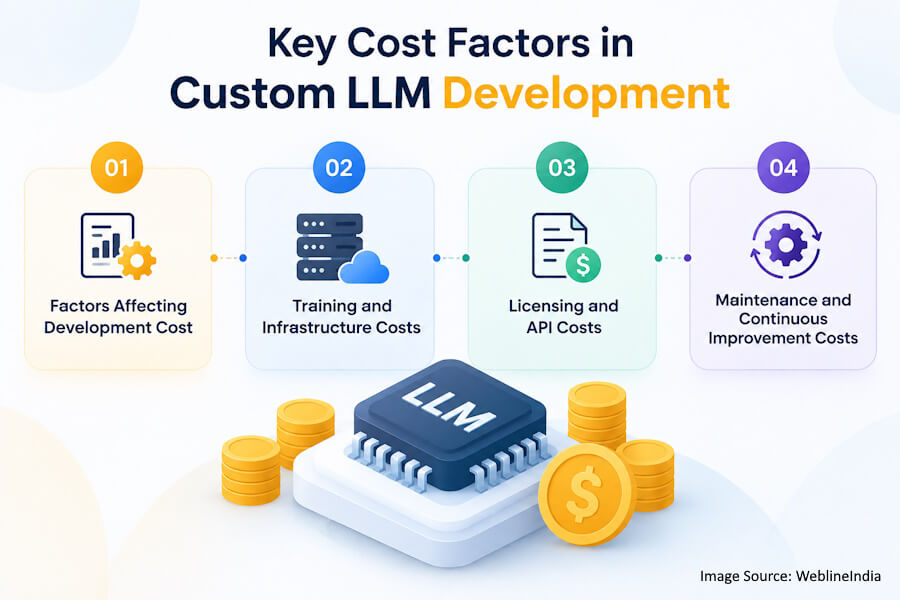
Factores que afectan el costo de desarrollo
El tamaño del conjunto de datos influye en la mano de obra de preparación de datos, mientras que el número de parámetros del modelo determina las necesidades de hardware. Los servicios de consultoría en IA pueden ayudar a las organizaciones a evaluar la complejidad de la integración, los requisitos de infraestructura y otros factores que influyen en el alcance del proyecto.
- Los conjuntos de datos grandes exigen un tiempo extenso de limpieza manual por parte de los ingenieros.
- Los modelos con muchos parámetros demandan hardware de GPU de gama alta, que resulta costoso.
Costos de entrenamiento e infraestructura
Los clústeres de cómputo requieren una financiación sustancial. Las facturas de electricidad añaden gastos operativos continuos. Los proveedores de nube cobran tarifas de GPU por hora. La compra de hardware requiere capital inicial.
- El alquiler de GPU por hora en la nube se acumula rápidamente durante las ejecuciones de entrenamiento.
- La carga de energía y refrigeración incrementa los presupuestos de instalaciones para los servidores.
- La puesta en marcha del clúster requiere costosos equipos de red de alta velocidad.
- Los contratos de mantenimiento cubren fallos inesperados de componentes de hardware de los servidores.
Costos de licencias y de API
Los modelos fundacionales propietarios cobran cuotas de suscripción. Los permisos de uso comercial implican cargos adicionales. Los pesos de código abierto eliminan las facturas recurrentes de licencias. Las revisiones legales garantizan el cumplimiento.
- Los tokens de API comerciales acumulan cargos mensuales según el volumen.
- Las suscripciones a modelos propietarios escalan con el número de usuarios activos.
- Los pesos de código abierto evitan la carga de tarifas recurrentes de licencias de software.
Costos de mantenimiento y mejora continua
Los modelos requieren ciclos continuos de reentrenamiento. Los equipos de ingeniería corrigen errores operativos. Los parches de seguridad protegen los servidores de infraestructura. Las herramientas de monitoreo conllevan cuotas de suscripción.
- Las canalizaciones de reentrenamiento incorporan con regularidad los documentos corporativos recién actualizados.
- Los ingenieros de soporte investigan a diario registros de errores inesperados en producción.
- Los equipos de seguridad aplican parches de software a los servidores empresariales.
- Las herramientas de observabilidad cobran tarifas según el volumen de datos de registro.
Obtenga una estimación realista de un LLM personalizado en función de su caso de uso, sus datos, la elección del modelo, las integraciones, la infraestructura y los requisitos de despliegue.
Mejores prácticas para crear LLM empresariales seguros, precisos y escalables
Implementar LLM empresariales robustos exige aplicar un cifrado de datos estricto, establecer ciclos de retroalimentación continuos para minimizar las alucinaciones y diseñar arquitecturas de escalado horizontal que soporten las cargas de trabajo pico.
Exploremos las estrategias de despliegue fundamentales que garantizan que su ecosistema de IA se mantenga protegido, altamente preciso e infinitamente adaptable al crecimiento futuro de la organización.
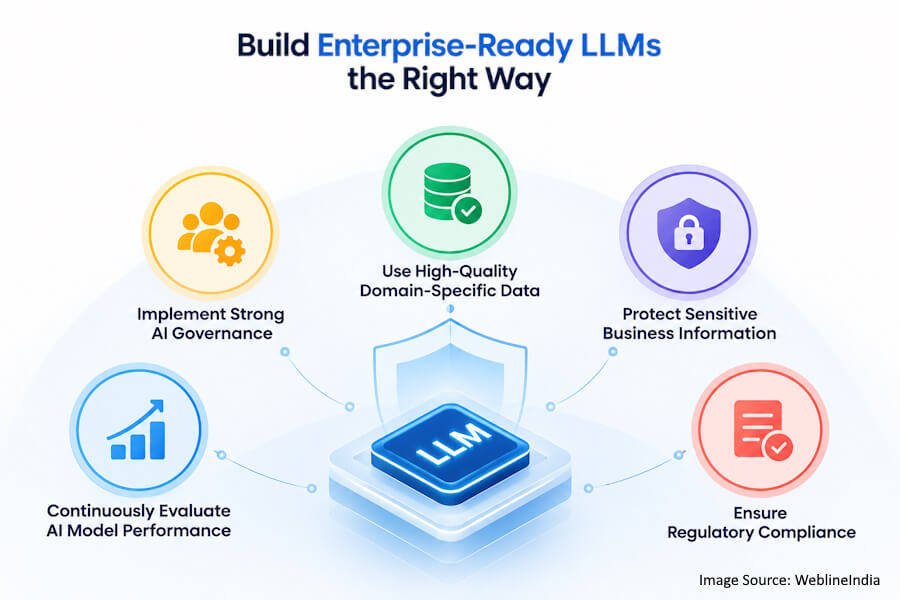
Implementar un sólido gobierno de IA
Los comités supervisan los proyectos de inteligencia artificial. Las directrices éticas previenen los resultados sesgados. El control de versiones registra las actualizaciones del modelo. La documentación deja constancia de las decisiones de arquitectura.
Utilizar datos de alta calidad específicos del dominio
Los conjuntos de datos seleccionados mejoran la precisión de los resultados. La eliminación de ruido suprime el texto confuso. Los formatos estandarizados agilizan las canalizaciones de entrenamiento. Las auditorías periódicas mantienen la salud de los datos.
- Los conjuntos de datos seleccionados aportan a los modelos señales de aprendizaje semántico claras.
- La reducción de ruido filtra por completo el texto irrelevante de internet.
- Los esquemas estandarizados organizan adecuadamente los documentos corporativos de múltiples fuentes.
Proteger la información empresarial sensible
El enmascaramiento de datos oculta cifras confidenciales. Los servidores locales aíslan los archivos propietarios. Las políticas de cero retención protegen la privacidad de los usuarios. Los firewalls de red bloquean las amenazas externas.
- El enmascaramiento de datos reemplaza los nombres reales por marcadores de posición seguros.
- Los despliegues en servidores locales aíslan los archivos de las redes públicas.
- Los acuerdos de cero retención de datos protegen estrictamente la privacidad de los prompts corporativos.
- Los firewalls de red bloquean los intentos de intrusión externa no autorizados.
Evaluar continuamente el rendimiento del modelo de IA
Las pruebas de referencia automatizadas miden las tendencias de precisión. Los comentarios de los usuarios señalan problemas operativos. El red teaming descubre vulnerabilidades ocultas. Las revisiones periódicas actualizan los objetivos de rendimiento.
- Los scripts de pruebas automatizadas siguen a lo largo del tiempo las tendencias de las métricas de precisión.
- Los botones de valoración para usuarios capturan al instante comentarios sobre el rendimiento en el mundo real.
Garantizar el cumplimiento normativo
Los equipos legales revisan las prácticas de manejo de datos. Las directrices del RGPD (GDPR) protegen la privacidad de los clientes. Los estándares del sector dictan los controles de seguridad. La documentación demuestra el cumplimiento de la normativa.
- Las revisiones legales garantizan el cumplimiento de estrictas leyes de privacidad de datos.
- Los protocolos del RGPD (GDPR) gestionan el consentimiento de los usuarios y las solicitudes de eliminación de datos.
- Los estándares del sector exigen longitudes específicas para las claves de cifrado.
Casos de uso empresariales reales del desarrollo de LLM personalizados en distintos sectores
Los LLM personalizados transforman las industrias al automatizar el análisis de documentos jurídicos complejos en el sector financiero, impulsar sugerencias de diagnóstico hiperpersonalizadas en el ámbito de la salud y dirigir una logística de inventario hiperfocalizada en el comercio minorista. Descubra cómo las organizaciones de diversos sectores aprovechan estos sistemas a medida para optimizar flujos de trabajo, recortar drásticamente los costos generales y asegurar una enorme ventaja competitiva.
Salud
Los modelos clínicos resumen los historiales de los pacientes. Los investigadores médicos analizan estudios de interacciones entre medicamentos. Los asistentes de diagnóstico procesan notas de estudios de imagen. Los flujos de trabajo administrativos agilizan la facturación.
- Los modelos clínicos resumen para los médicos historiales médicos densos de los pacientes.
- Las herramientas de investigación analizan con rapidez estudios complejos de interacciones entre medicamentos.
Banca y servicios financieros
Los algoritmos de detección de fraude analizan flujos de transacciones. Los operadores algorítmicos procesan informes de mercado. Los sistemas de cumplimiento revisan solicitudes de préstamos. Los agentes automatizados responden consultas sobre las cuentas.
- Los algoritmos de detección de fraude señalan al instante flujos de transacciones sospechosas.
- Los modelos financieros analizan informes de resultados para inversionistas corporativos.
- Las herramientas de cumplimiento revisan a fondo los factores de riesgo de las solicitudes de préstamo.
- Los asistentes automatizados responden las consultas rutinarias de los clientes sobre sus cuentas las 24 horas, los 7 días de la semana.
Legal
Los analizadores de contratos detectan cláusulas desfavorables. Los motores de búsqueda de jurisprudencia recuperan precedentes. Los resumidores de documentos revisan declaraciones. Las canalizaciones de debida diligencia procesan fusiones.
- Los analizadores de contratos destacan al instante cláusulas de responsabilidad desfavorables.
- Los motores de búsqueda jurídicos recuperan precedentes históricos relevantes.
Manufactura
Los modelos de cadena de suministro predicen escasez de materiales. Los registros de mantenimiento programan reparaciones de máquinas. Los sistemas de control de calidad analizan informes de defectos. Los asistentes de diseño revisan planos.
- Los modelos de cadena de suministro predicen de forma anticipada los riesgos de escasez de materia prima.
- Los registros de mantenimiento programan reparaciones preventivas de la maquinaria de la fábrica.
- Los sistemas de control de calidad analizan informes de defectos de ensamblaje.
- Los asistentes de diseño revisan planos técnicos de ingeniería complejos.
Comercio minorista y eCommerce
Los motores de recomendación sugieren productos relevantes. Los modelos de inventario pronostican la demanda estacional. Los chatbots multilingües asisten a compradores de todo el mundo. Los analizadores de sentimiento revisan los comentarios.
- Los motores de recomendación sugieren productos relevantes a los compradores en línea.
- Los modelos de inventario pronostican con precisión la demanda estacional de existencias.
Atención al cliente
Los sistemas de tickets enrutan las incidencias automáticamente. Los rastreadores de sentimiento priorizan a los clientes molestos. Las bases de conocimiento generan respuestas instantáneas. Los asistentes de respuesta redactan réplicas corteses.
- Los sistemas de tickets enrutan las incidencias de los clientes a los agentes adecuados.
- Los rastreadores de sentimiento priorizan las colas de soporte de clientes molestos.
- Las bases de conocimiento generan respuestas instantáneas para los usuarios.
- Los asistentes de respuesta redactan respuestas corteses por correo electrónico a los clientes.
Cómo elegir la empresa de desarrollo de LLM personalizados adecuada para su negocio
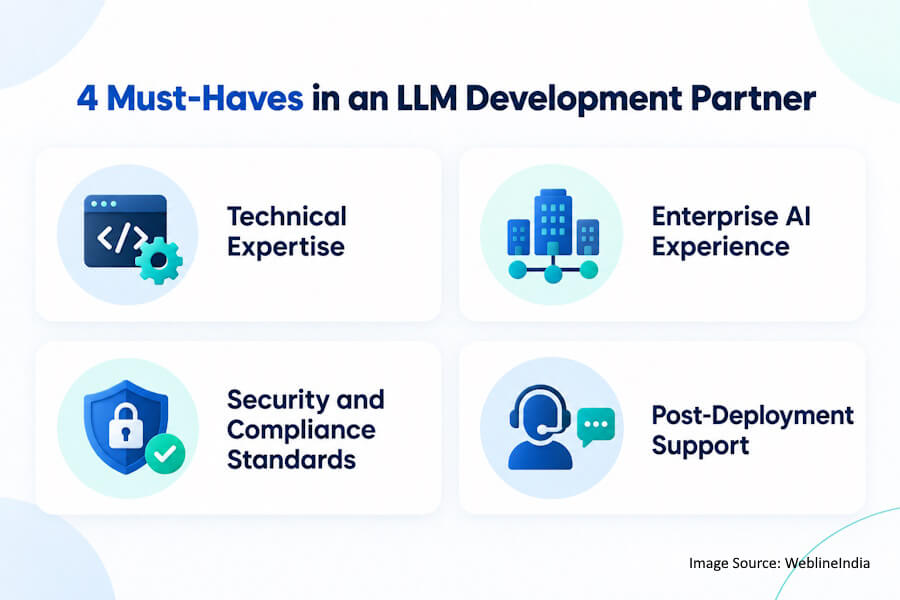
Evaluar a posibles socios de desarrollo de LLM personalizados requiere analizar su portafolio de modelos empresariales desplegados, su experiencia técnica en marcos de ajuste fino, sus protocolos de seguridad de datos y sus capacidades de mantenimiento posteriores al lanzamiento.
Aquí analizamos los criterios de evaluación fundamentales para seleccionar a un proveedor tecnológico confiable que pueda convertir con éxito su ambiciosa visión de inteligencia artificial en una realidad empresarial segura y lista para producción.
Experiencia técnica
Los ingenieros evalúan las credenciales en aprendizaje profundo. Los equipos demuestran despliegues de modelos exitosos. Las certificaciones acreditan la pericia en infraestructura en la nube. Los portafolios destacan soluciones empresariales complejas.
Experiencia en IA empresarial
Los proveedores comprenden los requisitos de seguridad corporativa. Los casos de estudio demuestran conocimiento específico del sector. Las referencias de clientes validan el desempeño previo. Las capacidades de escala se ajustan a las necesidades del negocio.
- Los proveedores comprenden los estrictos requisitos de seguridad y cumplimiento corporativos.
- Los casos de estudio demuestran un profundo conocimiento operativo específico del sector.
Estándares de seguridad y cumplimiento
Los socios aplican reglas estrictas de privacidad de datos. Las certificaciones verifican la seguridad de la infraestructura. Los acuerdos legales protegen la propiedad intelectual. Las pistas de auditoría garantizan el cumplimiento normativo.
- Los socios de desarrollo aplican estrictas reglas internas de privacidad de datos.
- Las certificaciones de seguridad verifican una sólida protección de la infraestructura en la nube.
- Los contratos legales protegen la propiedad intelectual corporativa propietaria.
- Las pistas de auditoría garantizan el pleno cumplimiento de la normativa del sector.
Soporte posterior al despliegue
Los contratos de mantenimiento garantizan la disponibilidad del sistema. Los servicios de monitoreo hacen seguimiento de las métricas de rendimiento. Las actualizaciones periódicas mantienen los modelos al día. Los equipos de soporte dedicados resuelven los errores.
- Los acuerdos de mantenimiento garantizan una alta disponibilidad de la aplicación.
- Los servicios de monitoreo siguen en vivo las métricas de precisión del rendimiento.
Tendencias futuras en el desarrollo de LLM personalizados y la IA empresarial
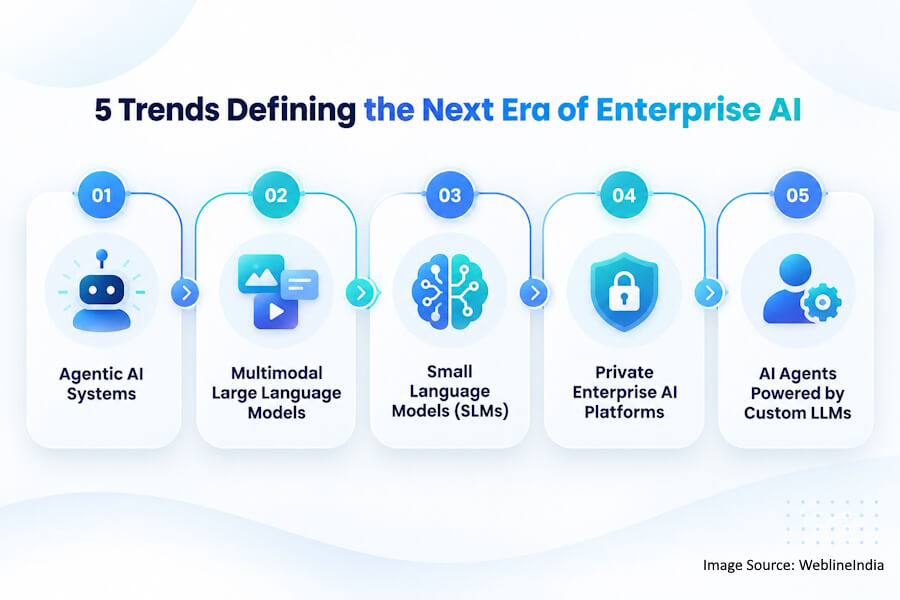
El panorama de la IA empresarial avanza con rapidez hacia la computación en el borde (edge) hiperefiente, las capacidades multimodales y los flujos de trabajo agénticos autónomos que ejecutan procesos de negocio complejos y de varios pasos sin intervención humana.
Ahora descubrimos los próximos avances tecnológicos e innovaciones estratégicas llamados a redefinir la forma en que su empresa aprovechará los modelos de lenguaje de gran tamaño personalizados en los próximos años.
Sistemas de IA agéntica
Los agentes autónomos ejecutan flujos de trabajo de varios pasos. Los sistemas colaboran para resolver problemas. Los motores de decisión gestionan tareas complejas. La productividad aumenta en todos los departamentos.
Modelos de lenguaje de gran tamaño multimodales
Los modelos procesan texto, audio y video. Los sensores integrados analizan entornos físicos. Las entradas enriquecidas mejoran la comprensión contextual. Las aplicaciones abarcan múltiples tipos sensoriales.
- Los modelos procesan simultáneamente flujos de texto, audio y video.
- Los sensores integrados analizan los entornos físicos de trabajo en las fábricas.
- Los flujos de entrada enriquecidos mejoran la comprensión contextual profunda.
- Las aplicaciones abarcan sin fisuras múltiples tipos de datos sensoriales.
Modelos de lenguaje pequeños (SLM)
Los modelos compactos se ejecutan en dispositivos de borde. El hardware local procesa las consultas al instante. Las demandas de recursos disminuyen de forma significativa. La privacidad mejora gracias a la ejecución local.
- Los modelos compactos se ejecutan localmente en dispositivos de borde.
- El hardware local procesa al instante las consultas de los usuarios.
Plataformas de IA empresarial privadas
Las plataformas seguras centralizan las herramientas de inteligencia artificial. Los mercados internos comparten modelos entrenados. Los paneles de gobernanza monitorean el uso del sistema. Las empresas controlan su propio destino en materia de IA.
- Las plataformas seguras centralizan las herramientas corporativas de inteligencia artificial.
- Los mercados internos comparten pesos de modelos entrenados a medida.
- Los paneles de gobernanza monitorean el uso del sistema en toda la empresa.
- Las empresas controlan por completo su infraestructura de inteligencia artificial.
Agentes de IA impulsados por LLM personalizados
El desarrollo de agentes de IA empresariales puede combinar agentes especializados con LLM personalizados para ejecutar operaciones de negocio y coordinar flujos de trabajo de software. Los asistentes inteligentes gestionan las agendas diarias. Las mejoras de eficiencia transforman los flujos de trabajo empresariales.
- Los agentes especializados ejecutan automáticamente operaciones de negocio complejas.
- Las herramientas automatizadas coordinan las canalizaciones de despliegue del desarrollo de software.
Reflexiones finales sobre la creación de un LLM personalizado para el éxito empresarial a largo plazo
La adopción de la inteligencia artificial determina a los futuros líderes del mercado. Las herramientas públicas genéricas no satisfacen las exigencias empresariales. Las organizaciones crean modelos personalizados para proteger sus datos. Los flujos de trabajo propietarios exigen inteligencia especializada. El éxito a largo plazo requiere una infraestructura de IA sólida. Las empresas se asocian con proveedores expertos para acelerar la ejecución.
WeblineIndia ofrece servicios de desarrollo de LLM personalizados de excelencia. Los equipos de ingeniería crean LLM empresariales seguros. Los especialistas ajustan los modelos para lograr la máxima precisión. WeblineIndia transforma las operaciones empresariales mediante soluciones de IA personalizadas. Las organizaciones logran hoy ventajas competitivas sostenidas. Contacte a WeblineIndia para iniciar una integración de inteligencia artificial personalizada.
Hashtags para redes sociales
#LLMPersonalizado #ModelosDeLenguajeExtensos #IAEmpresarial #IAGenerativa #InteligenciaArtificial #LLM #DesarrolloDeIA #IngenieríaDeIA #IAAgéntica #AgentesDeIA #GeneraciónAumentadaPorRecuperación #RAG #AprendizajeAutomático #InfraestructuraDeIA #TransformaciónDigital #TecnologíaEmpresarial #MLOps #InnovaciónEnIA #IAPrivada #AutomatizaciónEmpresarial
Cree un LLM personalizado, seguro y escalable, adaptado a los datos y flujos de trabajo de su empresa, con un equipo experimentado de desarrollo de IA.
Preguntas frecuentes
¿Cómo puedo crear un LLM personalizado para mi empresa?
Las empresas recopilan datos propios, seleccionan arquitecturas de código abierto potentes, ajustan los pesos del modelo en servidores seguros y despliegan infraestructura escalable para automatizar flujos de trabajo internos y proteger activos de propiedad intelectual confidenciales.
¿Debería crear un LLM desde cero o ajustar uno existente?
El ajuste fino (*fine-tuning*) de modelos base existentes ahorra tiempo y dinero, al tiempo que adapta la gramática preentrenada a dominios específicos. El entrenamiento desde cero solo es necesario cuando existen requisitos lingüísticos o de seguridad totalmente únicos.
¿Qué datos se necesitan para entrenar un modelo de lenguaje personalizado?
Los ingenieros recopilan documentos internos limpios, manuales técnicos, transcripciones históricas y registros de bases de datos estructurados. Los equipos deben eliminar identificadores personales y formatear el texto cuidadosamente antes de introducirlo en los procesos de entrenamiento.
¿Cuánto cuesta desarrollar un LLM personalizado?
Los gastos varían según el número de parámetros, el alquiler de hardware y la mano de obra dedicada a la preparación de datos. Los clústeres de GPU en la nube requieren una inversión significativa, mientras que el ajuste de adaptadores existentes reduce el presupuesto total de implementación.
¿Qué LLM de código abierto es el mejor para las empresas?
Meta Llama y Mistral AI ofrecen un rendimiento excepcional y pesos abiertos para despliegues locales seguros. Las organizaciones eligen variantes específicas en función de los límites de parámetros y los recursos informáticos disponibles.
¿Cuánto tiempo lleva crear un LLM personalizado?
Los plazos oscilan entre varias semanas y varios meses, dependiendo de la complejidad del conjunto de datos. Los despliegues por fases y el uso de modelos base preentrenados aceleran los cronogramas de implementación inicial para los equipos corporativos.
¿Pueden las empresas crear modelos de IA privados?
Las empresas despliegan modelos en hardware de servidor local o en subredes seguras de nube privada. Esto garantiza un aislamiento total de los datos e impide que proveedores externos de API accedan a registros corporativos confidenciales.
¿Qué infraestructura se necesita para desarrollar un LLM?
El aprendizaje profundo (*deep learning*) requiere clústeres de GPU de alto rendimiento, hardware de red robusto y bases de datos vectoriales rápidas. Los ingenieros de DevOps configuran nodos de Kubernetes escalables para gestionar la alta demanda de tráfico de inferencia.
¿Cómo despliegan las empresas los LLM personalizados?
Los equipos de DevOps aprovisionan instancias de inferencia en la nube o nodos de servidor locales. Las puertas de enlace API conectan las aplicaciones empresariales internas, mientras que los equilibradores de carga distribuyen el tráfico de solicitudes entrantes de manera eficiente entre los servidores.
¿Cuáles son las ventajas de los LLM privados?
Los modelos privados garantizan una estricta privacidad de los datos, eliminan las tarifas de suscripción por token y ofrecen respuestas precisas y específicas para el sector. Las organizaciones mantienen un control absoluto sobre los pesos del modelo y las políticas de seguridad del sistema.
¿Qué es RAG y cómo se compara con el ajuste fino (*fine-tuning*)?
La generación aumentada por recuperación (RAG) obtiene documentos externos en tiempo real y de forma dinámica, sin alterar los pesos fundamentales del modelo. El ajuste fino (*fine-tuning*), en cambio, modifica directamente los parámetros de la red neuronal para adaptar el vocabulario y el comportamiento a los flujos de trabajo empresariales especializados.
¿Qué tan seguros son los LLM empresariales?
Las plataformas empresariales implementan controles de acceso estrictos basados en roles, cifrado de datos en reposo y políticas de no retención de información. Las auditorías de seguridad y los cortafuegos locales protegen la información confidencial frente a amenazas cibernéticas maliciosas.
Reconocido mundialmente por su calidad y fiabilidad inigualables


Testimonios: Escúchalo directamente de nuestros clientes globales
Nuestros procesos de desarrollo ofrecen soluciones dinámicas para afrontar retos empresariales, optimizar costos e impulsar la transformación digital. Soluciones respaldadas por expertos mejoran la retención de clientes y la presencia en línea, y casos de éxito comprobados muestran la resolución de problemas reales mediante aplicaciones innovadoras. Nuestros estimados clientes en todo el mundo ya lo han experimentado.
Premios y Reconocimientos
Aunque los clientes satisfechos son nuestra mayor motivación, el reconocimiento de la industria tiene un valor significativo. WeblineIndia ha liderado constantemente en tecnología, con premios y galardones que reafirman nuestra excelencia.
OA500 Empresas globales de externalización 2025, por Outsource Accelerator
Mejor empresa de desarrollo de software, por GoodFirms
Mejor empresa de soluciones de producto fintech – 2022, por GESIA
Premiada como – Mejor empresa de desarrollo de apps en India 2020, por SoftwareSuggest